Ricerca
DPA-MoE: un framework per il controllo della precisione a runtime nell’inferenza dei modelli MoE
I modelli Mixture-of-Experts (MoE) riducono il calcolo instradando ogni token verso un piccolo gruppo di esperti, ma ciascun esperto selezionato viene comunque utilizzato a una precisione fissa. Prese
- arXiv
- 2610.21378
- Pubblicato
- 2026-10-15
- Autori
- Jaeyun Kim, Hoonki Lee, Susie Shin, Hyunmin Kim, Dahyun Lee, Sangyeob Kim
Abstract degli autori
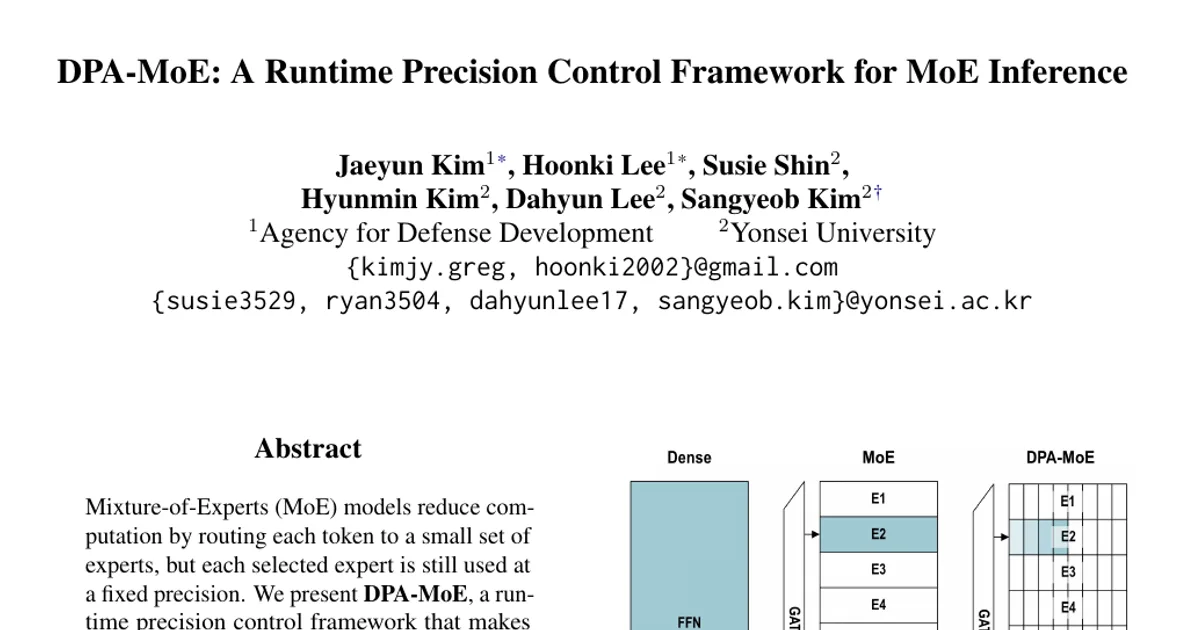
I modelli Mixture-of-Experts (MoE) riducono il calcolo instradando ogni token verso un piccolo gruppo di esperti, ma ciascun esperto selezionato viene comunque utilizzato a una precisione fissa. Presentiamo DPA-MoE, un framework per il controllo della precisione a runtime che consente di utilizzare gli esperti selezionati a qualsiasi precisione. DPA-MoE codifica i pesi feed-forward degli esperti in blocchi decodificabili per prefisso mediante SharedScale AnyBCQ, misura offline i residui di ricostruzione per ciascun esperto e assegna i blocchi durante l’inferenza in base ai punteggi di gating del router rilevati in tempo reale. Questa allocazione successiva all’instradamento consente a un unico checkpoint MoE codificato di operare con diversi budget effettivi per i pesi, senza ripetere l’addestramento o la codifica. Esperimenti su Qwen3-30B-A3B e DeepSeekMoE-16B mostrano che DPA-MoE riduce la divergenza KL e migliora l’accuratezza nei compiti a valle rispetto a un’allocazione uniforme dei blocchi, a parità di budget, con un modesto overhead sul throughput a regime nel nostro prototipo.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv