Ricerca
DoubtLess: decodifica contrastiva senza addestramento per un ragionamento efficiente
I modelli di ragionamento ottengono risultati elevati grazie a lunghe catene di pensiero (CoT), ma spesso impiegano più token del necessario per risolvere un problema. I metodi esistenti per accorciar
- arXiv
- 2610.18862
- Pubblicato
- 2026-10-13
- Autori
- Minghao Luo, Liang Chen
Abstract degli autori
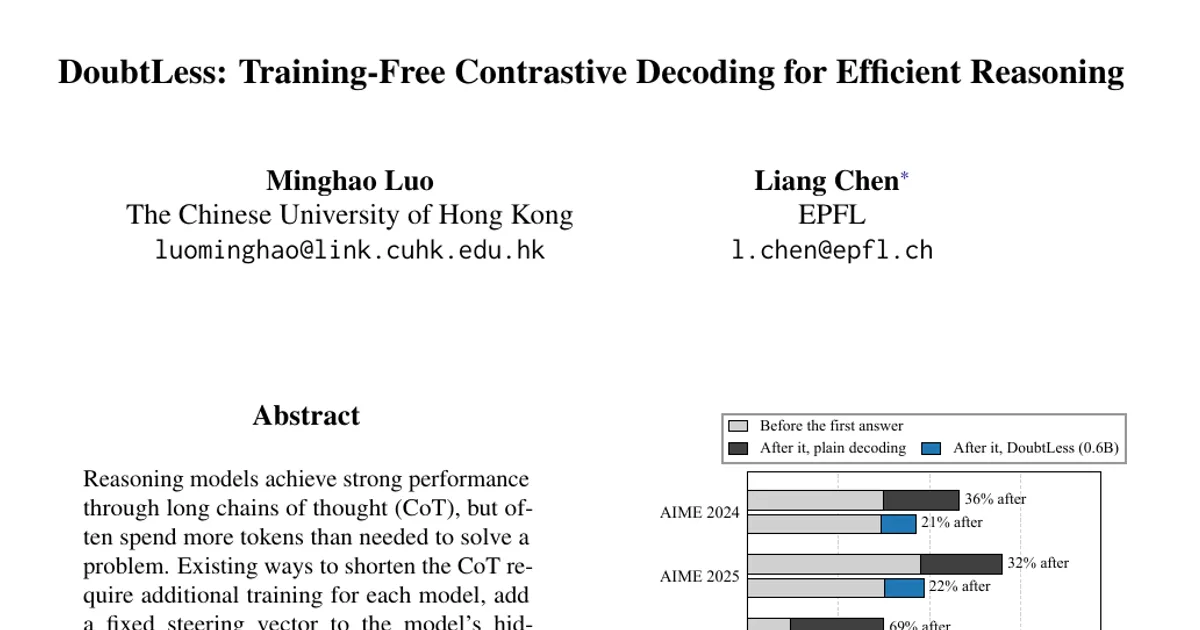
I modelli di ragionamento ottengono risultati elevati grazie a lunghe catene di pensiero (CoT), ma spesso impiegano più token del necessario per risolvere un problema. I metodi esistenti per accorciare la CoT richiedono un addestramento aggiuntivo per ciascun modello, aggiungono un vettore fisso di orientamento agli stati nascosti del modello oppure usano euristiche di decodifica, come fermarsi in anticipo o vietare parole come «aspetta», che possono ridurre l’accuratezza. Proponiamo DoubtLess, un metodo di decodifica che non richiede addestramento e in cui un modello di ragionamento molto più piccolo orienta quello grande verso la concisione. Il modello piccolo legge due volte la CoT prodotta fino a quel momento dal modello grande: una volta con l’istruzione di essere conciso (il ragionatore conciso) e una volta con l’istruzione di essere prolisso (il ragionatore prolisso). A ogni passaggio della CoT, la differenza tra i due vettori di logit del modello piccolo, moltiplicata per un fattore di intensità, viene aggiunta ai logit del modello grande. Su sette benchmark di matematica da competizione, scienze di livello post-laurea e programmazione competitiva, DoubtLess accorcia del 31% la CoT di Qwen3-32B senza modificare l’accuratezza, superando cinque metodi di riferimento applicati durante l’inferenza. Mostriamo inoltre che DoubtLess riduce del 20% i token di ragionamento per turno in un agente di programmazione che esegue autonomamente il debug, senza modificare le prestazioni nei compiti. Il metodo si estende anche a due altre famiglie di modelli senza modificare l’accuratezza. Combinato con una compressione basata sull’addestramento, accorcia ulteriormente la CoT di un modello già addestrato alla concisione. Esperimenti di ablazione e analisi del comportamento mostrano che DoubtLess riduce le verifiche ripetute: la maggior parte dei token risparmiati viene dopo la prima comparsa della risposta corretta nella CoT. Il nostro codice è disponibile all’indirizzo https://github.com/leoluolol/DoubtLess.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv