Ricerca
DICS: esplorare la coerenza intrinseca dei dati per la selezione delle istruzioni visive
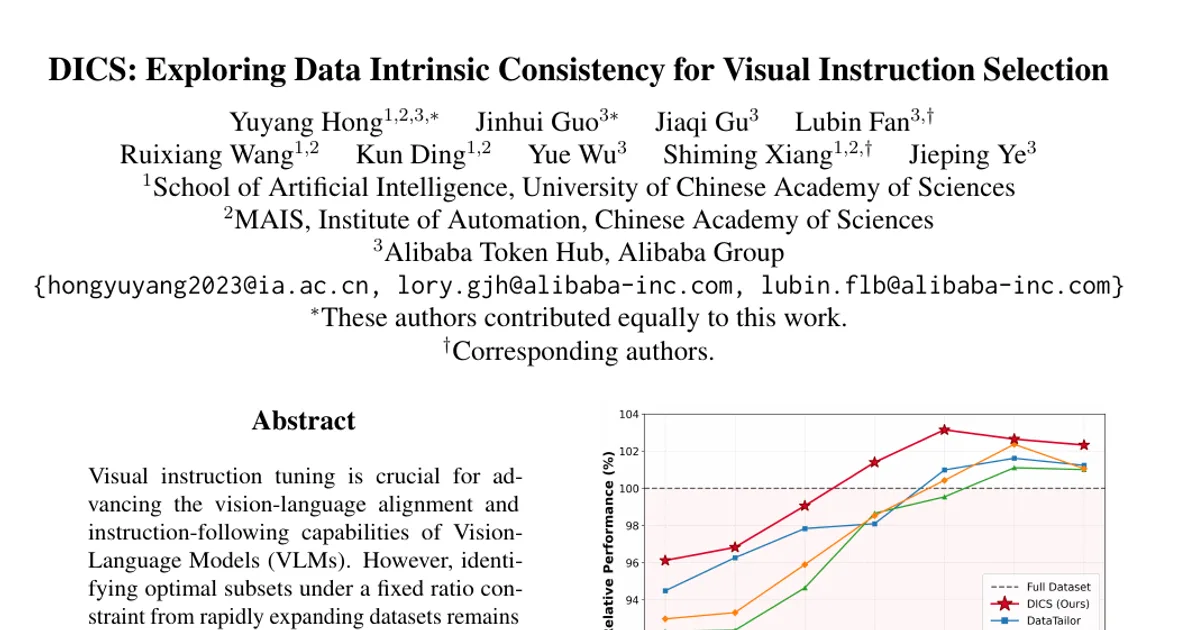
Il fine-tuning con istruzioni visive è fondamentale per migliorare l’allineamento tra visione e linguaggio e la capacità di seguire istruzioni dei modelli visione-linguaggio (VLM). Tuttavia, individua
- arXiv
- 2608.30209
- Pubblicato
- 2026-08-31
- Autori
- Yuyang Hong, Jinhui Guo, Jiaqi Gu, Lubin Fan, Ruixiang Wang, Kun Ding, Yue Wu, Shiming Xiang, Jieping Ye
Abstract degli autori
Il fine-tuning con istruzioni visive è fondamentale per migliorare l’allineamento tra visione e linguaggio e la capacità di seguire istruzioni dei modelli visione-linguaggio (VLM). Tuttavia, individuare i sottoinsiemi ottimali in dataset in rapida espansione, rispettando un vincolo di proporzione fissa, resta un ostacolo significativo. I metodi esistenti si basano in gran parte sulla diversità della distribuzione o su filtri euristici, ma spesso trascurano la coerenza interna dei singoli campioni. Per colmare questa lacuna, proponiamo Data Intrinsic Consistency (DIC), una metrica di autovalutazione progettata per quantificare la coerenza tra le componenti di ciascun campione. DIC comprende due moduli: Visual Information Consistency (VIC), che valuta l’allineamento tra contenuto visivo e istruzioni, e Response Information Consistency (RIC), che valuta la coerenza della risposta rispetto all’istruzione. Sulla base di DIC, introduciamo Data Intrinsic Consistency Selection (DICS), un metodo adattivo di selezione dei dati che ottimizza il compromesso tra un’elevata coerenza interna ai campioni e la diversità della distribuzione complessiva, al variare della quantità di dati disponibile. Esperimenti approfonditi dimostrano che DICS supera sistematicamente i metodi più avanzati su dataset di diverse dimensioni e con differenti architetture di modello, ottenendo risultati migliori del fine-tuning sull’intero dataset pur utilizzando solo il 25% dei dati di LLaVA-1.5-665K. Abbiamo inoltre realizzato DICS-6M, un corpus di istruzioni multimodali composto da 6M di campioni, che consente il più ampio studio finora condotto sulla selezione delle istruzioni visive. DICS raggiunge il 94,52\% delle prestazioni ufficiali di InternVL3-8B-Instruct utilizzando meno del 25\% dei dati di addestramento dichiarati per quel modello. Il codice è disponibile all’indirizzo https://github.com/cqu-student/DICS
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv