Ricerca
DeltaTTG: addestrare agenti multi-turno con un indicatore di avanzamento Token-to-Go
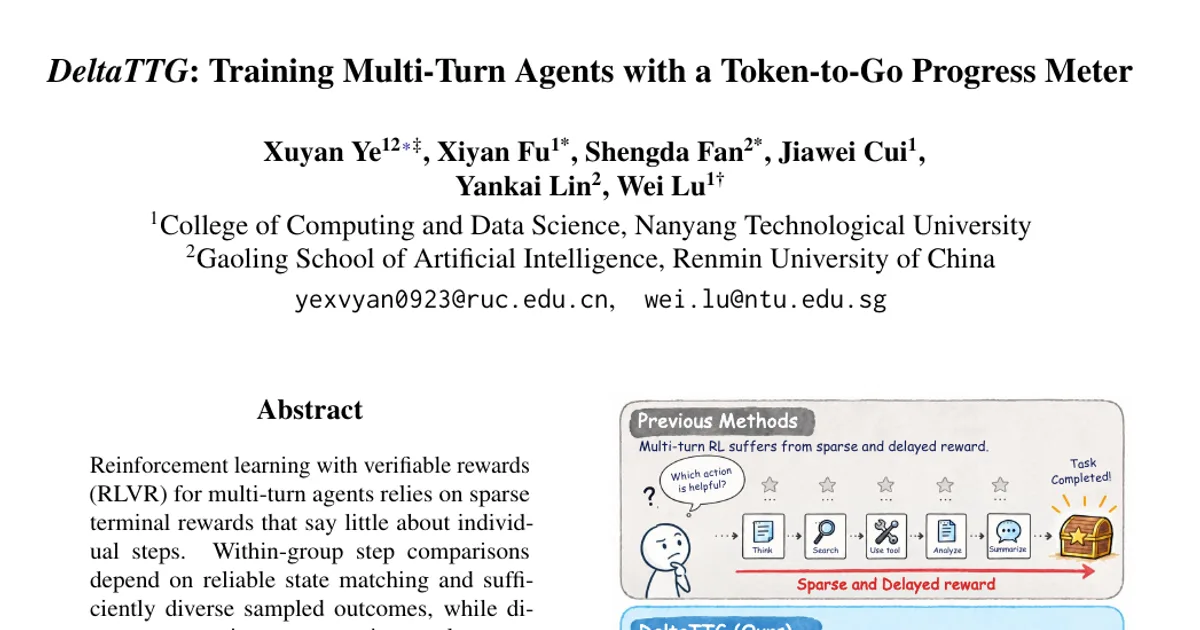
L’apprendimento per rinforzo con ricompense verificabili (RLVR) per gli agenti multi-turno si basa su ricompense terminali sparse, che dicono poco sui singoli passaggi. Il confronto tra passaggi all’i
- arXiv
- 2610.17666
- Pubblicato
- 2026-10-13
- Autori
- Xuyan Ye, Xiyan Fu, Shengda Fan, Jiawei Cui, Yankai Lin, Wei Lu
Abstract degli autori
L’apprendimento per rinforzo con ricompense verificabili (RLVR) per gli agenti multi-turno si basa su ricompense terminali sparse, che dicono poco sui singoli passaggi. Il confronto tra passaggi all’interno di un gruppo richiede una corrispondenza affidabile tra gli stati ed esiti campionati sufficientemente diversificati, mentre la valutazione diretta dei passaggi può richiedere costosi valutatori esterni, annotazioni umane o euristiche specifiche per il compito. Presentiamo DeltaTTG, che apprende un segnale di avanzamento riutilizzabile mediante un indicatore condiviso, sfruttando una supervisione a basso costo tratta dalle traiettorie registrate di diverse politiche, senza regole di avanzamento specifiche per il compito. L’obiettivo di questa supervisione è Token-to-Go (TTG), il numero di token ancora da generare prima del completamento del compito, che funge da indicatore osservabile dello sforzo ancora necessario per completarlo. Durante l’addestramento dell’attore, le variazioni nelle stime dell’indicatore, mantenuto fisso, ridistribuiscono tra i passaggi i vantaggi derivati dall’esito senza modificare la ricompensa, preservando per ogni traiettoria il segno del vantaggio e la sua scala media per token. Su ALFWorld, PaperSearchQA e BFCLv3, DeltaTTG migliora il punteggio medio rispetto a GRPO di 5,7 e 7,2 punti rispettivamente con Qwen3-4B e Llama-3.1-8B-Instruct, supera in media tutti i metodi RL di riferimento considerati e mantiene le ore-GPU necessarie per addestrare l’attore vicine a quelle di GRPO. Ulteriori esperimenti mostrano una maggiore efficienza nell’uso dei campioni e prestazioni migliori fuori dominio, e confermano la capacità dell’indicatore di distinguere la qualità dei passaggi e guidare la selezione delle azioni in fase di test con attori di dimensioni diverse. Il codice è disponibile all’indirizzo https://github.com/Xuyan923r/DeltaTTG.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv