Ricerca
CurveCodec 2: compressione delle animazioni indipendente dallo scheletro con un modello di entropia appreso
Il movimento scheletrico viene memorizzato come trasformazione di ogni articolazione in ogni fotogramma, ma gran parte di queste informazioni è determinata dal corpo, più che da ciò che il movimento r
- arXiv
- 2610.04211
- Pubblicato
- 2026-10-03
- Autori
- Mingyi Shi, Huancheng Lin, Xuelin Chen, Taku Komura
Abstract degli autori
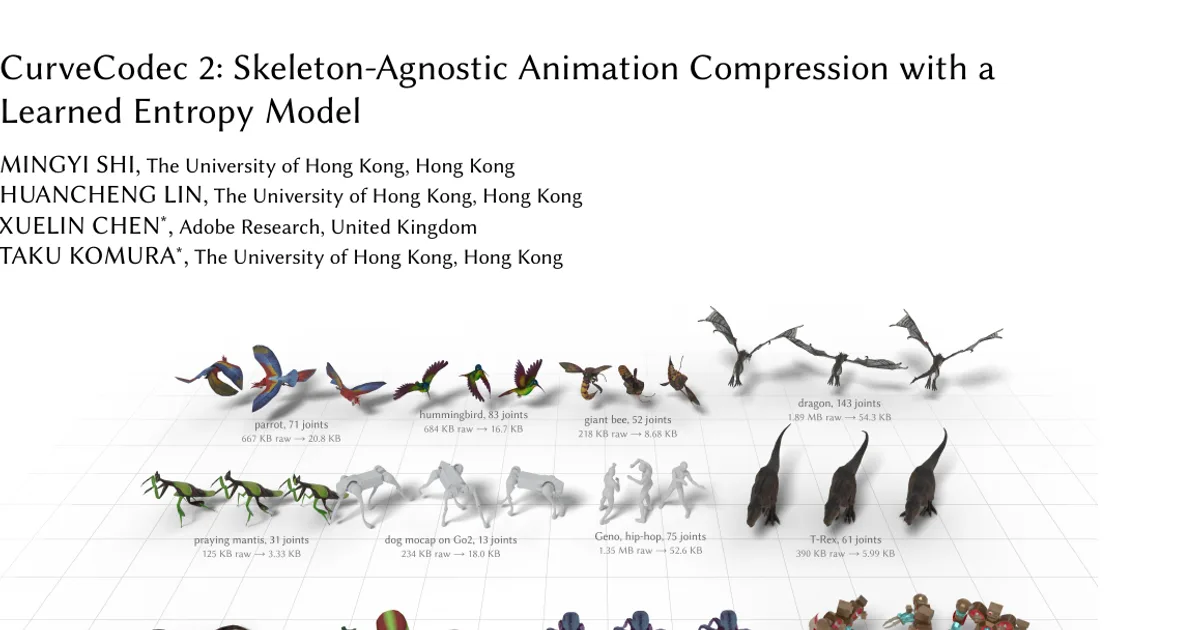
Il movimento scheletrico viene memorizzato come trasformazione di ogni articolazione in ogni fotogramma, ma gran parte di queste informazioni è determinata dal corpo, più che da ciò che il movimento rappresenta. La compressione è un modo per chiedersi quali informazioni debba ancora contenere un movimento una volta noto il corpo; un codec destinato alla produzione deve rispondere per qualsiasi scheletro, rispettando un limite d’errore dichiarato. Il nostro codec precedente, CurveCodec, eguagliava l’errore medio di ACL, la libreria impiegata in produzione nei moderni motori di gioco, grazie a un modello appreso delle ancore sparse. Non ne eguagliava però l’errore nel caso peggiore e misurava il proprio payload in numeri in virgola mobile anziché in bit. Qui ci chiediamo dove risieda la ridondanza del movimento scheletrico e quale parte del codec debba essere affidata a un modello appreso. Le misurazioni forniscono tre risposte. Alla precisione richiesta in produzione, il risparmio maggiore deriva dal predire ogni curva quantizzata a partire dai suoi valori precedenti; il secondo, dallo scegliere per ogni articolazione, a ciclo chiuso lungo la gerarchia, quali campioni non codificare. Negli intervalli lasciati da un codificatore di questo tipo, un oracolo basato sul vicino più prossimo fra milioni di campioni di addestramento non supera l’interpolazione lineare, e nessuno degli interpolatori appresi che abbiamo provato ha giustificato il proprio costo. Ciò che una rete apprende, invece, è la distribuzione dei residui che il codec deve trasmettere. CurveCodec 2 codifica ogni sottotraccia come una curva nella mappa logaritmica, quantizzata a ciclo chiuso e ridotta ai punti chiave selezionati in base al rapporto tasso-distorsione. I residui sono codificati entropicamente con un piccolo modello appreso la cui inferenza con numeri interi è identica bit per bit su piattaforme diverse. Su ogni clip decodificato vengono verificati due vincoli alternativi: l’errore di ACL nel caso peggiore per ciascuna articolazione, entro una tolleranza dichiarata, oppure l’errore medio di ACL per clip. Su un insieme di test tenuto separato, composto da 4.472 clip provenienti da 33 dataset, CurveCodec 2 richiede 0,37 volte i byte di ACL alla precisione predefinita di ACL di 0,01 cm con il vincolo sul caso peggiore e 0,22 volte i byte a 0,1 cm con il vincolo sull’errore medio. Esegue la decodifica su un solo core della CPU e si trasferisce senza riaddestramento a una specie assente dai dati di addestramento. Pagina del progetto: https://rubbly.cn/publications/curvecodec/
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv