Ricerca
CoVeR: pruning dei token basato sulla copertura per il ragionamento 3D multivista nei VLM
Rappresentare una scena 3D attraverso immagini da più punti di vista consente ai VLM 2D di ragionare in 3D sfruttando le conoscenze acquisite durante il pre-addestramento, aggirando la scarsità di dat
- arXiv
- 2609.08345
- Pubblicato
- 2026-09-08
- Autori
- Nhat-Tan Bui, Varshini Elangovan, Arun Reddy Anugu, Sreyas Mohan, Wei Ye, Dilin Wang, JQ Huang, Rakesh Ranjan, Aviral Chharia, Fernando De la Torre
Abstract degli autori
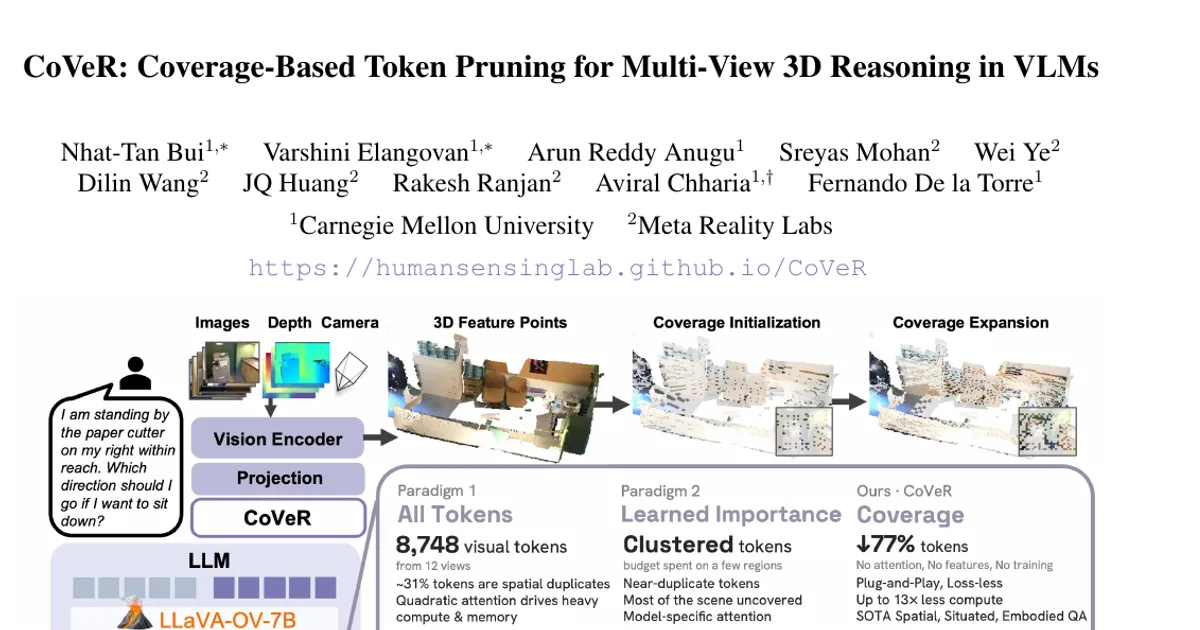
Rappresentare una scena 3D attraverso immagini da più punti di vista consente ai VLM 2D di ragionare in 3D sfruttando le conoscenze acquisite durante il pre-addestramento, aggirando la scarsità di dati 3D annotati. Questo approccio, però, produce migliaia di token visivi ridondanti, il cui costo cresce con ogni nuova vista. I metodi esistenti per il pruning dei token visivi si dividono in due categorie, entrambe con limiti nel contesto 3D multivista. I metodi di importanza appresa classificano i token in base all’attenzione o alle caratteristiche dell’encoder; poiché in questo caso la ridondanza è fondamentalmente spaziale, conservano token quasi duplicati provenienti da poche regioni salienti e lasciano gran parte della scena senza rappresentazione. I metodi basati sulla voxelizzazione migliorano la copertura spaziale, ma non possono rispettare un numero esatto di token e raggiungono un punto di saturazione quando le osservazioni da più viste si sovrappongono nello spazio 3D, limitando la quota di token conservati ben al di sotto dell’obiettivo. Mostriamo che la copertura spaziale è associata alle prestazioni nel ragionamento 3D e presentiamo CoVeR, un metodo di selezione deterministico che non richiede addestramento e usa soltanto le coordinate dei token, senza segnali appresi. CoVeR seleziona token che, nel loro insieme, coprono ogni regione della scena e supera i limiti di entrambe le categorie: rispetta un numero esatto di token per scena, supera il punto di saturazione della voxelizzazione ed evita di selezionare token quasi duplicati come fanno i metodi di importanza appresa. Esperimenti approfonditi mostrano che CoVeR supera i precedenti metodi SOTA in tutti e tre i benchmark di ragionamento 3D e si generalizza come modulo plug-and-play testato su quattro VLM. In particolare, con appena $\approx$8% dei token visivi, mantiene il 93,5% delle prestazioni ottenute con tutti i token, superando i metodi SOTA di 3,9 punti percentuali in media sui benchmark.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv