Ricerca
CoVA-SFT: un dataset su larga scala per la catena di astrazioni visive
Il ragionamento basato sulla catena di pensiero (CoT) ha migliorato notevolmente i modelli linguistici di grandi dimensioni (LLM), consentendo loro di scomporre i problemi in passaggi intermedi. Sebbe
- arXiv
- 2608.28958
- Pubblicato
- 2026-08-29
- Autori
- Tsung-Han Wu, Heekyung Lee, Anya Ji, Haoming Chen, Trevor Darrell, Joseph E. Gonzalez, David M. Chan
Abstract degli autori
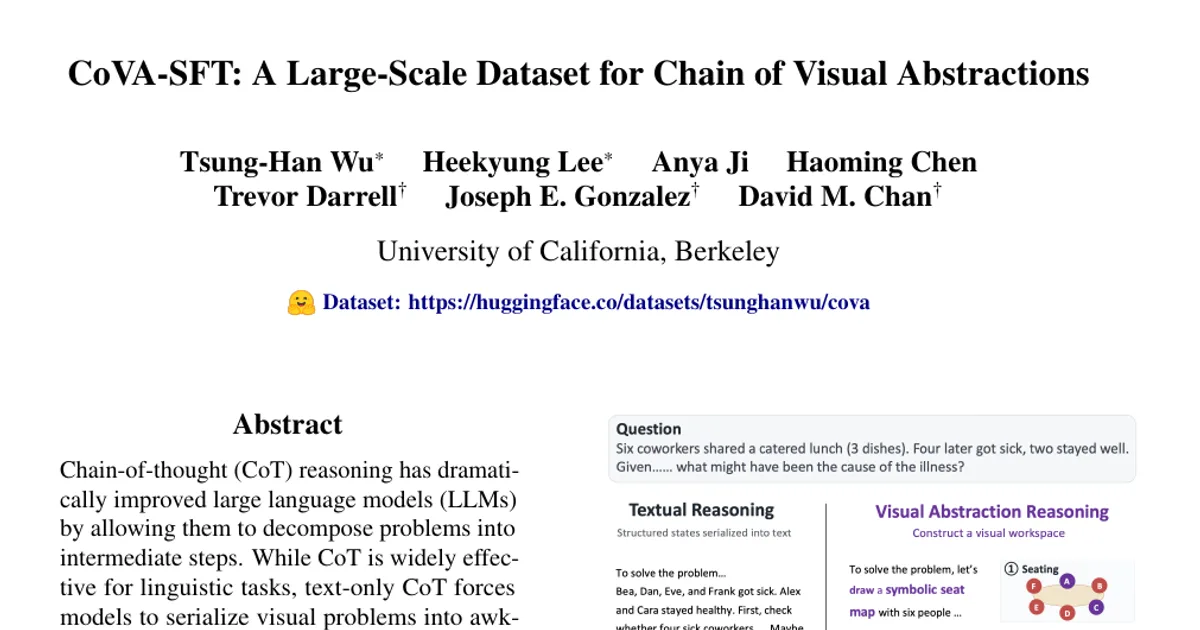
Il ragionamento basato sulla catena di pensiero (CoT) ha migliorato notevolmente i modelli linguistici di grandi dimensioni (LLM), consentendo loro di scomporre i problemi in passaggi intermedi. Sebbene la CoT sia ampiamente efficace nei compiti linguistici, una CoT basata solo sul testo costringe i modelli a tradurre i problemi visivi in descrizioni verbali poco naturali. Esistono soluzioni architetturali per elaborare input visivi, ma alla comunità di ricerca manca un dataset di grandi dimensioni, articolato in più passaggi e autocorretto, che insegni ai modelli a costruire e mantenere spazi di lavoro visivi interni quando risolvono problemi di ragionamento puramente testuali. Per colmare questa lacuna, presentiamo CoVA-SFT, un corpus altamente strutturato di 51,9K campioni contenente oltre 222K passaggi di ragionamento multimodale, distribuiti tra 5 diverse famiglie di layout e 17 compiti complessi, e CoVA-Bench, un benchmark complementare di 1.700 campioni di test tenuti da parte, relativi agli stessi compiti, per una valutazione riproducibile. Fornendo formulazioni esplicite del ragionamento, rendering agentici e cicli di verifica, CoVA-SFT insegna ai modelli linguistici multimodali ad alternare testo e astrazioni visive. Validiamo il dataset mostrando che, su CoVA-Bench, i modelli sottoposti a fine-tuning con CoVA-SFT ottengono in media risultati oltre 2 volte superiori a quelli di tutti i modelli di riferimento con CoT intercalata, pur rimanendo inferiori a solidi modelli di riferimento con CoT basata solo sul testo. Questo risultato mette in luce questioni ancora aperte per la ricerca futura.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv