Ricerca
ControlScope: revisione dei flussi di lavoro e affidabilità degli agenti basati su LLM
Quanto di un flusso di lavoro in corso dovrebbe rivedere un agente basato su un modello linguistico? ControlScope confronta tre possibilità: proseguire con il codice generato, modificare gli argomenti
- arXiv
- 2609.34313
- Pubblicato
- 2026-09-28
- Autori
- Jingjie Ning, Xueqi Li, Yibo Kong, Dongting Li
Abstract degli autori
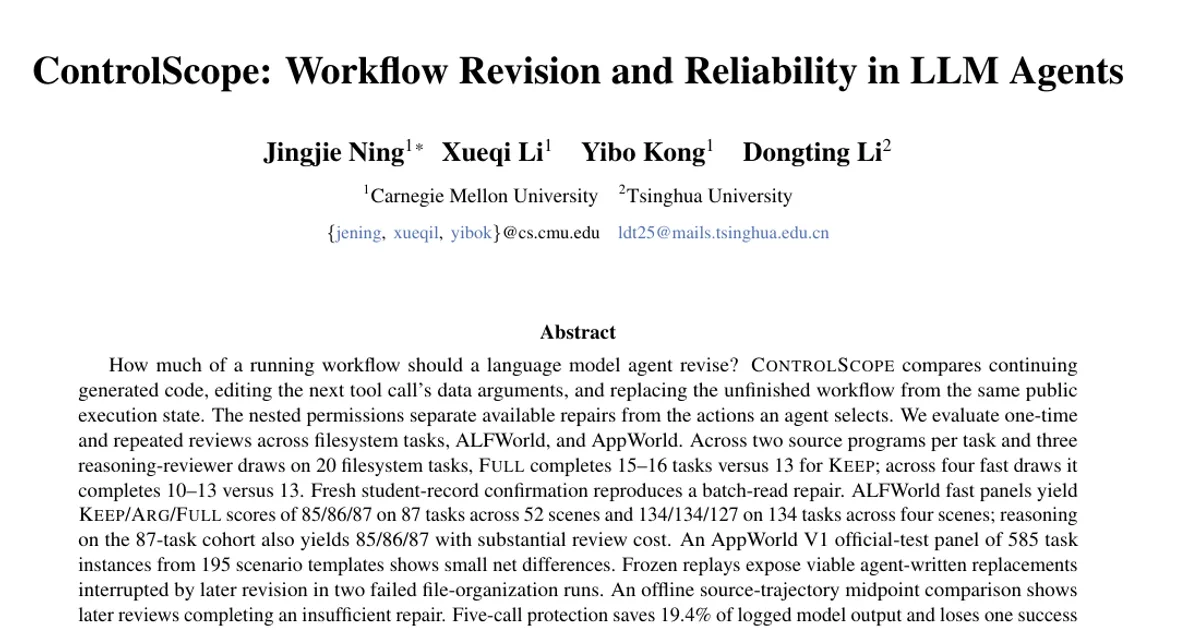
Quanto di un flusso di lavoro in corso dovrebbe rivedere un agente basato su un modello linguistico? ControlScope confronta tre possibilità: proseguire con il codice generato, modificare gli argomenti che contengono i dati nella chiamata successiva a uno strumento e sostituire il flusso di lavoro non ancora completato, partendo dallo stesso stato pubblico dell’esecuzione. I livelli di autorizzazione distinguono le correzioni disponibili dalle azioni che l’agente sceglie. Valutiamo verifiche singole e ripetute su compiti relativi al filesystem, ALFWorld e AppWorld. Su 20 compiti relativi al filesystem, considerando due programmi sorgente per compito e tre campionamenti del revisore che usa il ragionamento, FULL porta a termine 15-16 compiti contro i 13 di KEEP; con quattro campionamenti rapidi ne porta a termine 10-13 contro 13. Una nuova verifica sui record degli studenti riproduce una correzione della lettura in blocco. Nei gruppi di prove rapide di ALFWorld, KEEP/ARG/FULL ottengono punteggi di 85/86/87 su 87 compiti distribuiti in 52 scene e di 134/134/127 su 134 compiti distribuiti in quattro scene; sul gruppo di 87 compiti, anche la modalità con ragionamento ottiene 85/86/87, ma con un costo di verifica considerevole. Un gruppo di prove sul test ufficiale di AppWorld V1, composto da 585 istanze di compiti tratte da 195 modelli di scenario, mostra differenze nette modeste. Replay congelati mettono in luce sostituzioni praticabili scritte dall’agente, ma interrotte da revisioni successive in due esecuzioni fallite di organizzazione dei file. Un confronto offline al punto intermedio delle traiettorie sorgente mostra che verifiche successive completano una correzione insufficiente. La protezione per cinque chiamate riduce del 19,4% l’output del modello registrato e comporta la perdita di un successo su 20 nuove esecuzioni dei programmi sorgente. Una scorciatoia limitata agli argomenti mostra che la politica campionata più ampia può trascurare una modifica meno costosa e capace di riuscire, disponibile in entrambi gli insiemi di operazioni. Questi risultati collegano l’accesso alle correzioni alle scelte effettive e all’esecuzione successiva.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv