Ricerca
Consistent Distribution Matching per la distillazione dei modelli di diffusione senza dati
I modelli di flusso e di diffusione hanno un’inferenza lenta a causa dell’elevato costo computazionale dell’integrazione numerica. La distillazione offre allo studente un modo promettente per apprende
- arXiv
- 2610.09221
- Pubblicato
- 2026-10-06
- Autori
- Yuxiang Fu, Qi Yan, Zike Wu, Yongxing Zhang, Purang Abolmaesumi, Lele Wang, Renjie Liao
Abstract degli autori
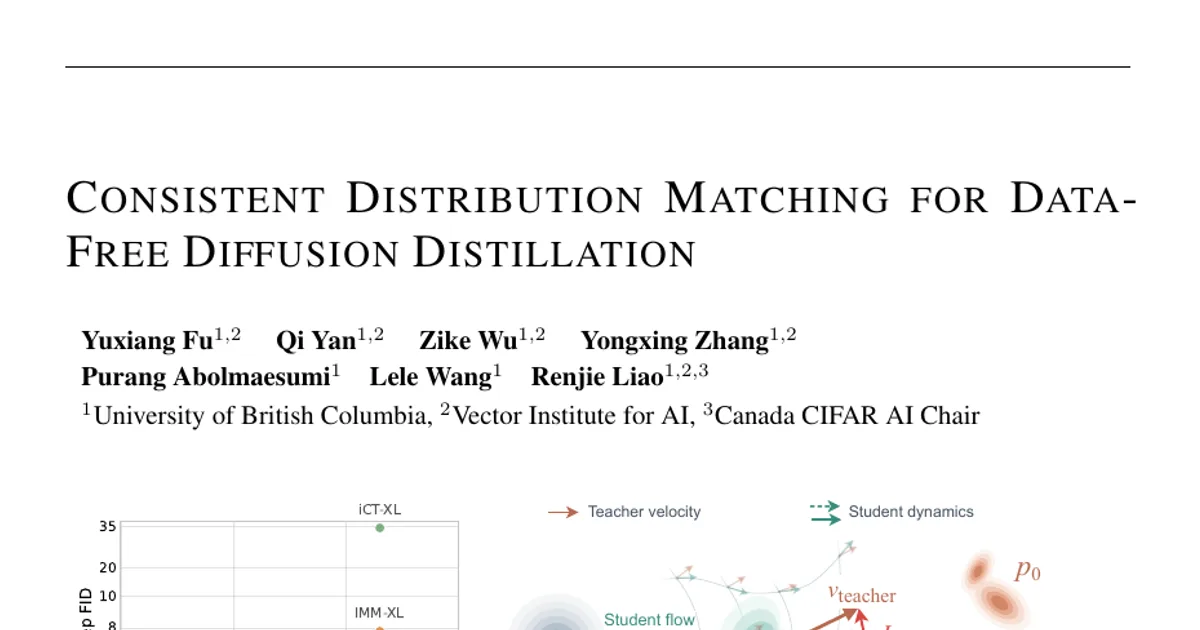
I modelli di flusso e di diffusione hanno un’inferenza lenta a causa dell’elevato costo computazionale dell’integrazione numerica. La distillazione offre allo studente un modo promettente per apprendere la dinamica del modello insegnante, consentendo la generazione in uno o pochi passaggi. Tuttavia, i metodi esistenti dipendono spesso da dataset di distillazione selezionati, da costose simulazioni del modello insegnante o da reti ausiliarie, che complicano l’addestramento e la scalabilità dei modelli. In questo lavoro proponiamo Consistent Distribution Matching, un metodo di distillazione senza simulazioni né dati che accelera i modelli di diffusione e di flusso preservandone l’elevata capacità generativa. L’idea centrale è affidare a un’unica rete studente sia la generazione dei campioni sia la stima dello score. Il nostro approccio usa quindi soltanto due modelli, un insegnante con parametri fissi e uno studente addestrabile, e ottimizza un unico obiettivo. Dimostriamo che la minimizzazione di tale obiettivo implica la convergenza in distanza di Wasserstein delle distribuzioni ottenute tramite le mappe di flusso dello studente verso le distribuzioni marginali dell’insegnante. Su ImageNet 256$\times$256, il nostro metodo raggiunge un FID di 2,04 con una sola valutazione della funzione (1-NFE) e un FID di 1,37 con 4-NFE entro 40 epoche di addestramento, superando i metodi di riferimento più avanzati per la distillazione senza dati. Il codice e il modello sono disponibili all’indirizzo https://consistentdmd.github.io/.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv