Ricerca
ConEx: mappe di salienza interpretabili dalle persone tramite attribuzione sensibile ai concetti
Molti metodi di spiegazione visiva nella visione artificiale evidenziano l’importanza dei pixel, ma faticano a collegare questi segnali di basso livello a concetti semanticamente significativi, limita
- arXiv
- 2610.04605
- Pubblicato
- 2026-10-03
- Autori
- Yehonatan Elisha, Oren Barkan, Ziv Weiss Haddad, Noam Koenigstein
Abstract degli autori
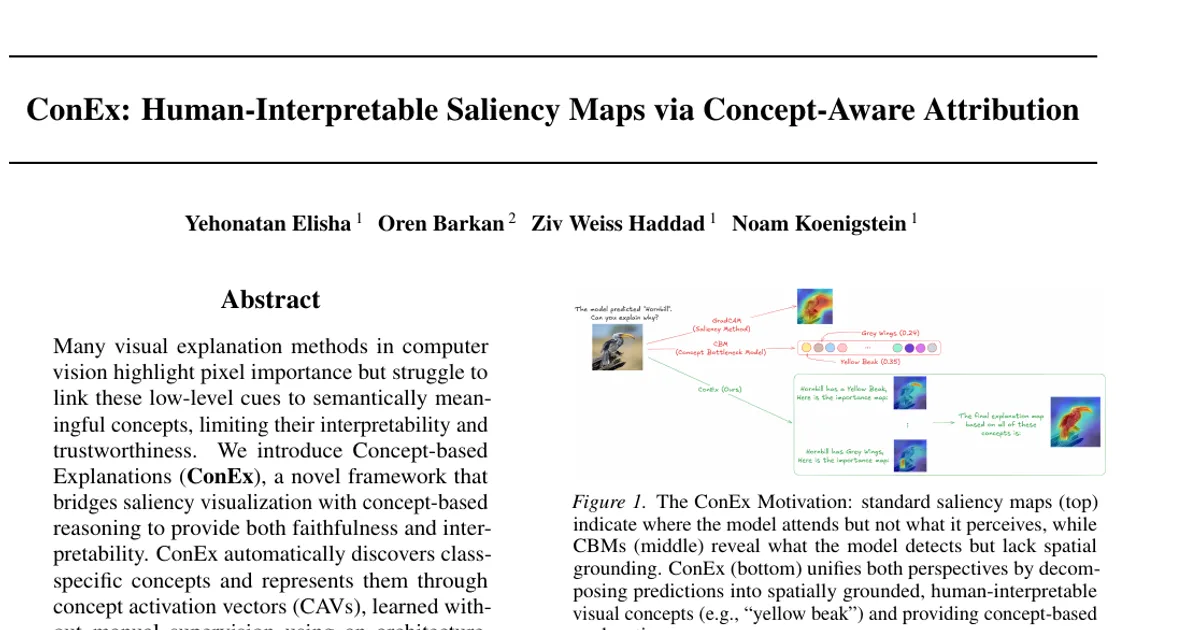
Molti metodi di spiegazione visiva nella visione artificiale evidenziano l’importanza dei pixel, ma faticano a collegare questi segnali di basso livello a concetti semanticamente significativi, limitando così la propria interpretabilità e affidabilità. Presentiamo Concept-based Explanations (ConEx), un nuovo framework che unisce la visualizzazione della salienza al ragionamento basato sui concetti per offrire spiegazioni fedeli e interpretabili. ConEx individua automaticamente concetti specifici per ciascuna classe e li rappresenta mediante vettori di attivazione dei concetti (CAVs), appresi senza supervisione manuale grazie a un meccanismo di mascheramento specifico per l’architettura che riduce il rumore introdotto dalle maschere di segmentazione per aumentare la purezza dei concetti. ConEx genera mappe di salienza fedeli che mostrano dove compare ciascun concetto nell’immagine e in che modo contribuisce alla previsione. Per valutare l’affidabilità dei concetti appresi, proponiamo due metriche complementari, Vector-Concept Match (VCM) e Concept-Class Match (CCM), che quantificano l’allineamento dei concetti e consentono un confronto diretto con i metodi esistenti. Numerosi esperimenti in contesti diversi dimostrano che ConEx raggiunge prestazioni allo stato dell’arte nei benchmark di fedeltà, segmentazione e qualità dei concetti. Nel complesso, ConEx contribuisce a orientare il settore verso spiegazioni dei modelli di visione realmente interpretabili e fondate sui concetti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv