Ricerca
ColNanoVDR: distillazione delle query senza documenti per il recupero di documenti visivi a vettori multipli mediante trasporto ottimale
I sistemi di recupero a vettori multipli basati su modelli visione-linguaggio sono all’avanguardia nel recupero di documenti visivi (VDR), ma eseguono un codificatore di query con diversi miliardi di
- arXiv
- 2609.34899
- Pubblicato
- 2026-09-28
- Autori
- Zhuchenyang Liu, Ziyi Wang, Yao Zhang, Yu Xiao
Abstract degli autori
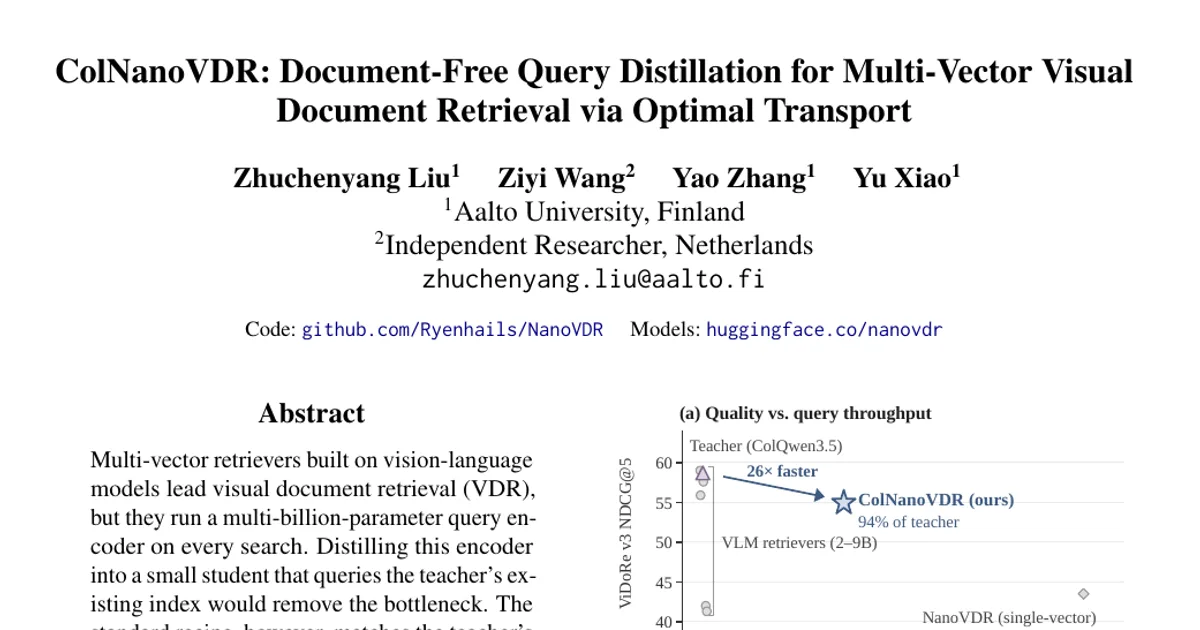
I sistemi di recupero a vettori multipli basati su modelli visione-linguaggio sono all’avanguardia nel recupero di documenti visivi (VDR), ma eseguono un codificatore di query con diversi miliardi di parametri per ogni ricerca. Distillare questo codificatore in un piccolo modello studente che interroghi l’indice già esistente del modello docente eliminerebbe il collo di bottiglia. Il metodo standard, però, riproduce i punteggi MaxSim del modello docente e richiede quindi di codificare e memorizzare nella cache ogni pagina usata per l’addestramento: i token delle pagine possono occupare terabyte. NanoVDR evita del tutto le pagine addestrandosi soltanto sugli embedding delle query del modello docente, ma funziona solo con sistemi di recupero a vettore singolo. Presentiamo ColNanoVDR, a nostra conoscenza il primo framework che estende questa distillazione senza documenti al VDR a vettori multipli. La sua funzione obiettivo, OTW (Optimal Transport with Learned Weights), allinea i token delle query del modello studente con quelli del modello docente mediante trasporto ottimale entropico, assegnando a ogni token dello studente un peso appreso, e non richiede alcuna corrispondenza tra le due tokenizzazioni. Dimostriamo che il costo dell’allineamento così ottenuto costituisce un limite superiore alla differenza tra i punteggi MaxSim per ogni pagina. Distillati da cinque modelli docenti allo stato dell’arte, i modelli studenti da 149M parametri, basati solo sul testo, conservano circa il 95% dell’NDCG@5 dei rispettivi docenti su ViDoRe v1-v3, codificando le query fino a 26 volte più velocemente. A parità di addestramento, OTW eguaglia la distillazione basata sui punteggi senza codificare alcuna pagina e leggendo una quantità di dati del modello docente memorizzati nella cache 12,6 volte inferiore.