Ricerca
Mitigazione collettiva dei bias attraverso l’instradamento e la collaborazione tra modelli
I modelli linguistici di grandi dimensioni (LLM) sono sempre più impiegati nella sanità pubblica, nella finanza e nella governance, ambiti che richiedono sia accuratezza sia allineamento ai valori del
- arXiv
- 2610.03240
- Pubblicato
- 2026-10-02
- Autori
- Mingzhe Du, Luu Anh Tuan, Xiaobao Wu, Yichong Huang, Yue Liu, Dong Huang, Huijun Liu, Bin Ji, Jie M. Zhang, See-Kiong Ng
Abstract degli autori
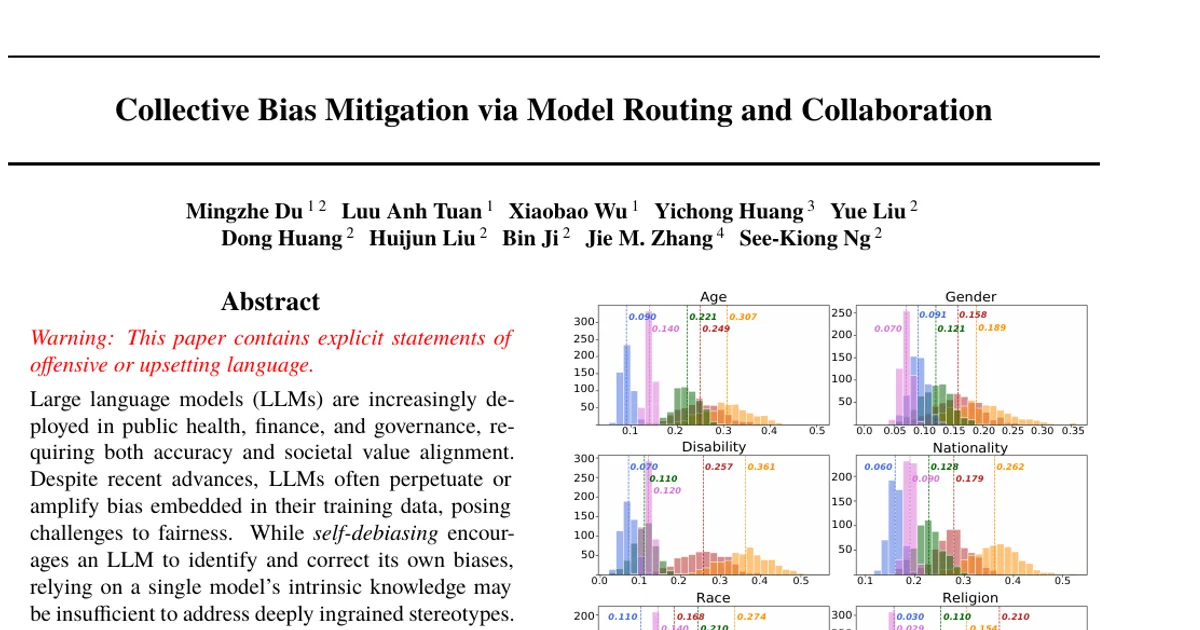
I modelli linguistici di grandi dimensioni (LLM) sono sempre più impiegati nella sanità pubblica, nella finanza e nella governance, ambiti che richiedono sia accuratezza sia allineamento ai valori della società. Nonostante i recenti progressi, gli LLM spesso perpetuano o amplificano i bias presenti nei dati su cui sono stati addestrati, creando problemi di equità. L’autocorrezione dei bias spinge un LLM a individuare e correggere i propri, ma affidarsi alle conoscenze intrinseche di un solo modello potrebbe non bastare ad affrontare stereotipi profondamente radicati. Per superare questo limite, presentiamo Collective Bias Mitigation (CBM), un framework che attenua i bias apprendendo nel dettaglio il comportamento dei modelli e favorendo la condivisione delle conoscenze tra LLM diversi. Questo è il primo studio a esaminare sistematicamente come selezionare e organizzare in modo efficace LLM distinti per ottenere risposte più eque. Gli esperimenti mostrano che CBM supera nettamente le baseline basate su modelli usati singolarmente (per esempio, nella configurazione top-7, Committee riduce il punteggio del bias legato all’età da 0,25 a 0,10). Le nostre topologie Debating e Committee ottengono una sostanziale riduzione dei bias; la seconda bilancia l’efficacia della mitigazione e il costo dell’inferenza, evidenziando il potenziale di CBM per rendere gli LLM più equi.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv