Ricerca
Code2Video-Compass: un benchmark completo per la generazione di video tramite codice per uso generale nei contesti T2V, I2V e V2V
Rispetto alla generazione diretta di video, la generazione tramite codice offre un controllo più preciso, modifiche mirate e il riutilizzo dei componenti. Questo approccio richiede ai modelli linguist
- arXiv
- 2610.28416
- Pubblicato
- 2026-10-20
- Autori
- Zhenghan Chen, Zekai Shao, Xin Lin, Leting Cheng, Siming Chen
Abstract degli autori
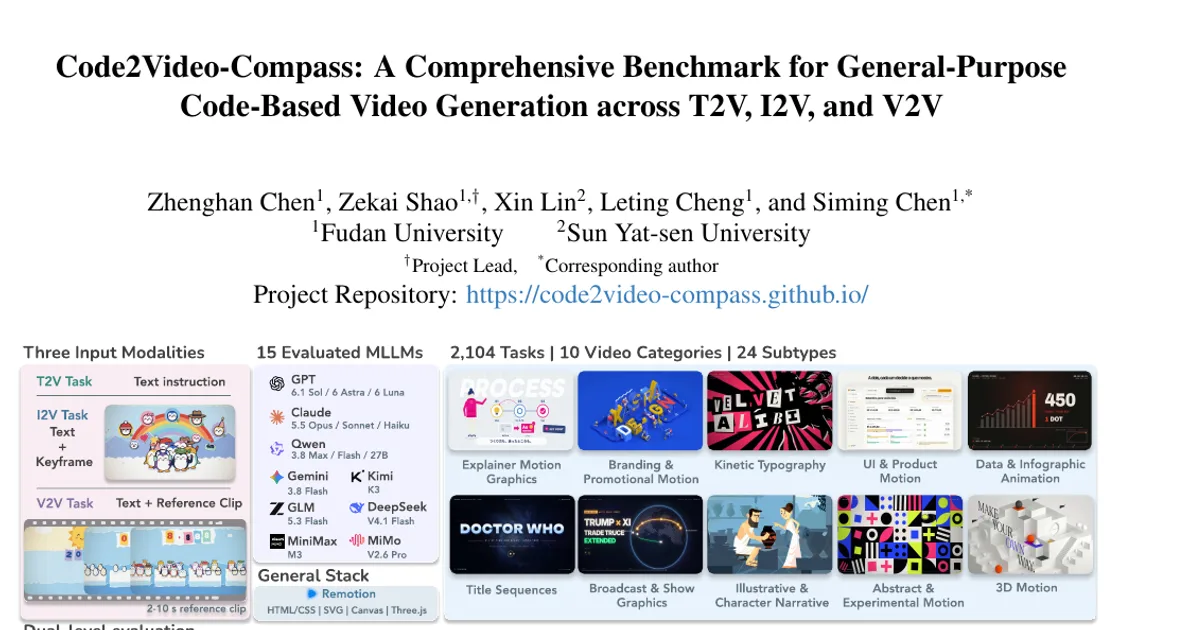
Rispetto alla generazione diretta di video, la generazione tramite codice offre un controllo più preciso, modifiche mirate e il riutilizzo dei componenti. Questo approccio richiede ai modelli linguistici multimodali di grandi dimensioni (MLLM) di tradurre requisiti visivi e temporali in programmi eseguibili che producano video completi. I benchmark esistenti per la generazione tramite codice, tuttavia, si concentrano soprattutto su compiti specialistici, lasciando insufficientemente valutata la creazione di video completi in diverse categorie creative e modalità di input. Presentiamo Code2Video-Compass, un benchmark per uso generale dedicato alla generazione di video tramite codice nei contesti text-to-video (T2V), image-to-video (I2V) e video-to-video (V2V). Code2Video-Compass comprende 2.104 compiti distribuiti in 10 categorie e 24 sottotipi, con tre dimensioni di complessità relative alla costruzione, all’animazione dinamica e alla dipendenza dallo stato. Combina compiti selezionati a partire da istruzioni testuali e riferimenti visivi con i corrispondenti compiti T2V, I2V e V2V ricavati da video completi professionali e realizzati dagli utenti. Proponiamo un sistema di valutazione a due livelli che combina 12 metriche oggettive e cinque metriche soggettive. La valutazione oggettiva riguarda le prestazioni operative, la qualità video, la corrispondenza tra testo e video e la fedeltà ai riferimenti; quella soggettiva affida a un MLLM nel ruolo di giudice la valutazione del rispetto delle istruzioni e della qualità complessiva del video. Un’ampia valutazione di 15 MLLM recenti, proprietari e a pesi aperti, appartenenti a nove famiglie, rivela che persino i modelli più avanzati faticano a generare in modo affidabile video completi di alta qualità conformi ai requisiti testuali e visivi. Le prestazioni, in generale, diminuiscono all’aumentare della complessità della costruzione, dell’animazione dinamica e della dipendenza dallo stato. Prevediamo che Code2Video-Compass contribuirà a rendere la generazione di video tramite codice più affidabile, coerente e controllabile e stimolerà progressi più ampi nella creazione visiva mediante programmazione.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv