Ricerca
CineRecon: valutare i modelli di frontiera nella ricostruzione cinematografica agentica
Ricostruire video di riferimento sotto forma di scene 3D dinamiche e modificabili è una strada importante verso una generazione video controllabile per il cinema: queste scene offrono rappresentazioni
- arXiv
- 2610.16577
- Pubblicato
- 2026-10-12
- Autori
- Jialei Wang, Zehan Wang, XiaoYang Wu, Ziang Zhang, Siyu Chen, Jiaer Huang, Yujia Zhang, Tianyu Pang, Hengshuang Zhao
Abstract degli autori
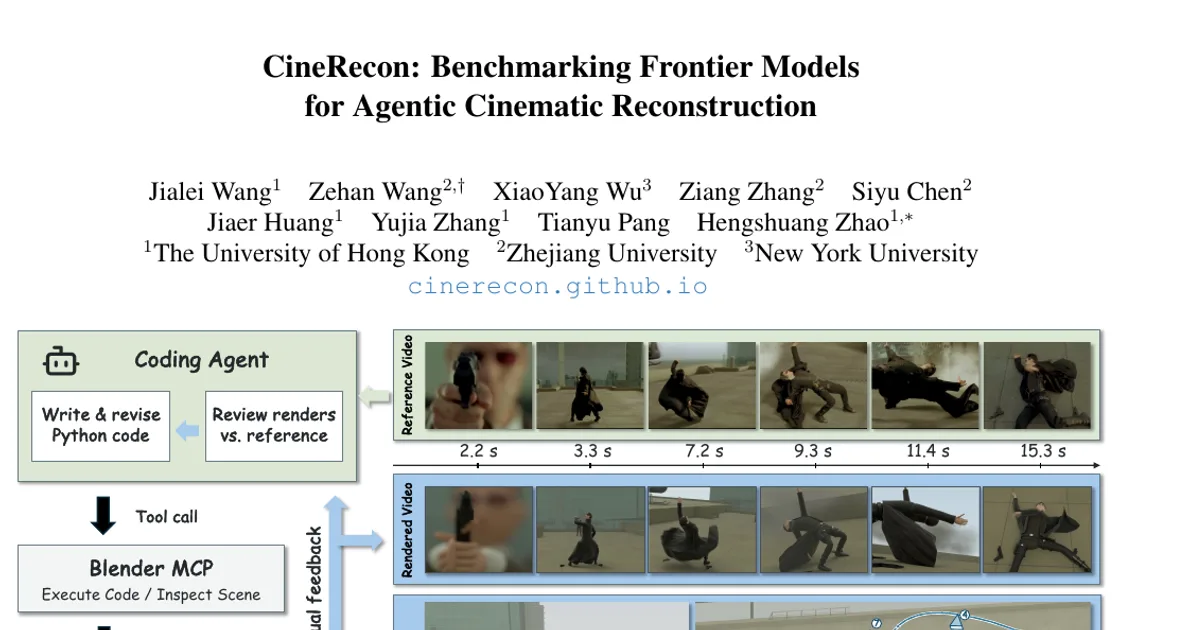
Ricostruire video di riferimento sotto forma di scene 3D dinamiche e modificabili è una strada importante verso una generazione video controllabile per il cinema: queste scene offrono rappresentazioni visive modificabili e renderizzabili che consentono un controllo esplicito sulla disposizione della scena, sulle azioni dei soggetti e sul comportamento della telecamera. Per valutare la capacità degli agenti di ricostruire scene 3D dinamiche e modificabili a partire da video di riferimento dinamici, presentiamo CineRecon, un benchmark composto da 50 video di riferimento e 360 clip di valutazione annotate. I video di riferimento comprendono film, riprese del mondo reale e videogiochi. A partire da un video completo, un agente usa strumenti per costruire, animare, renderizzare e perfezionare la propria ricostruzione. Valutiamo questo compito in tre configurazioni di rappresentazione: Proxy, Simplified e Detailed. Queste configurazioni prevedono requisiti geometrici e di aspetto visivo crescenti, mantenendo invariati quelli relativi alle relazioni spaziali, al comportamento della telecamera e alla dinamica dei soggetti. Questa impostazione permette di verificare se gli agenti riescono a riprodurre gli eventi di un video quando non è necessario un aspetto visivo dettagliato e come cambiano le prestazioni all’aumentare dei requisiti di rappresentazione. Per la valutazione, prepariamo liste di controllo che associano proprietà ed eventi osservabili a entità e momenti specifici. Un valutatore visivo-linguistico confronta i fotogrammi di riferimento con quelli renderizzati, allineati in base ai timestamp, in 11 categorie raggruppate nelle dimensioni della coerenza della telecamera, statica e dinamica. Valutiamo 12 modelli usando le rispettive infrastrutture per agenti e riscontriamo carenze in tutte e tre le dimensioni. I movimenti e le interazioni dei soggetti restano difficili da riprodurre anche nella configurazione Proxy.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv