Ricerca
CAST: supervisione basata sulla valutazione critica per addestrare agenti affidabili nell’uso di strumenti su orizzonti lunghi
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) vengono impiegati sempre più spesso in ambienti interattivi, con memoria dello stato e che richiedono lunghe sequenze di azioni. In
- arXiv
- 2608.30147
- Pubblicato
- 2026-08-31
- Autori
- Amir Saeidi, Zehua Zhang, Rishitosh Singh, Naman Ahuja, Vivek Gupta, Ali Payani, Gaowen Liu, Jayanth Srinivasa, Chitta Baral
Abstract degli autori
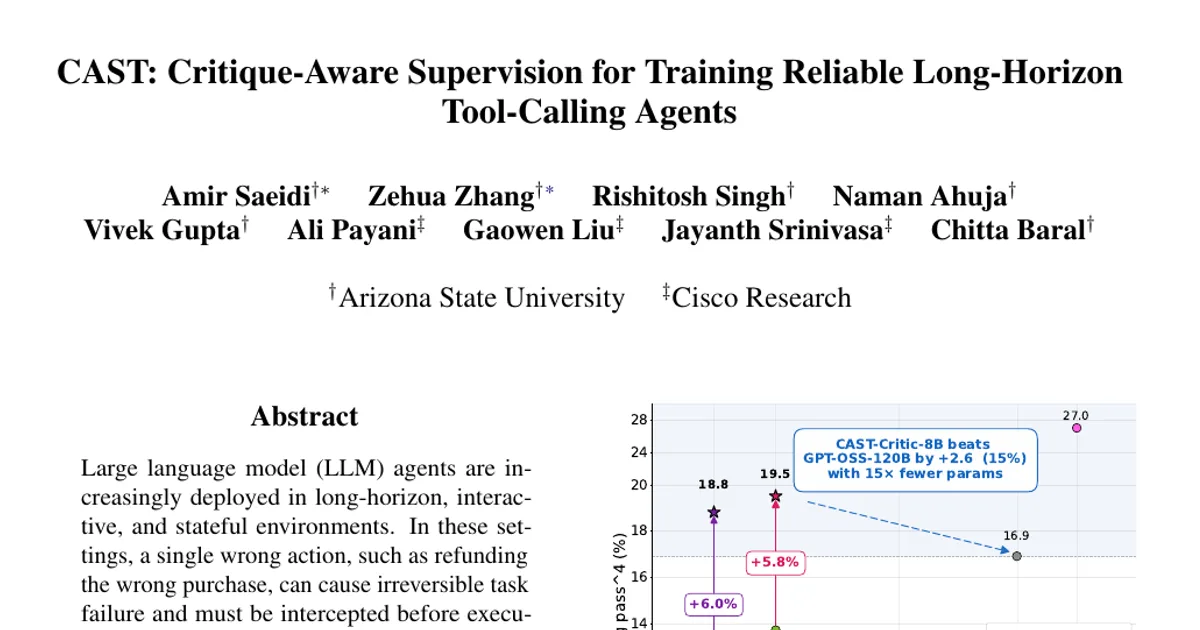
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) vengono impiegati sempre più spesso in ambienti interattivi, con memoria dello stato e che richiedono lunghe sequenze di azioni. In questi contesti, una sola azione errata, come rimborsare l’acquisto sbagliato, può causare il fallimento irreversibile del compito e deve essere intercettata prima dell’esecuzione. Questi errori potrebbero non verificarsi in ogni singola esecuzione, ma emergere nel corso di prove ripetute: per questo è fondamentale che gli agenti siano affidabili sia nei singoli passaggi sia nelle diverse prove. Garantire tale affidabilità è però difficile: persino gli LLM più avanzati faticano a spiegare perché un’azione possa essere sbagliata, soprattutto in traiettorie lunghe e interconnesse, soggette a regole specifiche del dominio. Molti studi recenti si affidano ad agenti di valutazione critica basati su prompt, mentre i metodi basati sull’ottimizzazione non dispongono di un approccio sistematico per produrre motivazioni dettagliate di verifica da usare nell’addestramento. Affrontiamo questa lacuna con CAST, un framework di addestramento basato sulla valutazione critica che trasforma i risultati dei compiti, che forniscono informazioni limitate, in segnali di supervisione a livello delle singole azioni, destinati all’apprendimento della valutazione critica e all’ottimizzazione della policy. CAST analizza le traiettorie degli agenti per generare motivazioni strutturate che spiegano la validità delle azioni in condizioni di osservabilità parziale. Il modello di valutazione critica così ottenuto viene usato per costruire dati di addestramento che tengono conto di tale valutazione e servono a ottimizzare il modello di policy. Con il fine-tuning dei modelli della famiglia Qwen3 su benchmark dinamici di chiamata agli strumenti, CAST migliora l’affidabilità in diversi domini, superando GPT-OSS-120B di oltre il 10% nel pass^4 nei compiti Retail e ottenendo un ulteriore miglioramento del 9% in Telehealth in un contesto fuori dominio. Questi risultati dimostrano che l’addestramento basato sulla valutazione critica migliora la robustezza degli agenti LLM in ambienti dinamici realistici.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv