Ricerca
Costruire rilevatori verificabili di testi generati dall’IA con autoencoder sparsi
I rilevatori di testi generati dall’IA sono sempre più utilizzati in contesti dalle conseguenze rilevanti — revisione tra pari, istruzione, ammissioni, giornalismo e moderazione dei contenuti — in cui
- arXiv
- 2610.30006
- Pubblicato
- 2026-10-21
- Autori
- Liam Dugan, Callum McDougall, Matthew Denton, Philip Pham, Christine Kaeser-Chen, Chris Callison-Burch
Abstract degli autori
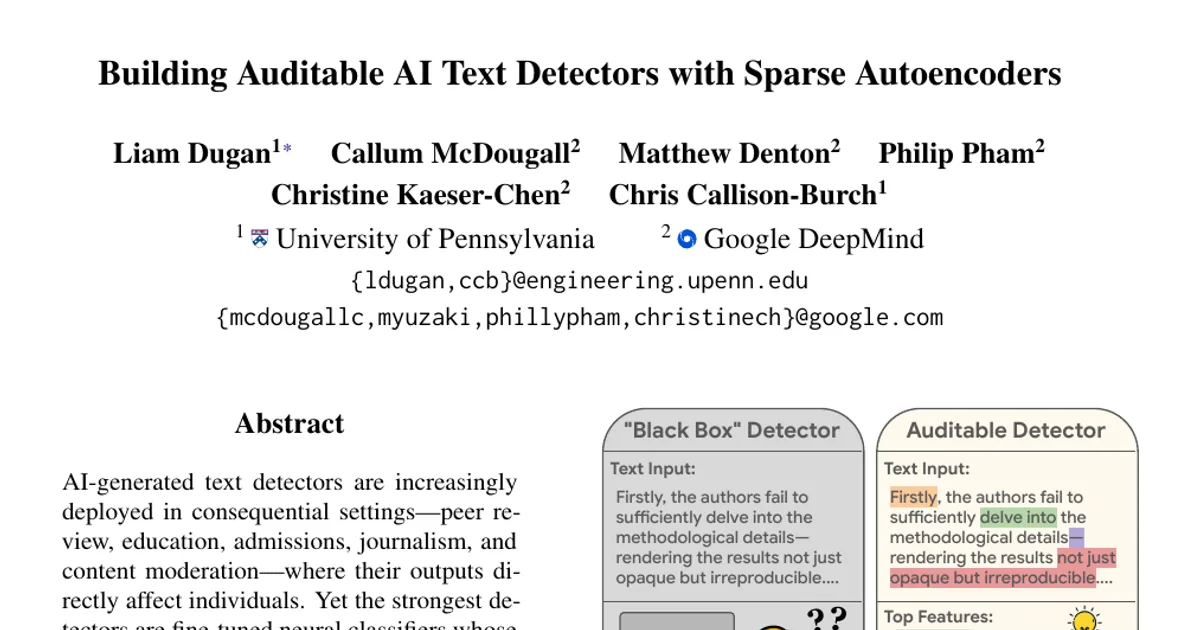
I rilevatori di testi generati dall’IA sono sempre più utilizzati in contesti dalle conseguenze rilevanti — revisione tra pari, istruzione, ammissioni, giornalismo e moderazione dei contenuti — in cui i loro risultati incidono direttamente sulle persone. Eppure i rilevatori più efficaci sono classificatori neurali sottoposti a fine-tuning le cui decisioni sono opache, mentre le alternative trasparenti, basate sulla stilometria o su caratteristiche linguistiche, ottengono risultati nettamente inferiori. Presentiamo una procedura che trasforma un rilevatore neurale sottoposto a fine-tuning in un classificatore che opera su concetti comprensibili agli esseri umani. Per farlo, addestriamo autoencoder sparsi (SAE) direttamente sul flusso residuo di un rilevatore, assegniamo etichette generate tramite autointerpretazione a ciascuna caratteristica degli SAE e conserviamo solo le caratteristiche le cui descrizioni generate superano una soglia globale di fedeltà. Addestriamo poi un classificatore leggero usando soltanto le caratteristiche interpretabili. Riscontriamo che i nostri SAE recuperano concetti latenti corrispondenti a «indizi» linguistici dei testi generati dall’IA molto specifici e altamente predittivi. I classificatori costruiti a partire da queste caratteristiche estratte non solo sono altamente interpretabili, ma ottengono sui testi fuori distribuzione risultati migliori sia delle alternative neurali sia di quelle stilometriche.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv