Ricerca
BRIDGE-EEG: un ponte tra il preaddestramento autosupervisionato e l’impiego efficiente nella classificazione EEG tra dataset
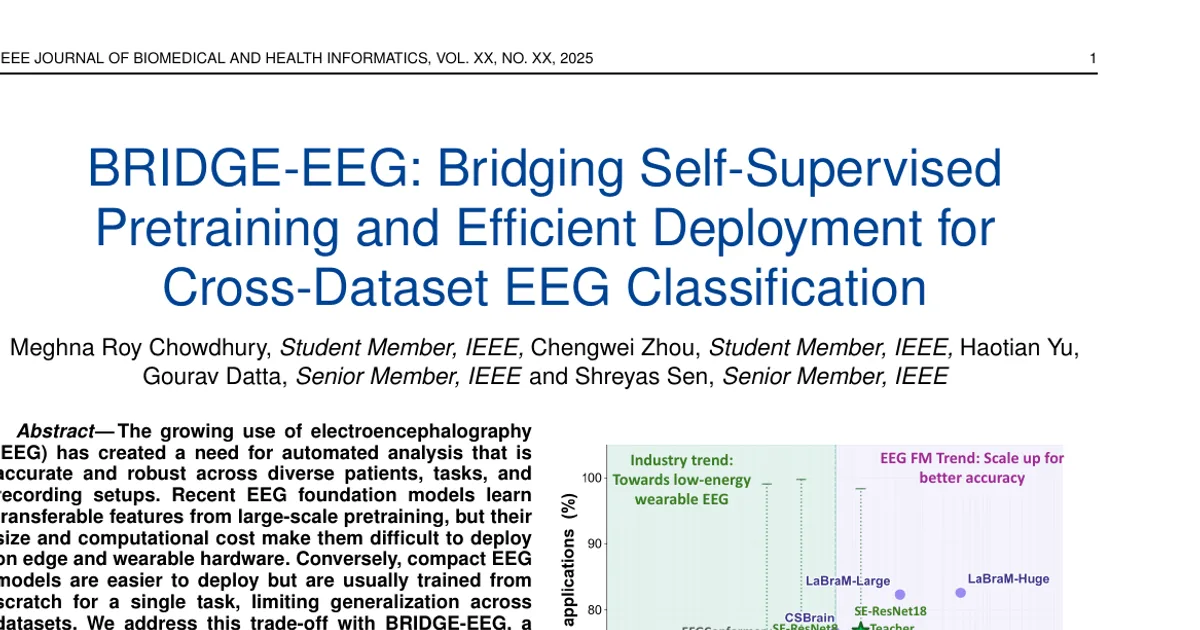
Il crescente impiego dell’elettroencefalografia (EEG) rende necessaria un’analisi automatizzata che sia accurata, trasferibile e utilizzabile su hardware con risorse limitate. I recenti modelli fondaz
- arXiv
- 2609.12218
- Pubblicato
- 2026-09-14
- Autori
- Meghna Roy Chowdhury, Chengwei Zhou, Haotian Yu, Gourav Datta, Shreyas Sen
Abstract degli autori
Il crescente impiego dell’elettroencefalografia (EEG) rende necessaria un’analisi automatizzata che sia accurata, trasferibile e utilizzabile su hardware con risorse limitate. I recenti modelli fondazionali per l’EEG apprendono rappresentazioni generali grazie al preaddestramento su larga scala, ma le loro dimensioni e il costo computazionale ne limitano l’impiego su dispositivi edge e indossabili. Presentiamo BRIDGE-EEG, una pipeline efficiente per la classificazione EEG su più compiti che conserva i vantaggi del preaddestramento riducendo le dimensioni del modello. Uno schema di preelaborazione unificato converte registrazioni eterogenee, con numeri di canali, montaggi e frequenze di campionamento diversi, in una rappresentazione tempo-frequenza a 62 canali indipendente dal dispositivo. Preaddestriamo un modello docente SE-ResNet18 (11,84 milioni di parametri) con SimCLR su dati EEG privi di etichette provenienti da cinque dataset eterogenei, poi lo comprimiamo in modelli allievi SE-ResNet8 (1,56 milioni) e SE-ResNet4 (0,48 milioni) mediante distillazione indipendente dal compito e specifica per il compito. Valutiamo sei benchmark che comprendono il rilevamento di anomalie, l’immaginazione motoria e il riconoscimento delle emozioni. Nel rilevamento di anomalie e nel riconoscimento delle emozioni, i modelli allievi raggiungono un’accuratezza paragonabile o superiore a quella di diversi modelli fondazionali EEG recenti che hanno da 10 a 1.000$\times$ più parametri. Nell’immaginazione motoria permane un divario nelle rappresentazioni, che evidenzia l’importanza della varietà dei dati di preaddestramento. La profilazione dell’inferenza su una GPU per server, una CPU desktop e NVIDIA Jetson Orin Nano mostra un consumo energetico per inferenza sui dispositivi edge fino a 3,0$\times$ inferiore (15,64 mJ contro 46,67 mJ). I modelli compatti consentono inoltre un futuro impiego su dispositivi indossabili della classe MCU.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv