Ricerca
Oltre la scena attuale: presa con riferimento a eventi e selezione attiva dei punti di vista
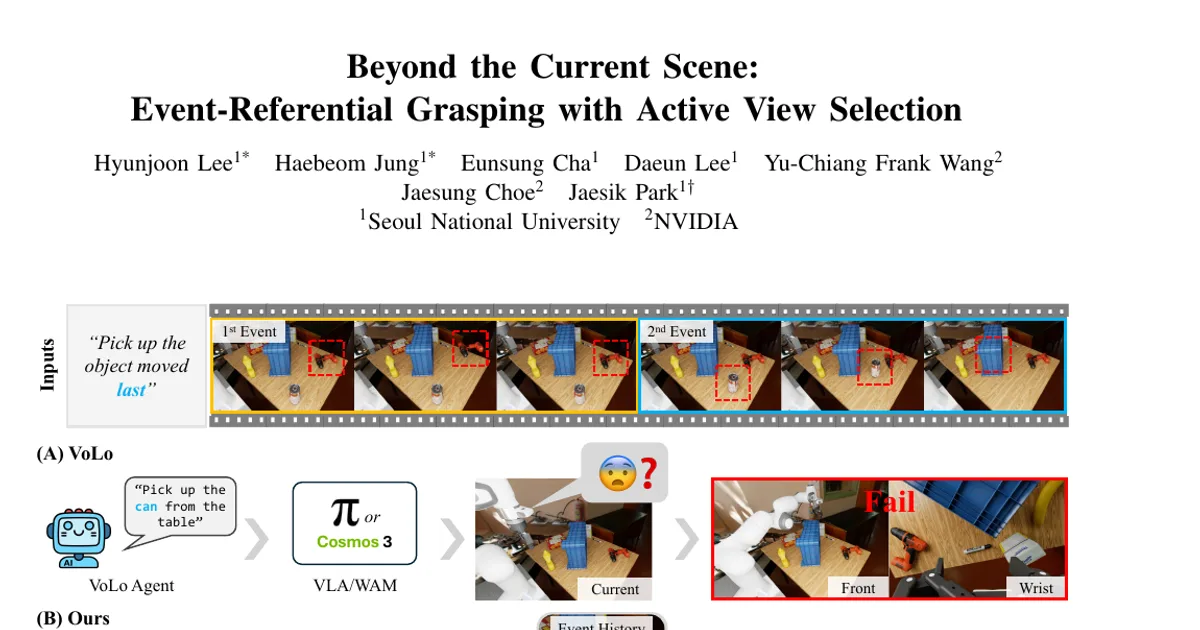
Un robot che osserva le persone interagire con gli oggetti dovrebbe essere in grado di eseguire richieste successive che fanno riferimento a quelle interazioni. Queste richieste possono indicare l’ogg
- arXiv
- 2609.39375
- Pubblicato
- 2026-09-30
- Autori
- Hyunjoon Lee, Haebeom Jung, Eunsung Cha, Daeun Lee, Yu-Chiang Frank Wang, Jaesung Choe, Jaesik Park
Abstract degli autori
Un robot che osserva le persone interagire con gli oggetti dovrebbe essere in grado di eseguire richieste successive che fanno riferimento a quelle interazioni. Queste richieste possono indicare l’oggetto da afferrare attraverso il ruolo che ha avuto in un evento passato, anziché attraverso il suo nome o il suo aspetto. Inoltre, quando al robot viene chiesto di agire, l’oggetto potrebbe non essere più visibile. Presentiamo BeyondSCe, un sistema di presa robotica zero-shot per richieste che fanno riferimento a eventi. Data la cronologia degli eventi e la scena attuale, il sistema identifica l’oggetto o la parte richiesta e ne determina la posizione per afferrarla. Se il bersaglio è occluso, combina un’informazione a priori sull’evento ricavata dalla cronologia con la geometria della scena attuale per selezionare punti di vista della telecamera che potrebbero renderlo visibile. Il sistema usa modelli preaddestrati senza ulteriore addestramento specifico per il compito. In esperimenti con un robot reale dotato di una sola telecamera RGB-D montata sul polso, raggiunge tassi di successo della presa del 76% e del 77% per bersagli inizialmente visibili e occlusi, rispettivamente, contro il 40% e il 55% del metodo di riferimento più efficace in ciascuna condizione. In quattro ulteriori scene con forti occlusioni, porta il tasso di successo della presa dal 75% al 95% e riduce il numero medio di punti di vista da 3,35 a 2,20 rispetto a un metodo di riferimento di percezione attiva a cui viene fornito il bounding box 3D di ground truth del bersaglio.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv