Ricerca
Oltre la previsione del futuro: il denoising come adattamento generativo per il controllo robotico
I Diffusion Transformers (DiTs) generativi preaddestrati apprendono ricche strutture visive a livello di pixel e condizionate dal linguaggio grazie all’addestramento su larga scala per la generazione
- arXiv
- 2609.28339
- Pubblicato
- 2026-09-23
- Autori
- Zanyi Wang, Yuheng Lei, Dengyang Jiang, Ping Luo, Mengdi Wang, Zhixuan Liang, Shilong Liu
Abstract degli autori
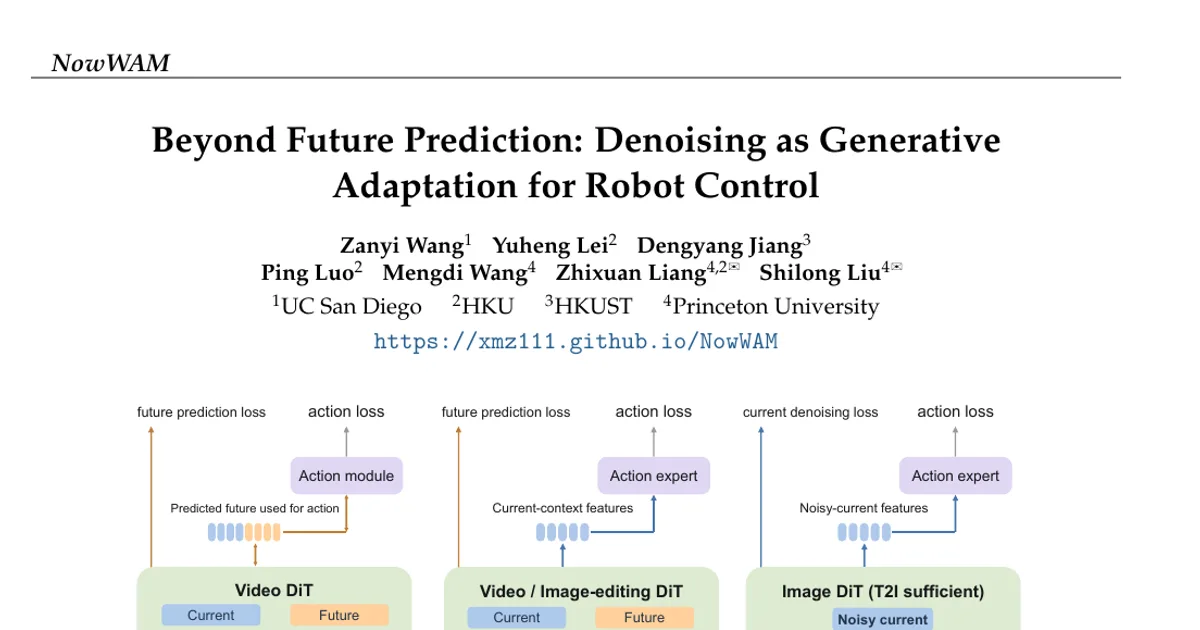
I Diffusion Transformers (DiTs) generativi preaddestrati apprendono ricche strutture visive a livello di pixel e condizionate dal linguaggio grazie all’addestramento su larga scala per la generazione di immagini e video. Un numero crescente di politiche di controllo robotico si basa su questo patrimonio generativo, ma non è ancora chiaro come trasferirlo al controllo: gli approcci esistenti lo fanno comunemente attraverso la previsione di contenuti visivi futuri. Ci poniamo una domanda più fondamentale: che cosa apporta davvero un DiT generativo preaddestrato all’apprendimento delle azioni, e come va adattato questo patrimonio al controllo? Presentiamo NowWAM, una formulazione di addestramento congiunto senza target futuro che rimuove il rumore dall’osservazione corrente e prevede le azioni del robot a partire dallo stesso flusso visivo, collegando direttamente l’obiettivo generativo originario alla rappresentazione orientata alle azioni lungo tutta la traiettoria di denoising. In condizioni sperimentali controllate e comparabili, i target visivi passati e futuri danno risultati simili, mentre limitare l’addestramento al punto finale privo di rumore riduce notevolmente la robustezza. Questo suggerisce che un target futuro separato non sia essenziale per l’adattamento generativo, mentre la traiettoria di denoising resta un’interfaccia efficace per il controllo. Su LIBERO-Plus, NowWAM raggiunge l’87,7% con FLUX2-Klein, superando di 6,1 punti il riferimento basato sull’addestramento congiunto con target futuro, dimezzando al contempo i token visivi usati nell’addestramento (da 784 a 392) e riducendo il tempo per passo da 2,85 s a 1,63 s, con un’accelerazione di 1,8 volte. Con Z-Image, un backbone esclusivamente text-to-image, NowWAM raggiunge inoltre l’87,8%, mostrando che un efficace adattamento al controllo non dipende da backbone per la generazione di video o la modifica di immagini.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv