Ricerca
Chiedere per distillare: imparare a sintetizzare dati per la distillazione on-policy
La distillazione on-policy (OPD) può riuscire con un numero sorprendentemente esiguo di domande di addestramento. Questo suggerisce di considerare le domande come veicoli per il trasferimento di conos
- arXiv
- 2610.27450
- Pubblicato
- 2026-10-20
- Autori
- Jiashuo Sun, Hao Zhang, Xueqiang Xu, Heng Wang, Yixuan Xie, Pengcheng Jiang, Zhenrui Yue, Jiajun Fan, Peiran Li, Ge Liu, Shaowen Wang, Jiawei Han
Abstract degli autori
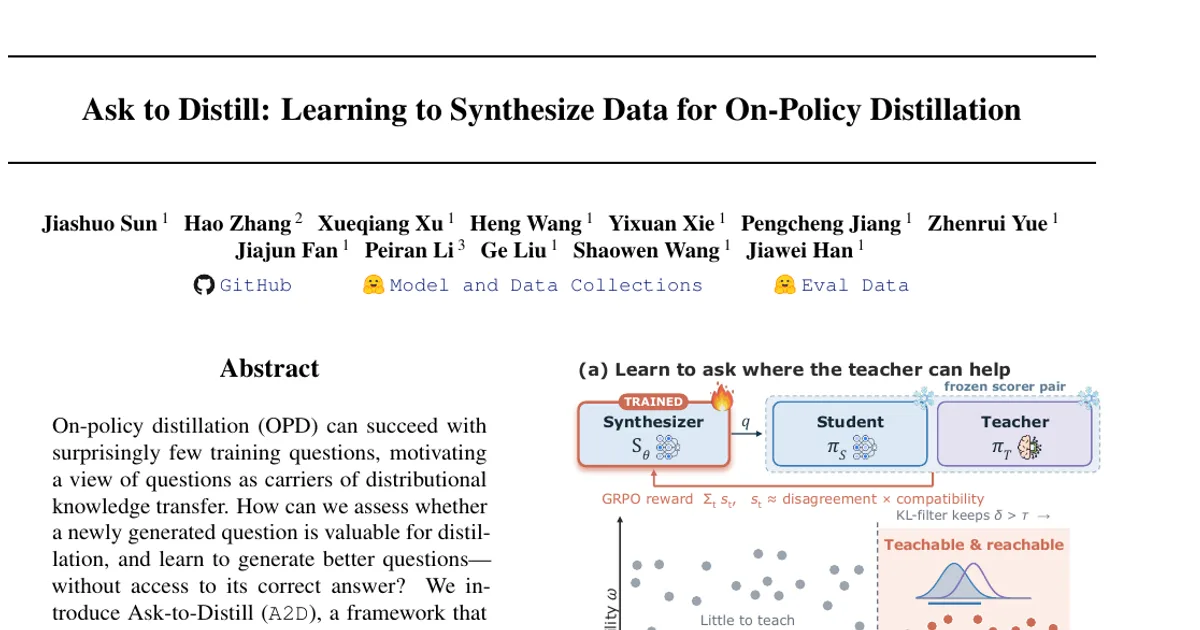
La distillazione on-policy (OPD) può riuscire con un numero sorprendentemente esiguo di domande di addestramento. Questo suggerisce di considerare le domande come veicoli per il trasferimento di conoscenze sulle distribuzioni. Come possiamo valutare se una domanda appena generata sia utile per la distillazione e imparare a generarne di migliori, senza conoscere la risposta corretta? Presentiamo Ask-to-Distill (\method), un metodo che usa domande sintetiche per far emergere le distribuzioni e ottimizza la supervisione del docente che esse rendono disponibile lungo le traiettorie generate dallo studente. Un sintetizzatore inizializzato a partire dallo studente viene ottimizzato usando una misura surrogata distribuzionale del valore delle domande, calcolata con una coppia studente–docente mantenuta fissa, senza risposte di riferimento, ricompense basate sulla correttezza o aggiornamenti dello studente per ciascuna domanda candidata. La ricompensa combina la discrepanza tra docente e studente con la massa di probabilità che il docente assegna al supporto dei candidati dello studente, oltre a controlli sulla lunghezza e sulla diversità. Le domande generate vengono filtrate e private dei duplicati per formare una raccolta di soli prompt destinata alla OPD standard. Nei compiti di ragionamento matematico, generazione di codice e di tipo agentico, il nostro metodo migliora le prestazioni medie e riduce il divario rispetto al docente più dei prompt generati dallo studente senza ottimizzazione e delle domande reali filtrate in base alla KL; negli scenari valutati, eguaglia o supera inoltre la OPD basata su una raccolta di domande reali. Ulteriori analisi del segnale mostrano che le domande ottimizzate possono far emergere una supervisione più densa e un segnale complessivo maggiore da risposte più brevi dello studente. Ciò sostiene l’uso della supervisione distribuzionale così ottenuta come obiettivo nella creazione di dati sintetici per la distillazione. Il nostro codice, i dati e i modelli sono disponibili pubblicamente all’indirizzo https://github.com/GasolSun36/Ask_to_Distill.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv