Ricerca
Aphanta: diagnosi delle immagini intermedie modificate e allineate al compito per il ragionamento multimodale
Le immagini intermedie esplicite possono aiutare i modelli linguistici multimodali di grandi dimensioni (MLLM) a rendere visibili gli elementi spaziali e gli stati visivi aggiornati, ma la loro utilit
- arXiv
- 2608.26993
- Pubblicato
- 2026-08-27
- Autori
- Hengyuan Xu, Wei Cheng, Yumeng Ji, Xuanyang Zhang, Xianfang Zeng, Gang Yu, Xingjun Ma
Abstract degli autori
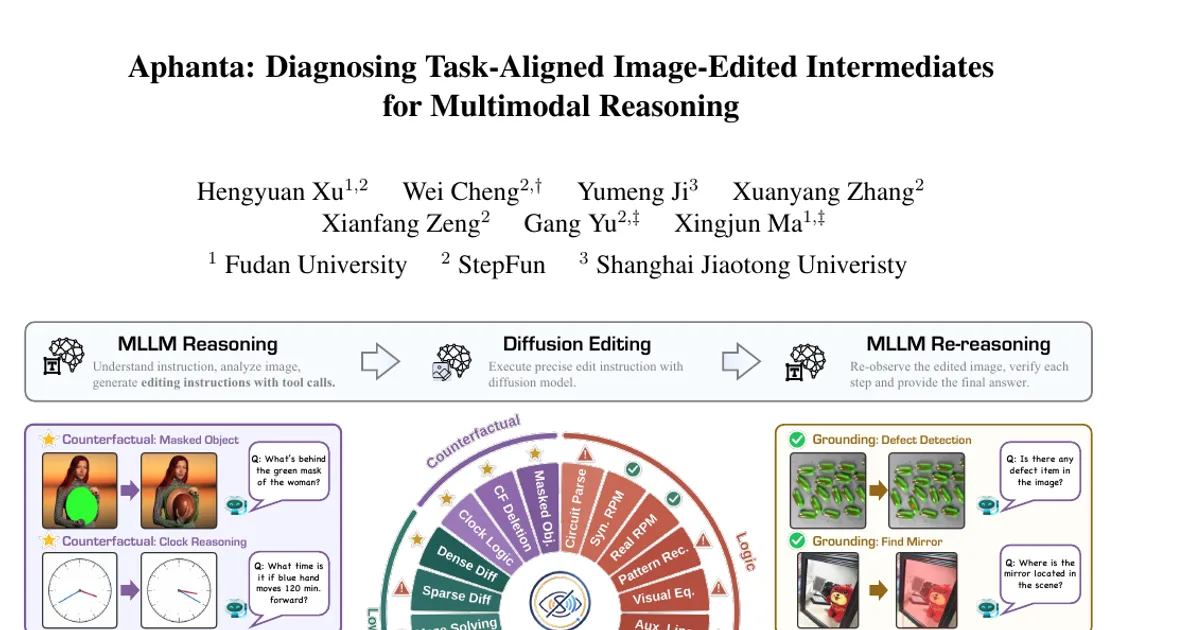
Le immagini intermedie esplicite possono aiutare i modelli linguistici multimodali di grandi dimensioni (MLLM) a rendere visibili gli elementi spaziali e gli stati visivi aggiornati, ma la loro utilità dipende dalla capacità di un editor di immagini di realizzare fedelmente la trasformazione richiesta. Presentiamo \textbf{Aphanta}, un framework di individuazione automatica dei compiti e diagnosi a ciclo chiuso per la pipeline MLLM -> editor di immagini -> MLLM. Aphanta valuta tre condizioni — ragionamento diretto, ragionamento con un’immagine intermedia generata da un editor e ragionamento con un’immagine intermedia di riferimento idealizzata — per distinguere il potenziale margine di miglioramento offerto dalle immagini dall’utilità pratica degli editor attuali. Su 20 compiti candidati e diverse combinazioni di editor e MLLM, riscontriamo che l’utilità dipende fortemente dal compito. I miglioramenti si concentrano nell’inserimento di indizi visivi, nell’ancoraggio e nella realizzazione di stati controfattuali, mentre le immagini intermedie che richiedono una costruzione sensibile ai simboli o un’estrapolazione strutturale sono molto meno affidabili. Nel sottoinsieme selezionato di compiti con esito positivo, la nostra pipeline Qwen consolidata porta il punteggio medio per compito da 0,343 a 0,445 ($+10.2$ punti; $+29.7\%$ in termini relativi), mentre lo studio completo include anche i compiti filtrati e quelli senza esito positivo, per mettere in luce i limiti di questo approccio. Questi risultati indicano che l’editing delle immagini è uno spazio di lavoro visivo specializzato, non un meccanismo di ragionamento universale, e fanno di Aphanta un protocollo riutilizzabile per misurare l’allineamento tra compito e rappresentazione, la capacità dell’editor di realizzare la trasformazione e l’utilità della pipeline nelle fasi successive.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv