Ricerca
AMLworld-Compact: sottocampionamento ponderato in base all’importanza per valutare gli LLM e diagnosticare gli errori a costi contenuti
Valutare i modelli linguistici di grandi dimensioni (LLM) sulle più piccole suddivisioni di test di AMLworld è costoso, perché ciascuno degli oltre un milione di elementi da valutare richiede un promp
- arXiv
- 2610.13627
- Pubblicato
- 2026-10-09
- Autori
- Natapong Nitarach, Phume Ngampornsukswadi, Pittawat Taveekitworachai, Surapon Nonesung, Warit Sirichotedumrong, Kunat Pipatanakul
Abstract degli autori
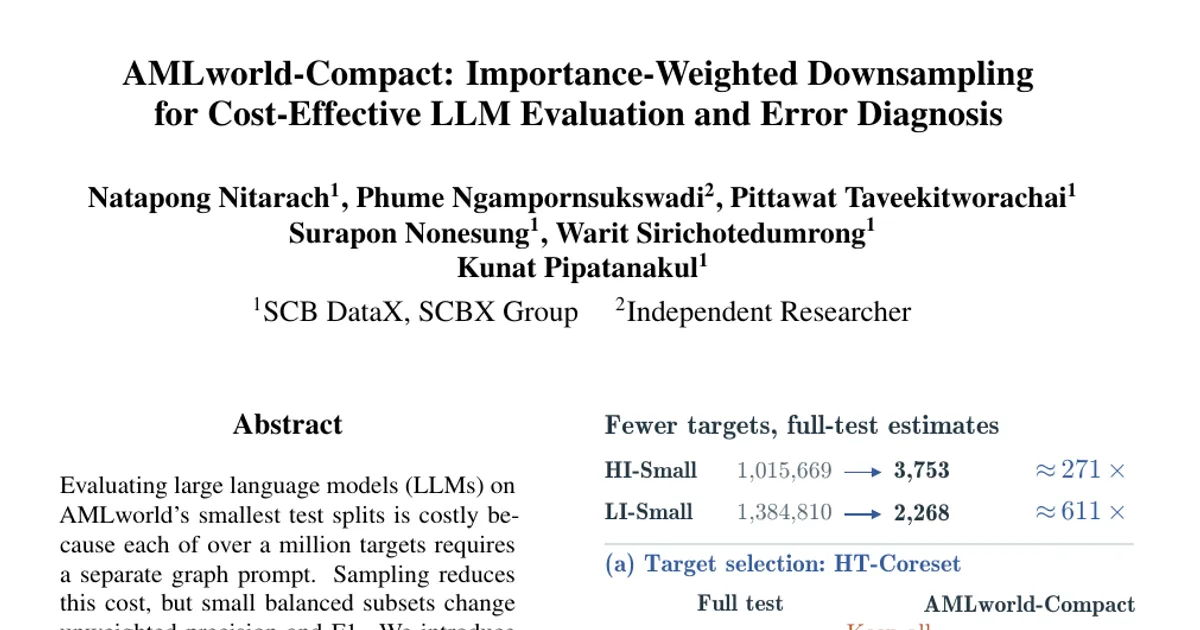
Valutare i modelli linguistici di grandi dimensioni (LLM) sulle più piccole suddivisioni di test di AMLworld è costoso, perché ciascuno degli oltre un milione di elementi da valutare richiede un prompt separato sul grafo. Il campionamento riduce questo costo, ma i piccoli sottoinsiemi bilanciati alterano la precisione e il punteggio F1 non ponderati. Presentiamo AMLworld-Compact, un set di valutazione che conserva tutte le transazioni illecite del test e campiona quelle non illecite da strati definiti da punteggi supervisionati. Il protocollo HT-Coreset riduce gli elementi da valutare rispettivamente di 271 e 611 volte su HI-Small e LI-Small. I pesi di Horvitz-Thompson forniscono stime non distorte dei conteggi della matrice di confusione sull’intero test per predizioni fissate; la recall è esatta, mentre la precisione e il punteggio F1 sono stime basate su rapporti. In uno studio su dati tenuti da parte che usa le caratteristiche di Graph Feature Preprocessor (GFP), una famiglia di alberi con boosting definisce gli strati per valutare l’altra, con 500 estrazioni per configurazione. Alle dimensioni pubblicate, la radice dell’errore quadratico medio (RMSE) del punteggio F1 è di 0,00-2,58 punti percentuali, contro 4,44-7,41 del campionamento uniforme con pesi HT; gli intervalli conservativi restano ampi. Con i prompt sul grafo valutati, sette LLM a pesi aperti hanno una precisione ponderata vicina al valore di riferimento ottenuto classificando tutte le transazioni come illecite. In una verifica stratificata in base all’esito di 1.000 output few-shot di HI-Small, ottenuti da un’esecuzione per modello, i controlli lessicali sono superati per l’84,5% dei verdetti binari corretti e il 56,2% di quelli errati: questi indicatori non dimostrano quindi la correttezza dei verdetti. Pubblichiamo i set di valutazione, il codice per costruirli e gli strumenti di verifica all’indirizzo https://huggingface.co/datasets/typhoon-ai/AMLworldCompactEval e https://github.com/nat-nischw/AMLworld-Compact.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv