Ricerca
Tutte le modalità sono uguali, ma il video è più uguale: colmare il divario di cross-attention nella generazione congiunta di video
Il video è una rappresentazione ricca di un evento fisico, che ne cattura l’aspetto, la geometria, il movimento e l’evoluzione temporale. Altre modalità, come il movimento corporeo 3D o l’audio, codif
- arXiv
- 2609.27901
- Pubblicato
- 2026-09-23
- Autori
- Ohad Rahamim, Dvir Samuel, Idan Schwartz, Gal Chechik
Abstract degli autori
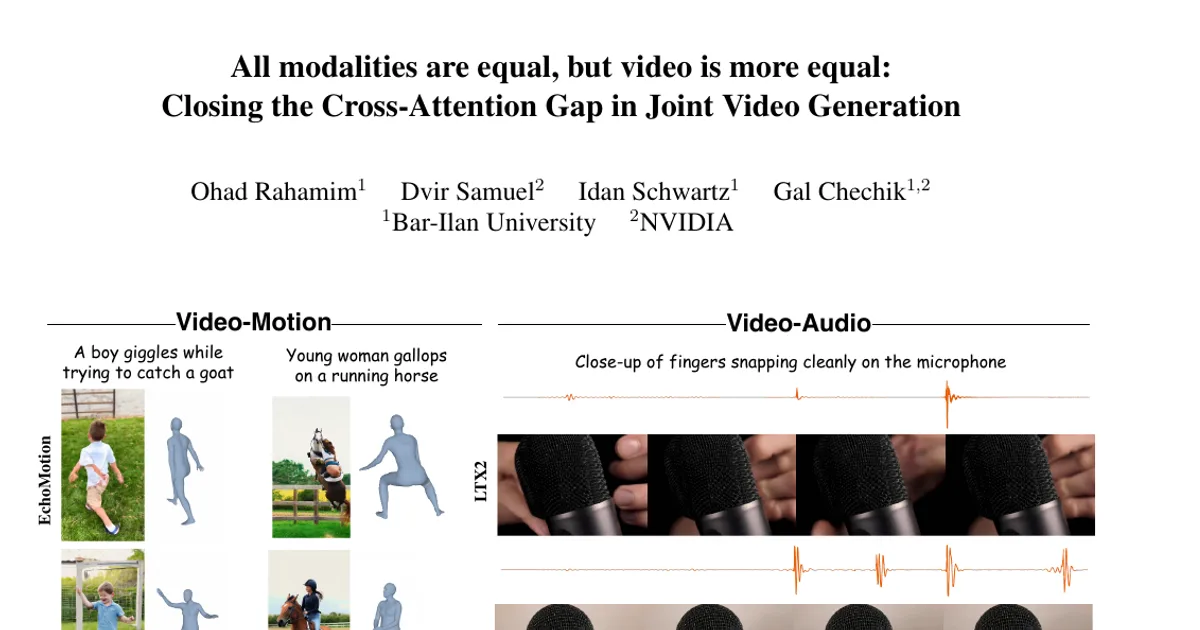
Il video è una rappresentazione ricca di un evento fisico, che ne cattura l’aspetto, la geometria, il movimento e l’evoluzione temporale. Altre modalità, come il movimento corporeo 3D o l’audio, codificano aspetti più circoscritti dello stesso evento. Abbiamo riscontrato che i transformer di diffusione multimodali congiunti presentano un’asimmetria corrispondente nella corrispondenza tra modalità: le modalità complementari sviluppano forti corrispondenze con il video, ma le corrispondenze reciproche, attraverso le quali vincolano il video, restano considerevolmente più deboli. Esprimiamo entrambe le direzioni come distribuzioni di corrispondenza comparabili sui token video e definiamo la loro divergenza come divario di corrispondenza reciproca. Introduciamo RecCAR, acronimo di Reciprocal Cross-modal Attention Regularization, un regolarizzatore KL che usa come riferimento fisso la corrispondenza consolidata dal video alla modalità e allinea a essa la più debole corrispondenza dalla modalità al video. Nella generazione congiunta di video e movimento e di video e audio, RecCAR porta il punteggio Human Anatomy da 0,69 a 0,75 e riduce la desincronizzazione audio-video da 0,804 a 0,752, migliorando al contempo la generazione complessiva
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv