Ricerca
AgentVQA: un benchmark unificato per la comprensione visiva degli agenti
I modelli visione-linguaggio (VLM) possono svolgere un’ampia gamma di compiti in contesti diversi, ma le loro prestazioni nei contesti in cui operano come agenti restano poco comprese. Le valutazioni
- arXiv
- 2610.31494
- Pubblicato
- 2026-10-22
- Autori
- Advait Gupta, Sachin Konan, Tom Yin, Gabriel Sarch, Zhuang Liu
Abstract degli autori
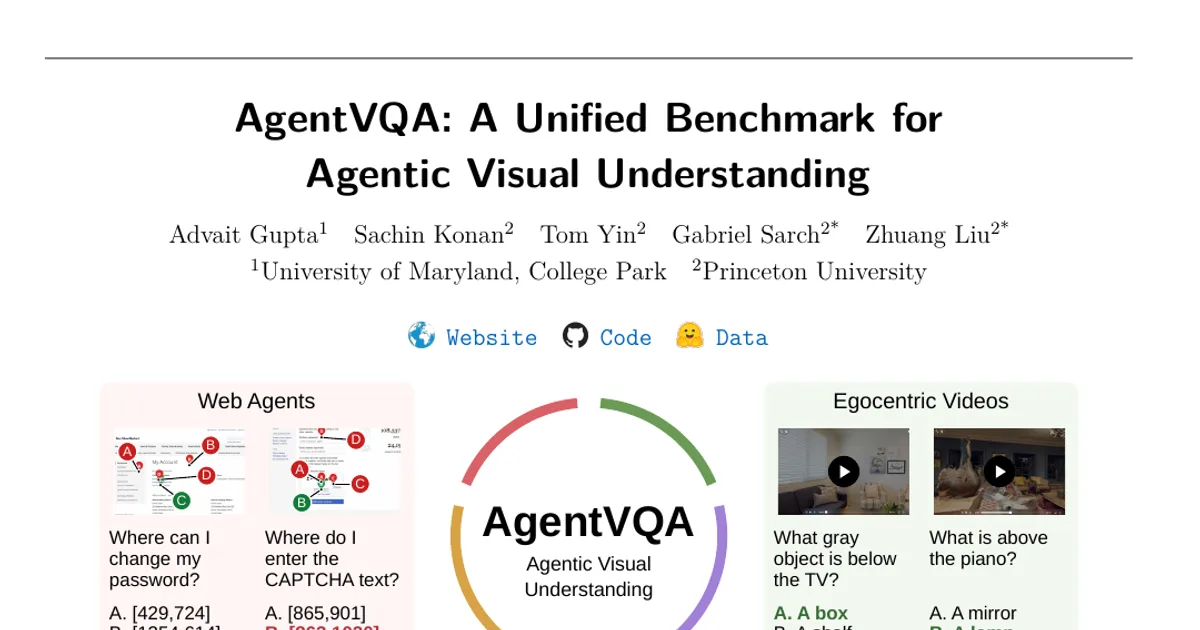
I modelli visione-linguaggio (VLM) possono svolgere un’ampia gamma di compiti in contesti diversi, ma le loro prestazioni nei contesti in cui operano come agenti restano poco comprese. Le valutazioni online nei simulatori e negli ambienti reali sono essenziali per misurare le prestazioni degli agenti interattivi, ma sono costose e difficili da estendere su larga scala. I benchmark VQA offline, complementari a queste valutazioni, possono consentire confronti più rapidi e affidabili tra diversi ambiti di applicazione degli agenti; quelli esistenti, tuttavia, restano limitati e frammentati. Per colmare questa lacuna, presentiamo AgentVQA, un benchmark offline per valutare i VLM in scenari realistici relativi a cinque ambiti: agenti web, robotica, video egocentrici, giochi e pianificazione spaziale. Abbiamo costruito AgentVQA selezionando manualmente 1.000 esempi complessi di agenti tratti dal mondo reale, provenienti da 23 dataset di origine, e adattandoli per una valutazione offline affidabile. Il benchmark risultante conserva scenari realistici provenienti da ambienti interattivi in ambiti diversi, e le classifiche dei modelli sono in linea con quelle delle corrispondenti valutazioni online. Tra i 22 modelli valutati, il migliore raggiunge un’accuratezza di appena il 58,5%. La nostra analisi trasversale ai diversi ambiti mostra che gli errori derivano principalmente dalla difficoltà di ancorare a quanto osservato rappresentazioni accurate dello stato visivo attuale e della sua evoluzione, e di mantenerle: per esempio, nel localizzare elementi pertinenti dell’interfaccia utente, interpretare il movimento, seguire i cambiamenti di stato nel tempo e dedurre le relazioni spaziali 3D. Pesano invece meno l’errata interpretazione del compito e il successivo ragionamento logico.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv