Ricerca
AEON: unificare i modelli del mondo basati su video e 3D
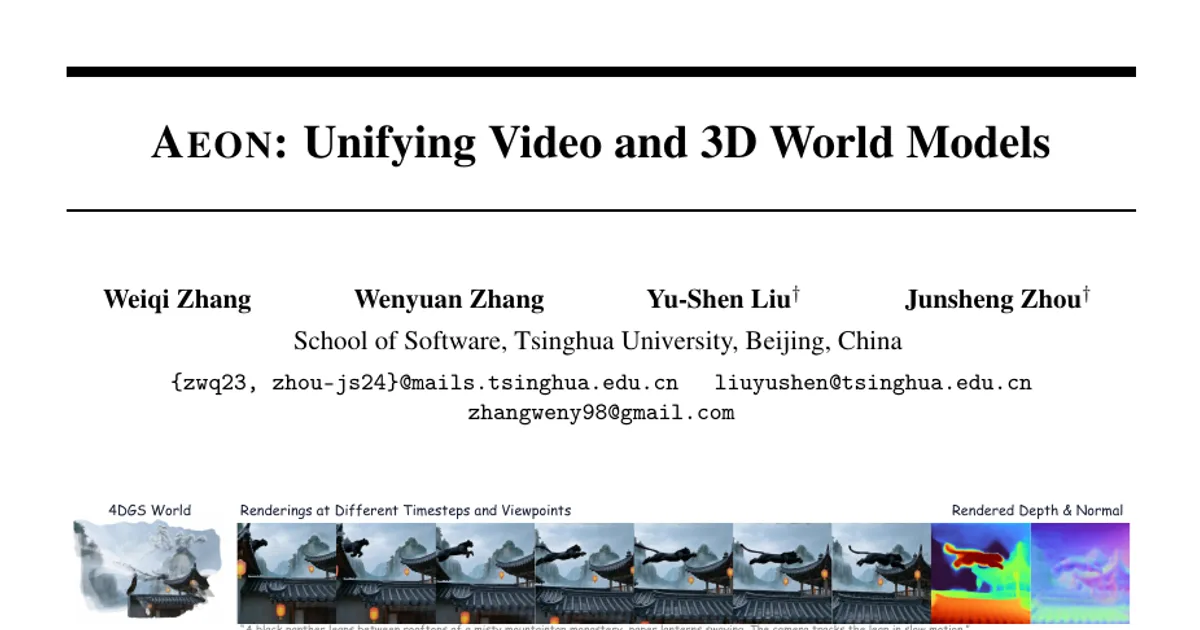
Gli attuali modelli del mondo per la simulazione esplicita seguono in genere due approcci distinti: (1) i modelli generativi video (per esempio Sora), che simulano aspetti realistici ma non mantengono
- arXiv
- 2610.28631
- Pubblicato
- 2026-10-20
- Autori
- Weiqi Zhang, Wenyuan Zhang, Yu-Shen Liu, Junsheng Zhou
Abstract degli autori
Gli attuali modelli del mondo per la simulazione esplicita seguono in genere due approcci distinti: (1) i modelli generativi video (per esempio Sora), che simulano aspetti realistici ma non mantengono la coerenza 3D; e (2) i modelli generativi 3D (per esempio Marble), che generano scene geometricamente coerenti ma spesso producono osservazioni statiche e meno realistiche. Presentiamo AEON, un framework unificato che collega i modelli del mondo basati su video e quelli basati su 3D, combinando i vantaggi di entrambi. L’idea chiave di AEON è un modello generativo che opera nello spazio latente video condizionato da testo o immagini e produce primitive grafiche 4D renderizzabili, nello specifico 4D Gaussian Splatting (4DGS), come rappresentazione esplicita del mondo. Addestriamo un modello di ricostruzione 4D a prevedere sia 4DGS sia le pose della telecamera a partire da video monoculari; questo modello funge da decoder 4D inizializzato. Progettiamo inoltre un adattatore di dominio che traduce le rappresentazioni latenti dei video generativi in rappresentazioni latenti 4D ricostruttive attraverso un processo di distillazione applicato al VAE video. AEON supporta in modo naturale la modellazione del mondo basata su video tramite il rendering di 4DGS lungo le traiettorie previste della telecamera e costruisce un ambiente 4D persistente, con dinamiche della scena, per una simulazione realistica del mondo. AEON consente così un’ampia gamma di applicazioni nella modellazione del mondo e raggiunge prestazioni allo stato dell’arte sui benchmark standard. Pagina del progetto: https://weiqi-zhang.github.io/AEON
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv