Ricerca
Acquisire, correggere, preservare: una procedura di post-addestramento guidata dalla diagnosi per agenti basati su piccoli modelli nei giochi di dialogo
I giochi di dialogo interattivi mettono alla prova una capacità che i benchmark statici lasciano perlopiù implicita: un modello deve mantenere lo stato da un turno all’altro, interpretare il feedback
- arXiv
- 2608.28458
- Pubblicato
- 2026-08-28
- Autori
- Nan Li
Abstract degli autori
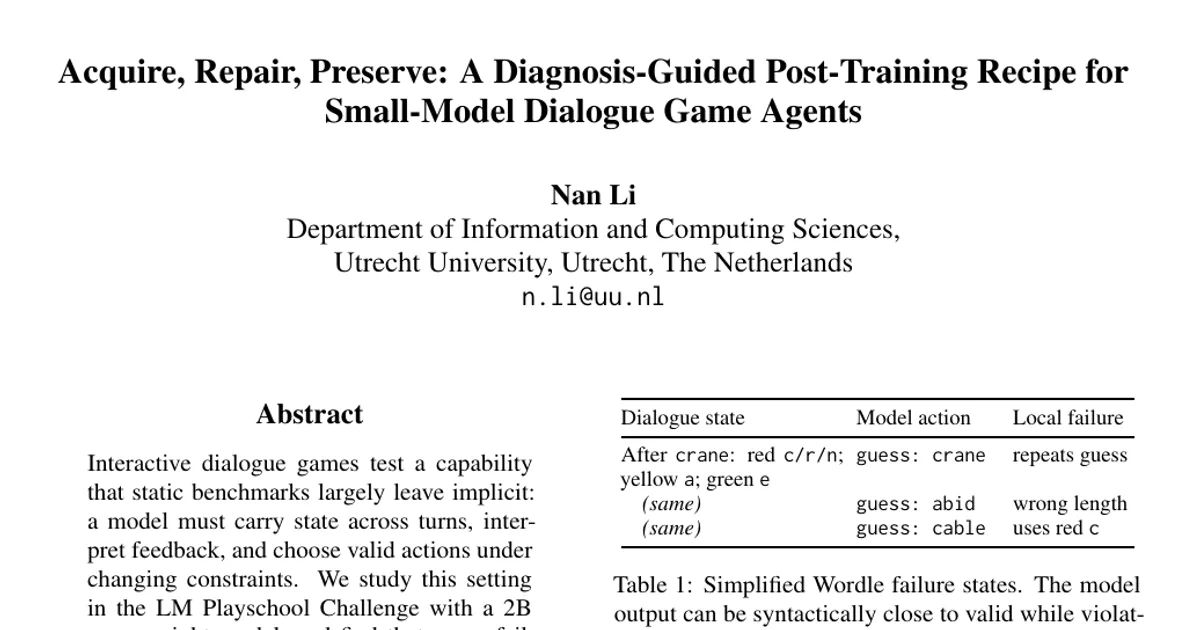
I giochi di dialogo interattivi mettono alla prova una capacità che i benchmark statici lasciano perlopiù implicita: un modello deve mantenere lo stato da un turno all’altro, interpretare il feedback e scegliere azioni valide al variare dei vincoli. Studiamo questo contesto nella LM Playschool Challenge con un modello 2B a pesi aperti e riscontriamo che molti errori non dipendono soltanto da lacune generali nelle conoscenze, ma anche da decisioni sbagliate a livello locale: tentativi ripetuti, azioni formulate in modo non valido e violazioni delle indicazioni contenute nel feedback che il modello ha appena visto. Queste osservazioni motivano una procedura di addestramento articolata in tre passaggi: acquisire la capacità di partecipare a un’ampia gamma di giochi mediante fine-tuning supervisionato, correggere gli errori verificabili meccanicamente all’interno di una specifica famiglia di giochi di dialogo usando coppie di preferenze relative ai singoli turni e preservare le capacità generali al di là di questi giochi di dialogo. Nella valutazione finale ufficiale, il nostro modello presentato porta il clemscore pubblico da 10,67 a 38,92 e il punteggio in-domain della valutazione chiusa da 13,41 a 41,17, mantenendo pressoché invariate le prestazioni statiche aggregate (44,14 contro 44,24 del modello di riferimento). Il clemscore out-of-domain resta basso, a 7,88, e i miglioramenti maggiori si concentrano in varianti mai viste della famiglia presa di mira. I nostri risultati suggeriscono che gran parte del miglioramento delle capacità del modello derivi dal fine-tuning supervisionato su un’ampia gamma di giochi; la supervisione a livello di singolo turno può essere efficace quando l’individuazione degli errori è precisa, ma il trasferimento osservato si concentra soprattutto all’interno della stessa famiglia.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv