The Pulse
Ricercatori di Meta e Oxford presentano il modello del mondo OverSeer
Ricercatori affiliati a Meta AI e all’Università di Oxford hanno presentato OverSeer, un modello del mondo video multi-agente, in un articolo scientifico inviato il 20 ottobre. Il sistema aggiunge viste di telecamere ausiliarie fisse per ai
AI.info Team · Scritto con l’IA · verificato ·
«Mostriamo che queste viste fisse aiutano notevolmente il modello a mantenere la coerenza».
Runjia Li et al., «OverSeer: Multi-Agent World Models Beyond What Agents See»
Ricercatori affiliati a Meta AI e all’Università di Oxford descrivono OverSeer, un modello del mondo video progettato per mantenere allineate le prospettive di più agenti su un ambiente condiviso. L’articolo scientifico è stato inviato ad arXiv il 20 ottobre. Anziché assegnare a ogni agente un modello del mondo separato, OverSeer genera i loro flussi video in prima persona insieme alle viste di telecamere collocate in posizioni fisse.
Questa prospettiva stabile affronta un punto debole specifico delle simulazioni multi-agente: un agente può lasciare un’area mentre un altro vi modifica qualcosa, e la vista successiva del primo agente potrebbe non riflettere ciò che è accaduto. I ricercatori hanno testato il sistema in Minecraft e Doom, aggiungendo esempi qualitativi tratti da video multicamera del mondo reale. I risultati suggeriscono che le viste fisse possono aiutare a preservare i dettagli delle scene condivise, anche se le prestazioni dipendono dalle aree coperte dalle telecamere.
Le telecamere fisse offrono a OverSeer un riferimento condiviso
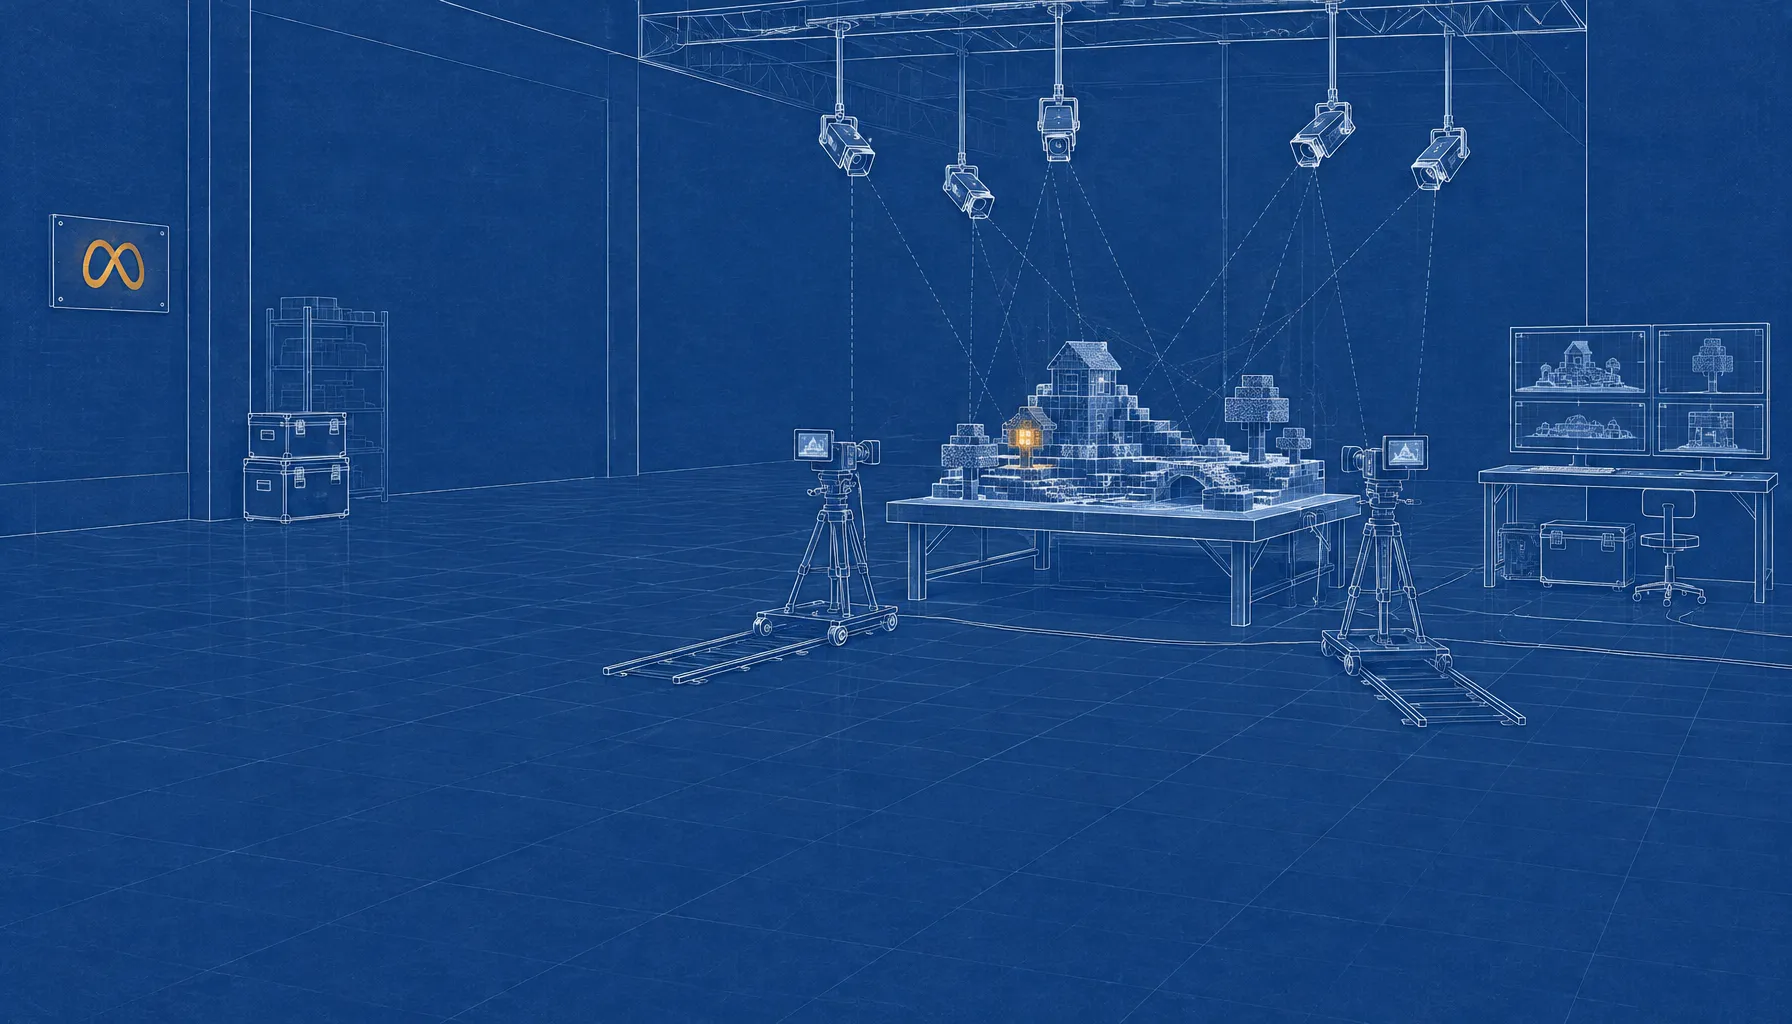
In OverSeer, le telecamere degli agenti si muovono insieme a loro, quindi le immagini cambiano anche quando l’ambiente non cambia. Le telecamere ausiliarie rimangono in posizioni fisse. Il modello genera le loro viste insieme ai video degli agenti, usandole come riferimento persistente per i cambiamenti nell’ambiente e per gli eventi fuori dal campo visivo immediato di un agente.
I ricercatori hanno costruito il sistema a partire dal modello video Wan2.2-TI2V-5B. Per ridurre il costo dell’aggiunta delle viste ausiliarie, hanno sviluppato una delta-VAE che memorizza un’immagine iniziale di riferimento e codifica i cambiamenti successivi rispetto a essa. Secondo l’articolo, sei viste ausiliarie richiedono un sovraccarico in token pari al 37,5% di quello dei flussi video dei due agenti.
I ricongiungimenti rivelano il divario di coerenza
Il Multi-Agent Consistency Benchmark del gruppo verifica se agenti separati riescono a ricongiungersi nel posto giusto e se le scene conservano i cambiamenti avvenuti fuori dall’inquadratura. In Minecraft, OverSeer ha raggiunto un’accuratezza del 60,2% in «Reunite at Start», del 37,9% in «Reunite Far» e del 40,5% in un compito relativo a eventi dinamici. I due sistemi usati per il confronto hanno ottenuto lo 0% o il 6,2% in questi compiti, a seconda del sistema di riferimento e del compito.
I risultati non sono stati migliori in tutti i casi. Nel benchmark Solaris, OverSeer ha ottenuto i risultati migliori per grounding, memoria e coerenza, ma è rimasto indietro rispetto al miglior sistema di riferimento nei compiti di movimento e costruzione, che l’articolo descrive come più dipendenti da viste in prima persona su un orizzonte temporale breve. La valutazione ha considerato in media 32 episodi per ciascun compito in Minecraft e 100 episodi per ciascun compito in Doom.
La compressione riduce il sovraccarico a scapito dei dettagli
A una risoluzione di 576 per 384, la delta-VAE riduce la rappresentazione delle viste ausiliarie da 864 a 108 token per fotogramma, una riduzione di otto volte. Eliminare la compressione ha migliorato alcuni punteggi relativi alla qualità visiva e alla coerenza in Doom, ma ha richiesto un numero di token ausiliari otto volte maggiore. Secondo gli autori, questo compromesso varia in base all’ambiente: i rapidi cambiamenti dell’illuminazione e dei nemici in Doom producono aggiornamenti residui più ampi rispetto alle scene a blocchi di Minecraft, che cambiano più lentamente.
L’articolo individua anche nella copertura un limite. Le aree lontane dalle telecamere fisse restano più difficili da mantenere coerenti e, secondo gli autori, le viste ausiliarie non apportano benefici al movimento su un orizzonte temporale breve. I loro test dimostrano un risultato di ricerca in due giochi e in una selezione di esempi video del mondo reale, non un simulatore generico; estendere la copertura ad aree inesplorate e a gruppi più grandi di agenti resta un obiettivo per lavori futuri.