The Pulse
GPT-6 Astra guida una Corolla; Claude e Grok non completano il percorso
Tre ingegneri di Axiom hanno messo GPT-6 Astra, Claude Fable 5.1 e Grok ai comandi di una Toyota Corolla. Astra ha completato un semplice percorso in un parcheggio, mentre Claude e Grok ne hanno percorso solo una parte.
AI.info Team · Scritto con l’IA ·
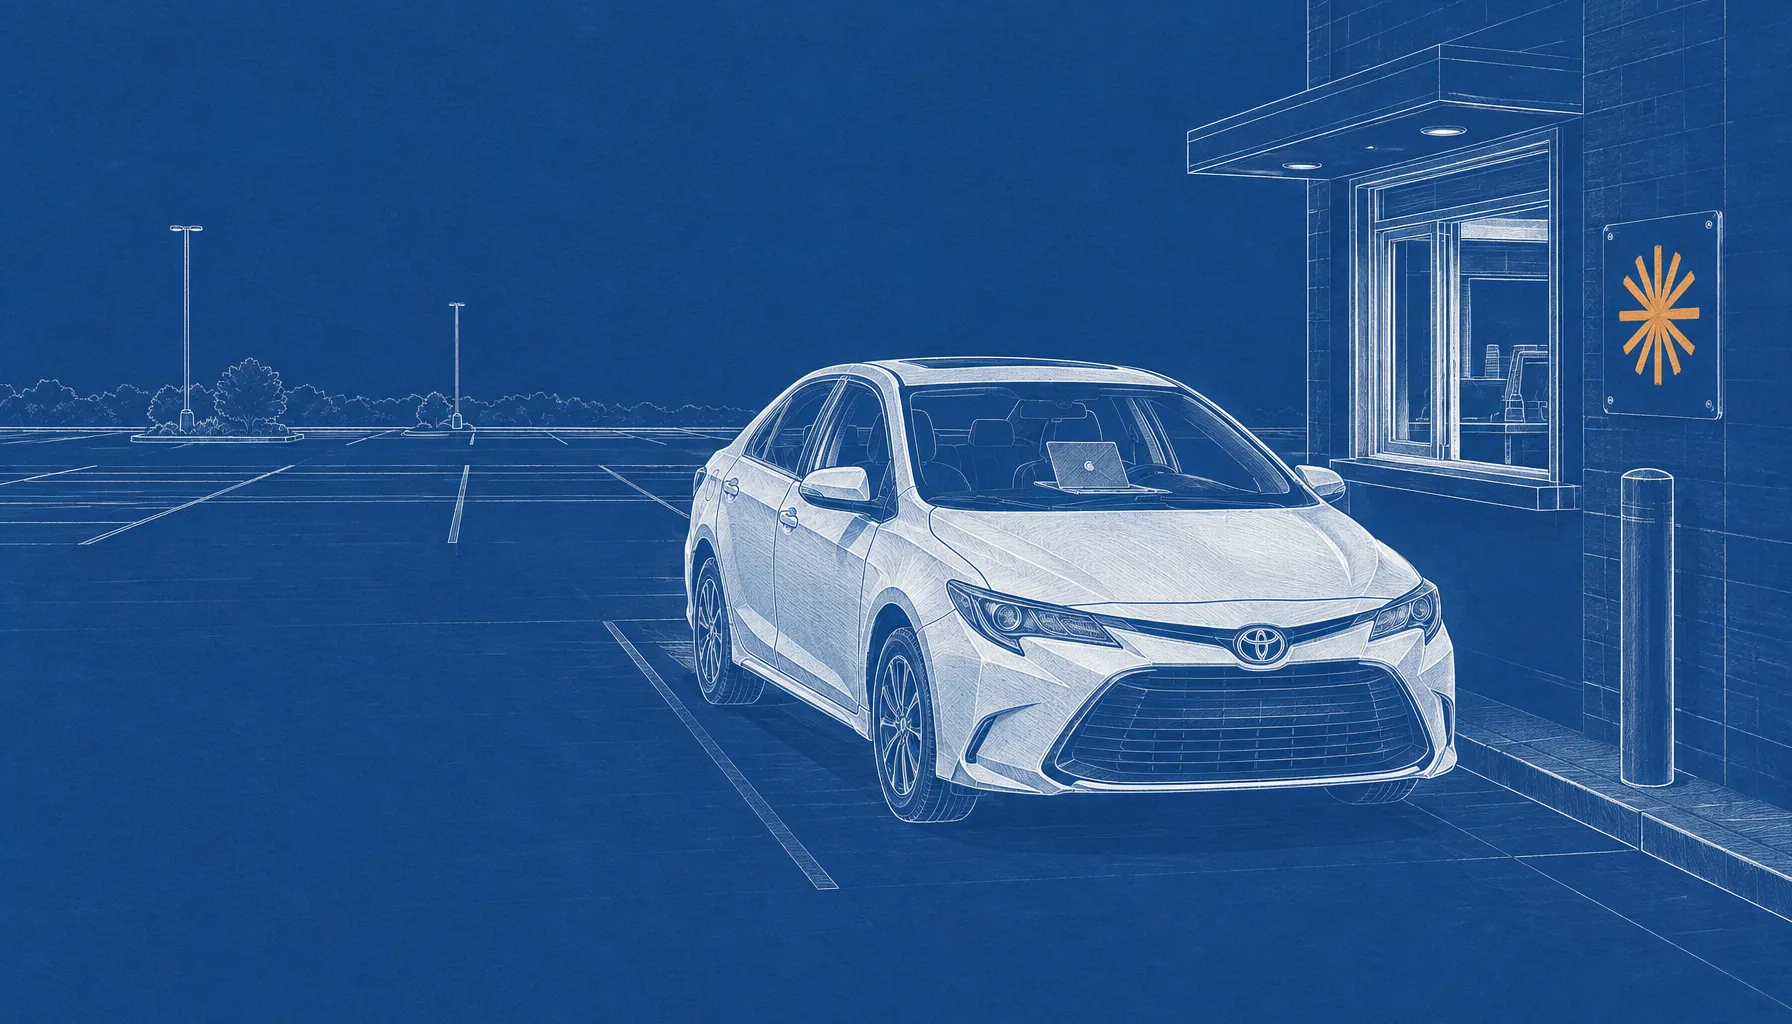
In un articolo pubblicato da WIRED il 7 ottobre, tre ingegneri hanno raccontato di aver usato GPT-6 Astra di OpenAI per guidare una Toyota Corolla del 2024 attraverso il drive-through di un In-N-Out vicino alla Bay Area. Un portatile collegava il modello a telecamere montate sul parabrezza e al servosterzo dell’auto; un conducente incaricato della sicurezza teneva il piede pronto sul freno. Astra ha portato l’auto fino alla finestra per il ritiro, dove gli ingegneri hanno preso il pranzo.
Una prova al drive-through, non un’auto senza conducente
L’esperimento è stato condotto da Aditya Ramabadran, Simon Mahns e Tobias Gessler, ingegneri di IA della startup Axiom. Secondo WIRED, hanno realizzato il progetto al di fuori del loro lavoro, dopo essersi chiesti se modelli capaci di costruire complesse simulazioni 3D potessero anche orientarsi nel mondo reale. L’auto non viaggiava senza una persona pronta a intervenire: il conducente incaricato della sicurezza poteva farlo se il modello avesse sbagliato.
La distinzione è importante. La prova non ha dimostrato che un chatbot generalista possa sostituire un sistema di guida autonoma costruito e addestrato appositamente per la circolazione stradale. Ha mostrato che un modello progettato per elaborare testo e immagini poteva, una volta collegato a telecamere e sterzo, prendere le decisioni necessarie a condurre un’auto lungo un unico percorso circoscritto.
Astra ha completato il percorso; Claude e Grok no
Gli ingegneri hanno valutato i modelli anche con DrivingBench, un benchmark da loro costruito attorno a un semplice percorso in un parcheggio. GPT-6 Astra è stato l’unico modello a completarlo, e lo ha fatto lentamente. Claude Fable 5.1 di Anthropic ha percorso il 45 per cento del tracciato; Grok l’11 per cento.
Questi risultati ridimensionano la portata della visita al fast food: arrivare con successo a un drive-through non dimostra di saper guidare in modo affidabile su strade diverse, nel traffico o in presenza di pericoli. Il benchmark suggerisce che i modelli siano ancora ben lontani dal superare persino una semplice prova di guida. La sperimentazione, inoltre, si è svolta con un conducente incaricato della sicurezza, anziché verificare se un’auto potesse circolare in sicurezza senza intervento umano.
I prompt hanno aiutato i modelli a superare il rifiuto iniziale
Il gruppo ha provato prima Grok di SpaceXAI, poi modelli più recenti di OpenAI e Anthropic. Inizialmente i sistemi si rifiutavano di controllare i veicoli, rispondendo per esempio: «Posso aiutare a interpretare le immagini della strada, ma non posso impartire comandi di movimento a un’auto reale». Gli ingegneri hanno scoperto che, formulando i prompt con attenzione, potevano indurli a fare di più.
Questo non dimostra che le aziende abbiano addestrato i modelli a guidare. Gli ingegneri hanno detto a WIRED di sospettare che questa capacità derivasse da un addestramento finalizzato al ragionamento spaziale, anziché da istruzioni specifiche sulla guida. Mahns l’ha descritta come una possibile «capacità emergente» dovuta al crescente addestramento multimodale, che può includere immagini, video e modelli 3D.
Il controllo nel mondo reale pone un’altra questione di sicurezza
Il significato del progetto sta meno nella meta scelta per il pranzo che nel collegamento tra l’output del modello e un veicolo in movimento. Un modello può sbagliare nell’interpretare una scena o nello scegliere un’azione; quando il suo output arriva allo sterzo, quegli errori possono avere conseguenze fisiche. WIRED ha riferito che durante il tragitto non è successo nulla di allarmante, ma gli ingegneri hanno riconosciuto la posta in gioco nell’affidare a un modello generalista il controllo di un’auto che procede a velocità elevata.
Ramabadran ha detto che i modelli sembravano imparare dagli errori mentre controllavano il veicolo: «I modelli sembravano davvero correggersi o apprendere nel contesto sulla base dei propri errori, imparando a gestire meglio i comandi», ha detto a WIRED. Questa osservazione descrive l’impressione del gruppo durante la prova, non dimostra una capacità di guida affidabile. Per ora, il risultato più chiaro è la differenza emersa dal benchmark: Astra ha completato il percorso nel parcheggio, Claude è arrivato al 45 per cento e Grok all’11 per cento.