The Pulse
StateBench di Ai2 rileva che tenere traccia delle informazioni nei contesti lunghi mette ancora in difficoltà i modelli
Il benchmark StateBench di Ai2 rileva che i modelli di frontiera faticano nei compiti più difficili di tracciamento dello stato man mano che gli input crescono, mentre i modelli ricorrenti e ibridi generalizzano più a lungo quando vengono a
AI.info Team · Scritto con l’IA · verificato ·
Secondo Ai2, i modelli ricorrenti e ibridi possono generalizzare su sequenze molto più lunghe dei transformer quando vengono addestrati direttamente su StateBench, mentre i modelli di frontiera continuano a incontrare difficoltà nei problemi di tracciamento più complessi man mano che gli input crescono. Il divario è più marcato quando un compito richiede di tenere conto dei cambiamenti nel tempo, anziché individuare l’ultimo aggiornamento. Ai2 ha presentato StateBench il 3 novembre 2026 come benchmark per misurare come i modelli tengono traccia delle informazioni che cambiano all’interno di documenti lunghi.
«Tenere traccia dello stato del mondo attraverso un contesto lungo è necessario per comprendere discorsi, documenti e codice.»
Questa frase è degli autori dello studio, Jackson Petty, William Merrill e Ashish Sabharwal.
Quattro tipi di aggiornamento, dai valori fissi agli scambi
StateBench suddivide il tracciamento dello stato in quattro livelli, ciascuno dei quali consente modifiche più complesse alle variabili. I compiti r-trivial usano assegnazioni immutabili: un modello deve recuperare un valore che non cambia mai. I compiti aperiodici consentono di riassegnare una variabile, in modo che il valore più recente sostituisca quelli precedenti.
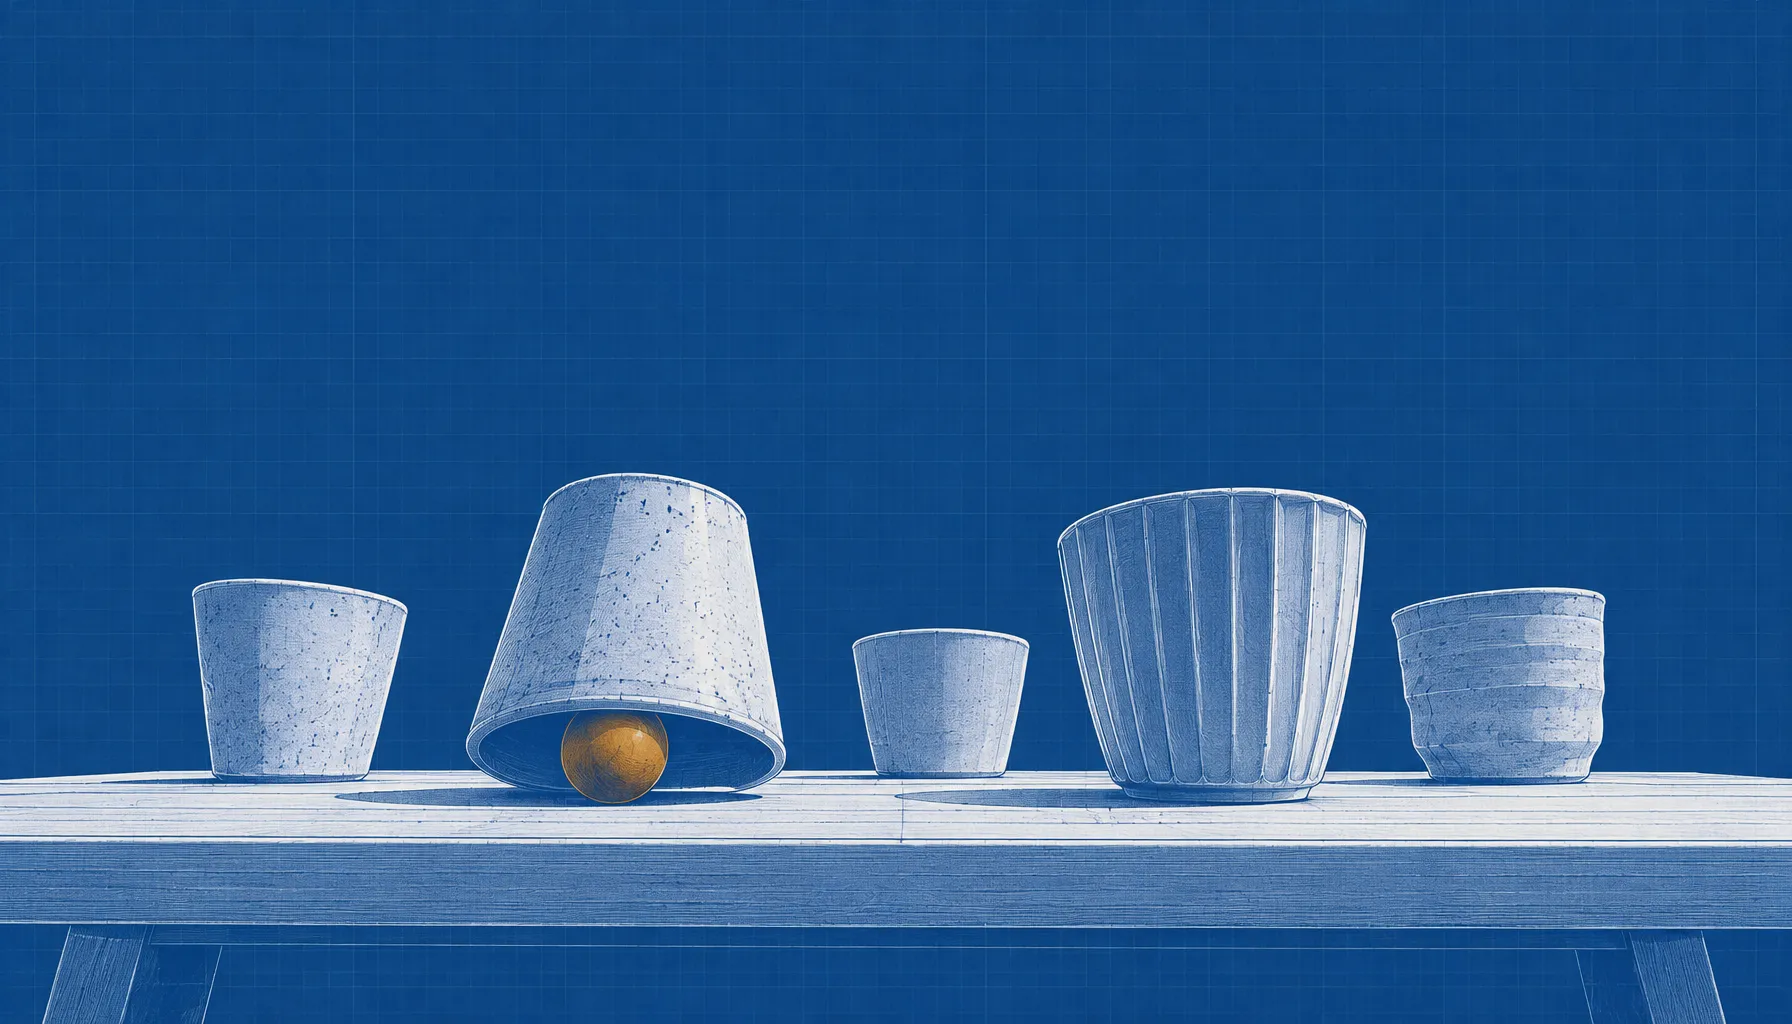
I compiti risolubili aggiungono aggiornamenti autoreferenziali, nei quali ogni nuovo valore dipende da quello corrente, come nel caso di un punteggio progressivo. I compiti finiti generali consentono a una variabile di assumere il valore corrente di un’altra, creando dipendenze tra gli aggiornamenti. Ai2 paragona questo livello, il più difficile, al compito di tenere traccia di come scambi ripetuti ridispongono gli oggetti sotto cinque bicchieri.
Per rendere comparabili i livelli, Ai2 ricava tre versioni più semplici da una sequenza finita generale. Le versioni mantengono lo stesso numero di variabili e di valori distinti, con assegnazioni negli stessi punti; cambia solo il tipo di assegnazione. StateBench presenta inoltre gli stessi problemi di fondo in più formati, perché il formato stesso ha influito sui punteggi dei modelli.
I modelli aperti preaddestrati hanno faticato nei compiti più difficili
Ai2 ha testato modelli aperti preaddestrati su compiti r-trivial, aperiodici e finiti generali. Il gruppo comprendeva il transformer Olmo 3 da 7 miliardi di parametri e Olmo Hybrid, che aggiunge livelli Gated DeltaNet, oltre a modelli più piccoli con 275 milioni e 2,7 miliardi di parametri. Nessuno era stato preaddestrato su contesti più lunghi di 64.000 token e Ai2 ha testato la maggior parte di essi su input ancora più lunghi.
Quasi tutti i modelli preaddestrati hanno ottenuto buoni risultati nei compiti r-trivial, hanno perso accuratezza nei compiti aperiodici man mano che gli input crescevano e hanno ottenuto risultati non superiori a quelli casuali nei problemi finiti generali. Il formato ha fatto la differenza: i modelli ibridi e Gated DeltaNet da 275 milioni di parametri hanno ottenuto punteggi vicini al massimo nei problemi r-trivial in stile RULER, ma vicini a quelli casuali quando gli stessi compiti erano presentati come modifiche a fogli di calcolo.
I modelli di frontiera sono scesi al 13% o meno nei problemi finiti generali più lunghi
Ai2 ha valutato anche Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna. Tutti e quattro hanno ottenuto buoni risultati nei problemi r-trivial e aperiodici, ma la loro accuratezza è calata nei compiti risolubili e finiti generali man mano che gli input si allungavano. Nei problemi finiti generali più lunghi, l’accuratezza è scesa al 13% o meno.
L’addestramento diretto ha ampliato il divario tra le architetture
Per verificare se la debolezza dipendesse dall’architettura o dal preaddestramento, Ai2 ha addestrato da zero su StateBench modelli da 275 milioni di parametri. Il gruppo comprendeva due varianti di transformer, due modelli ibridi e due varianti Gated DeltaNet. Le sequenze di addestramento arrivavano a 256 assegnazioni; quelle di valutazione si estendevano fino a 64.000 assegnazioni, 250 volte la sequenza di addestramento più lunga.
Con l’aumentare della lunghezza delle sequenze di test, i modelli Gated DeltaNet e ibridi hanno generalizzato quasi perfettamente nei compiti r-trivial, aperiodici e risolubili fino a decine di migliaia di assegnazioni. I transformer hanno appreso i livelli più semplici ma hanno peggiorato le proprie prestazioni sulle sequenze più lunghe e non hanno appreso i problemi finiti generali. A quel livello, il più difficile, la variante Gated DeltaNet con un aggiornamento della memoria più flessibile ha mantenuto prestazioni quasi perfette fino a circa 10 volte la sua sequenza di addestramento più lunga.
Il divario dipendeva anche dall’addestramento: secondo Ai2, i modelli ricorrenti e ibridi addestrati direttamente hanno appreso livelli che le loro controparti preaddestrate non erano riuscite ad apprendere. I transformer hanno continuato a fallire nel livello più difficile anche dopo l’addestramento diretto.
StateBench presuppone ancora un insieme fisso di variabili
Ai2 afferma che la sua dimostrazione per Gated DeltaNet con autovalori non negativi copre tutti i compiti aperiodici e alcuni compiti periodici, tra cui il tracciamento del numero pari o dispari di occorrenze di un input ripetuto, usando un’aritmetica a precisione fissa con arrotondamento. La posizione esatta dell’architettura nella gerarchia resta aperta, così come la questione se possa risolvere tutti i compiti risolubili e come la precisione numerica o i livelli di attenzione influiscano sulle sue capacità.
Il benchmark presuppone inoltre un numero fisso di variabili, mentre le conversazioni reali possono introdurre nuove persone e nuovi oggetti che un modello deve iniziare a tracciare. Ai2 afferma che il suo attuale quadro di riferimento non copre questa situazione. Per il momento, StateBench isola una questione più circoscritta: quanto bene i modelli seguono i cambiamenti di stato quando le entità e la sequenza di aggiornamenti sono definite.