Trasformazione dei settori
La città alimentata dall’IA: come le infrastrutture urbane vengono riprogettate per l’intelligenza artificiale
Semafori che imparano, sensori fognari che si ripagano da soli e un sistema di rilevamento degli spari per cui Chicago ha speso più di 33 milioni di dollari e che non ha ancora sostituito: che cosa ha davvero prodotto l’IA nelle infrastrutt
AI.info Team ·
Le città sono sempre state problemi infrastrutturali travestiti da luoghi in cui vivere: tubature, cavi, semafori e orari sovrapposti gli uni agli altri, progettati perlopiù decenni prima che qualcuno immaginasse una telecamera capace di contare le auto o un modello capace di prevedere un guasto alla rete idrica. Negli ultimi anni non è cambiato il fatto che le città siano diventate improvvisamente intelligenti: è che i sistemi di rilevamento sono diventati abbastanza economici, e i modelli abbastanza efficaci, perché l’IA prenda ormai, senza dare nell’occhio, decisioni su come scorre il traffico, come circolano gli autobus, come si muove l’acqua e chi viene segnalato alla polizia. In parte funziona. In parte ha già prodotto fallimenti clamorosi e ben documentati. Entrambi gli aspetti contano.
Il semaforo che impara
La forma più matura di infrastruttura urbana basata sull’IA è anche la meno appariscente: la regolazione dei tempi semaforici. Per gran parte del Novecento, gli ingegneri fissavano i cicli dei semafori sulla base di rilevazioni del traffico effettuate una volta e raramente aggiornate. Due progetti hanno cercato di sostituire questo sistema con un controllo continuo e adattivo.
Surtrac, sviluppato al Robotics Institute della Carnegie Mellon University, è in funzione a Pittsburgh dal 2012. Anziché affidare a un computer centrale l’ottimizzazione di un’intera rete, ogni incrocio esegue il proprio modello locale e comunica agli incroci vicini i flussi in uscita previsti, così che l’intero corridoio si adatti quasi in tempo reale.
La prima installazione nell’East End di Pittsburgh ha ridotto i tempi di percorrenza del 25% e i tempi di attesa di oltre il 40%, con un calo delle emissioni di circa il 21%, secondo le valutazioni pubblicate dal Department of Transportation e i rapporti sul progetto della stessa Carnegie Mellon. Da allora la città ha ottenuto circa 20 milioni di dollari di finanziamenti federali e statali per estendere Surtrac da circa 50 incroci verso quota 200.
| Installazione | Località | Risultato |
|---|---|---|
| Semafori adattivi Surtrac | Pittsburgh | Tempi di percorrenza ridotti del 25%, tempi di attesa ridotti di oltre il 40% |
| Project Green Light | Disponibile in oltre 100 città nel mondo | Fino al 30% di fermate in meno, fino al 10% di emissioni in meno (potenziale, secondo Google) |
| Manutenzione predittiva di SBS Transit | Singapore | Calo di circa il 20% dei guasti agli autobus |
| Sensori fognari di South Bend | South Bend, Indiana | Riduzione di circa il 70% degli sversamenti fognari |
| Rilevamento delle perdite di HOFOR | Copenaghen | Riduzione di circa il 50% dei tempi di riparazione |
Project Green Light di Google adotta un’architettura diversa: invece di controllare direttamente i semafori, analizza i dati di guida di Google Maps per modellare l’andamento delle fermate e delle ripartenze agli incroci e fornisce agli ingegneri del traffico comunali indicazioni specifiche sui tempi semaforici. Sono poi gli ingegneri stessi a decidere se applicarle. La scelta di mantenere una persona nel processo decisionale è deliberata: le città non vogliono affidare il controllo dei semafori alla scatola nera di un’azienda privata e Google, scottata da altre disavventure nel campo delle smart city, sembra aver imparato la lezione.
Green Light è ora disponibile in più di 100 città, da Haifa e Kolkata a Hamburg, Boston, Bangkok, Bengaluru e Manchester. Google segnala riduzioni potenziali fino al 30% delle fermate e fino al 10% delle emissioni di gas serra agli incroci ottimizzati, su un volume che stima fino a 47 milioni di tragitti in auto al mese. Boston è il caso di applicazione più esteso in una singola città: 114 incroci ottimizzati in 20 quartieri, dove è stata la città — non Google — a segnalare una riduzione media del 20% delle fermate non necessarie e del 13,5% dei ritardi.
La maggior parte di queste cifre è pubblicata da Google stessa, anziché verificata in modo indipendente. Ma il meccanismo alla base — l’impiego di dati telemetrici di Maps anonimizzati e aggregati, già disponibili su enorme scala — è più verificabile di gran parte delle affermazioni sulle smart city, dato che i dati sul traffico esistono da molto prima di questa applicazione dell’IA.
I due progetti hanno in comune la modestia delle ambizioni. Nessuno dei due sostiene di risolvere la congestione del traffico; entrambi rivendicano miglioramenti marginali e misurabili nelle emissioni e nei ritardi a incroci specifici. È un utile punto di riferimento per valutare il resto delle promesse sull’IA nelle città, perché gran parte di ciò che segue promette molto di più e offre molte meno certezze.
Autobus, guasti e il problema dei mezzi che si accodano
Le aziende di trasporto pubblico affrontano con l’IA un problema più circoscritto e gestibile rispetto agli ingegneri del traffico: possiedono già i veicoli, gli orari e i registri di manutenzione, quindi fare previsioni è soprattutto una questione di dati, più che di fisica. SBS Transit, a Singapore, ha introdotto un sistema di manutenzione predittiva basato sull’IA su circa 1.000 autobus, usando i dati dei sensori e dei registri degli interventi per segnalare i probabili malfunzionamenti prima che causino guasti; dopo l’introduzione del sistema, l’operatore ha riferito un calo di circa il 20% dei guasti agli autobus. È un’affermazione sensibilmente diversa da quelle di gran parte del marketing sull’IA nel trasporto pubblico: riguarda un indicatore operativo, i guasti per flotta, non una stima delle emissioni previste.
L’altro problema ricorrente del trasporto pubblico — gli autobus della stessa linea che finiscono per accodarsi, perché un ritardo all’inizio del percorso si propaga — è una questione di ottimizzazione degli orari a cui il machine learning si presta abbastanza bene. Adeguare quasi in tempo reale le decisioni sulle partenze e sulle soste, invece di attenersi a un orario fisso, può ridurre la variabilità dei tempi di attesa senza aggiungere autobus alla flotta.
Una ricerca di Deloitte sul settore del trasporto pubblico ha rilevato che circa il 70% delle aziende prevede di aumentare gli investimenti nell’IA nei prossimi tre anni, soprattutto nella manutenzione predittiva e nell’ottimizzazione delle partenze, non in soluzioni che somiglino alla guida autonoma. È un’IA poco appariscente, impiegata nelle attività interne — più vicina alle previsioni di inventario che alla versione della smart city popolata da robot umanoidi — ma è anche una delle poche categorie per cui esistono dati operativi verificabili prima e dopo l’introduzione, invece delle proiezioni dei fornitori.
Le reti invisibili: acqua ed elettricità
Le aziende del servizio idrico sono diventate, senza fare rumore, una delle storie infrastrutturali legate all’IA di maggior successo. Il motivo principale è che la tecnologia di rilevamento su cui si basano — il rilevamento acustico delle perdite — precede l’IA, mentre il livello di machine learning svolge un compito circoscritto e ben definito: distinguere il suono di una perdita dal rumore di fondo. South Bend, in Indiana, alle prese con un ammodernamento della rete fognaria imposto dalle autorità e dal costo di oltre 700 milioni di dollari, ha installato uno Smart Sewer System con più di 150 sensori e valvole mobili intelligenti per dirigere il flusso delle acque reflue, riducendo gli sversamenti fognari di circa il 70%.
Missoula, nel Montana, ha installato sensori acustici sugli idranti lungo 340 miglia di condotte e, durante una fase pilota, ha individuato più di una dozzina di perdite che altrimenti sarebbero rimaste inosservate per mesi. HOFOR, l’azienda dei servizi idrici di Copenaghen, usa reti di sensori simili per valutare la gravità delle perdite e localizzarle, e riferisce di aver ridotto i tempi di riparazione di circa la metà.
Nessuno di questi è un progetto visionario di IA: sono problemi di classificazione di schemi affrontati aggiungendo tecnologia a infrastrutture che le aziende avrebbero comunque dovuto dotare di sensori. Probabilmente è per questo che hanno prodotto alcuni dei dati più concreti e verificabili dell’intero settore.
La rete elettrica è un caso più intricato, perché qui la storia dell’IA è ormai intrecciata con l’impennata della domanda di elettricità della stessa industria dell’IA. Nell’aprile 2025 PJM Interconnection, il gestore della rete regionale che serve un’ampia parte della costa medio-atlantica e del Midwest, ha annunciato una collaborazione con Google per applicare strumenti di Google Cloud e DeepMind a uno dei peggiori colli di bottiglia della rete: la coda pluriennale delle richieste di connessione di nuovi impianti di produzione elettrica, soprattutto da fonti rinnovabili, in attesa di valutazione tecnica.
La promessa è che l’IA possa accelerare le pratiche e la modellizzazione che oggi tengono i progetti solari e di accumulo a batteria in coda per anni. È un’applicazione reale, ma presenta anche un’ironia un po’ scomoda: la stessa industria i cui data center mettono sotto pressione la capacità della rete ora vende ai gestori gli strumenti per alleggerire quella pressione.
Ora, finalmente, c’è un ciclo su cui valutarla: il primo periodo di presentazione delle domande nell’ambito della procedura riformata di PJM per la connessione alla rete si è chiuso il 27 aprile 2026 con 811 progetti per un totale di circa 220 GW. A guidare la lista sono 106 GW di generazione a gas e 67 GW di accumulo, contro 15 GW di solare e 5 GW di eolico: non proprio la storia di uno sblocco delle rinnovabili con cui era stata presentata la collaborazione. Tapestry, il progetto visionario di Google X alla base dello strumento, ha pubblicato i propri dati nel giugno 2026: la documentazione relativa al controllo dei siti per quelle domande è stata esaminata in un tempo mediano di sei minuti e quindici secondi, con il 99% delle verifiche completato entro un’ora. È una selezione dei documenti misurata dal fornitore, non un’approvazione ottenuta più rapidamente.
Quando le telecamere diventano il centro della controversia
Non tutte le installazioni di infrastrutture di IA reggono alla prova del confronto con il pubblico. Il caso più istruttivo è quello di ShotSpotter, oggi venduto dalla società madre SoundThinking, a Chicago. Il sistema di rilevamento acustico degli spari usava una rete di microfoni e una classificazione automatica per segnalare alla polizia presunti colpi d’arma da fuoco. L’azienda dichiarava un’accuratezza di circa il 97%.
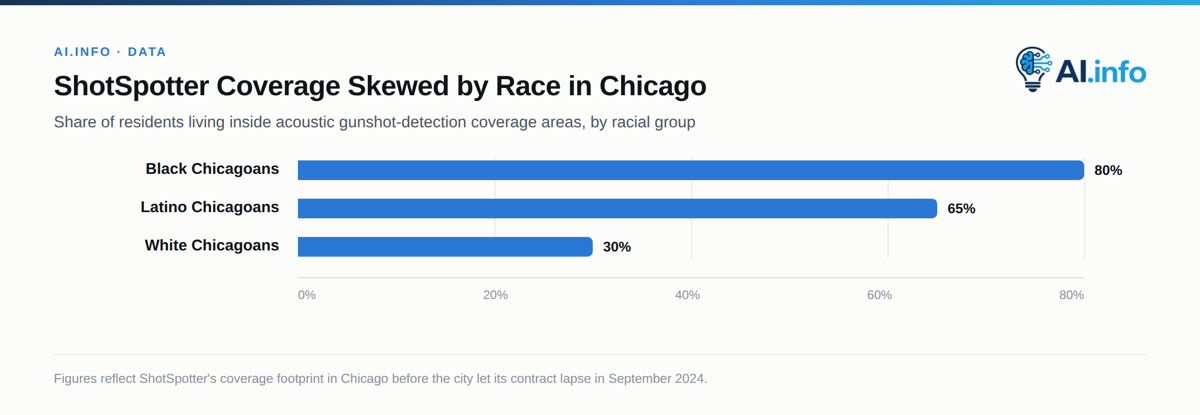
Le verifiche indipendenti hanno raccontato una storia molto diversa: uno studio del MacArthur Justice Center ha rilevato che, nell’arco di 21 mesi, l’89% degli interventi attivati da ShotSpotter non ha portato alla scoperta di alcun reato legato alle armi da fuoco. L’Office of Inspector General di Chicago ha confermato che il sistema generava ogni anno decine di migliaia di interventi della polizia che non portavano a nulla. La copertura, inoltre, era concentrata quasi interamente nelle zone sud e ovest della città: circa l’80% dei residenti neri di Chicago e il 65% di quelli latinoamericani vivevano nelle aree coperte, contro circa il 30% dei residenti bianchi.
Il sindaco Brandon Johnson ha deciso di non rinnovare il contratto, scaduto nel settembre 2024. Nell’agosto 2025 la città ha accettato di chiudere con un accordo una causa collettiva riguardante la tecnologia, riconoscendo che una segnalazione, da sola, non giustifica un fermo di polizia. La lezione non è che il rilevamento acustico sia intrinsecamente sbagliato: è che il tasso di accuratezza pubblicizzato per un sistema non significa nulla se non si sa che cosa venga conteggiato come vero positivo. Nel caso di ShotSpotter, quella determinazione dipendeva dalla compilazione volontaria, da parte della polizia, di documenti che gli agenti avevano ogni incentivo a non compilare.
Il conto ha continuato ad arrivare anche dopo la scadenza del contratto. Nel marzo 2026 un giudice federale ha approvato un accordo da 500.000 dollari per Michael Williams, che aveva trascorso quasi un anno in carcere con un’accusa di omicidio basata in gran parte su una segnalazione di ShotSpotter, prima che i procuratori abbandonassero il caso nel luglio 2021. SoundThinking ha ribadito la posizione che sostiene da tempo: ShotSpotter identifica gli spari, non le persone, e le decisioni sulle accuse spettano alla polizia e ai procuratori. È vero, ed è per questo che la percentuale di accuratezza non è mai stata il dato che contava.
Chicago, peraltro, non ha sostituito il sistema. Nove fornitori hanno risposto alla richiesta di offerte della città nel corso del 2025, ma a giugno 2026 non era ancora stato assegnato alcun contratto. L’ufficio appalti ha spiegato al consiglio comunale che un contratto di questa complessità richiede normalmente circa due anni, il che collocherebbe l’assegnazione all’inizio del 2027. Annullare un contratto per un sistema di sorveglianza si rivela molto più rapido che decidere che cosa debba prenderne il posto.
Il riconoscimento facciale ha seguito una traiettoria simile, anche se prima e più esplicitamente attraverso la legislazione. Nel maggio 2019 San Francisco è stata la prima città degli Stati Uniti a vietarne l’uso da parte dell’amministrazione comunale. Oakland e Somerville, nel Massachusetts, l’hanno seguita nel giro di poche settimane e, all’inizio degli anni 2020, più di una dozzina di città aveva introdotto qualche forma di divieto, tra cui Boston, Portland e New Orleans.
Ma dopo il 2021 il movimento a favore dei divieti non si è semplicemente fermato: ha invertito la rotta. Nel luglio 2022 New Orleans ha attenuato il divieto introdotto nel 2020, consentendo alla polizia di richiedere l’uso del riconoscimento facciale per le indagini sui crimini violenti. Nel febbraio 2025 Jackson, nel Mississippi, ha abrogato all’unanimità il divieto del 2020 su richiesta del capo della polizia, sostituendolo con l’obbligo di ottenere un’autorizzazione e con un organismo civile di supervisione. Un’inchiesta del Washington Post del 2024 ha inoltre rilevato che, sia ad Austin sia a San Francisco, città in cui i divieti erano in vigore, la polizia chiedeva abitualmente ad agenti di giurisdizioni prive di restrizioni di effettuare ricerche con il riconoscimento facciale per suo conto. Vietare l’uso dei sistemi di una città serve a poco se basta affidare la ricerca alla contea vicina, e serve ancora meno se il consiglio comunale che ha approvato il divieto può votare per eliminarlo.
| Città | Provvedimento adottato |
|---|---|
| San Francisco | Prima città degli Stati Uniti a vietare l’uso del riconoscimento facciale da parte dell’amministrazione comunale (maggio 2019) |
| Oakland | Ha introdotto il divieto poche settimane dopo San Francisco |
| Somerville, MA | Ha introdotto il divieto poche settimane dopo San Francisco |
| Boston, Portland | Tra le oltre 12 città con divieti all’inizio degli anni 2020 |
| New Orleans | Ha introdotto il divieto nel 2020, poi parzialmente attenuato con un voto del consiglio comunale nel luglio 2022 |
| Jackson, MS | Ha introdotto il divieto nel 2020, poi abrogato all’unanimità nel febbraio 2025 |
La smart city che non è mai stata costruita
Se c’è una vicenda con cui confrontare ogni proposta sull’IA applicata alle città, è il progetto Quayside di Sidewalk Labs a Toronto. Nel 2017 la società controllata di Alphabet dedicata all’innovazione urbana ha vinto una gara per riqualificare circa 12 acri del lungolago di Toronto, realizzando quello che veniva presentato come uno dei quartieri con più sensori al mondo: pavimentazione riscaldata, edifici modulari, consegne autonome e una raccolta capillare di dati destinata a ottimizzare ogni cosa, dal traffico alla raccolta dei rifiuti.
Il progetto è naufragato nel maggio 2020. La motivazione ufficiale è stata l’incertezza economica senza precedenti legata alla pandemia. Ma già nei due anni precedenti il progetto aveva perso credibilità, prima che il COVID gli offrisse una via d’uscita che salvasse le apparenze. Ann Cavoukian, ex commissaria per la tutela della privacy dell’Ontario assunta da Sidewalk come consulente per la privacy, si è dimessa nell’ottobre 2018 dopo che l’azienda si era rifiutata di impegnarsi a rimuovere gli elementi identificativi dai dati dei sensori al momento della raccolta. Proponeva invece un trust civico per i dati che avrebbe deciso in seguito quali tecnologie potessero conservare dati identificabili.
Sidewalk ha anche ampliato le proprie ambizioni a progetto in corso, arrivando a proporre, a un certo punto, un’area 16 volte più vasta di quella originaria. Ai residenti e ai funzionari di Toronto è parso un allargamento del progetto da parte di un’azienda che non si era ancora guadagnata la loro fiducia sul piano iniziale, molto più modesto.
Quayside è la prova più chiara che la parte più difficile di una città basata sull’IA non è la modellazione: è la questione di governance, cioè a chi appartengano i dati generati da un quartiere dotato di sensori. Nessuna soluzione ingegneristica, per quanto sofisticata, può rimediare a un progetto incapace di rispondere in modo convincente a questa domanda.
Gemelli digitali: strumento di pianificazione o fantasia pianificatoria
Il progetto Virtual Singapore è il tentativo più maturo di costruire un gemello digitale di un’intera città: un modello 3D ricco di dati che integra edifici, infrastrutture e dati ambientali, avviato nel 2014 e dichiarato completato nel 2022. A differenza di Quayside, è nato dalla collaborazione tra la National Research Foundation, la Singapore Land Authority e la Government Technology Agency (GovTech), con il coinvolgimento anche della società francese di software Dassault Systèmes: una struttura che evita molte delle preoccupazioni sulla proprietà dei dati che hanno fatto naufragare Sidewalk Labs.
Chi si occupa di pianificazione lo usa per simulare scenari — nuove linee di trasporto pubblico, risposta alle inondazioni, potenziale solare dei tetti — prima di impegnare capitali. Più di recente, Singapore ha annunciato l’intenzione di estendere questo approccio al sottosuolo, costruendo un gemello digitale sotterraneo per gestire le infrastrutture interrate dei servizi pubblici che una città densamente popolata e con poco spazio a disposizione deve far passare sotto tutto il resto.
Il limite dei gemelli digitali, in generale, è che una simulazione vale quanto le ipotesi su cui si basa. Le città che hanno cercato di importare in blocco il modello di Singapore hanno perlopiù scoperto che i suoi vantaggi — un unico governo dotato di un’autorità insolitamente centralizzata su territorio, servizi pubblici e dati, oltre a decenni di investimenti costanti — non sono facilmente trasferibili a un’area metropolitana americana frammentata, con decine di enti dalle competenze sovrapposte e nessun organismo che controlli sia i semafori sia le condotte idriche principali.
Che cosa mostra davvero questo schema
Mettendo in fila questi casi, emerge uno schema meno entusiasmante di quanto suggerisca l’idea della città alimentata dall’IA, ma più utile. Le applicazioni con i risultati più chiari e verificabili — Surtrac, Green Light, le reti di sensori per le perdite d’acqua, la manutenzione predittiva dei trasporti di Singapore — hanno due caratteristiche in comune: lavorano su un segnale circoscritto e ben definito (flusso del traffico, tracce acustiche delle perdite, dati dei sensori dei veicoli) e lasciano a una persona la decisione finale, che si tratti di un ingegnere del traffico che mette in pratica una proposta di regolazione dei tempi semaforici o di una squadra di manutenzione inviata per un guasto previsto dal sistema.
Le applicazioni che sono fallite — ShotSpotter, Quayside — avevano le caratteristiche opposte: segnali ampi e ambigui (un rumore che potrebbe essere uno sparo, dati sui comportamenti di un intero quartiere) associati a conseguenze per la vita delle persone. Dove funziona davvero, la città alimentata dall’IA somiglia meno alla sala di controllo di un film di fantascienza e più a un impianto idraulico migliore: sensori, modelli e dashboard che rendono i processi burocratici esistenti un po’ più reattivi.
Dove ha fallito, le ragioni avevano meno a che fare con gli algoritmi e più con chi poteva decidere come usare i dati e con la possibilità, per qualcuno al di fuori del fornitore, di verificare i calcoli.