Trasformazione dei settori
La corsa all’IA sovrana: perché ogni Paese vuole un proprio modello di base
Mistral valutata 21 miliardi di euro, l’India che punta a 200.000 GPU e un modello nazionale saudita basato su pesi aperti cinesi: che cosa comprano davvero i Paesi quando acquistano IA sovrana, e che cosa resta concesso in licenza altrove.
AI.info Team ·
Un termine reso popolare da Nvidia, e un conto che ora i Paesi stanno pagando
«IA sovrana» è nata come espressione di marketing. Nvidia l’ha resa popolare qualche anno fa per descrivere la capacità di un Paese di produrre intelligenza artificiale usando le proprie infrastrutture, i propri dati e la propria forza lavoro: modelli addestrati sulle lingue e sul contesto culturale locali, eseguiti su hardware fisicamente situato entro i confini nazionali e soggetti alle leggi del Paese anziché alle condizioni di servizio di un fornitore di servizi cloud straniero. Non per caso, era anche un ottimo modo per vendere GPU a ministeri delle Finanze che non avevano mai acquistato un data center.
L’espressione ha attecchito perché dava un nome a qualcosa di reale. Entro il 2025, capi di Stato, fondi sovrani e operatori storici delle telecomunicazioni di oltre una dozzina di Paesi partecipavano alla conferenza GTC di Nvidia per parlare delle loro strategie nazionali per l’IA, e Jensen Huang ha dedicato loro un intero programma, il «Sovereign AI Summit».
Per un periodo Nvidia ha riportato l’IA sovrana come voce distinta e ha dichiarato che il fatturato di questa attività era più che triplicato rispetto all’anno precedente, superando i 30 miliardi di dollari nell’esercizio fiscale 2026. Da allora, la cifra in dollari ha lasciato il posto a un tasso di crescita. I risultati del trimestre chiuso il 26 luglio 2026, comunicati un mese dopo, indicano ricavi per 96,2 miliardi di dollari e ricavi dei data center per 89,0 miliardi di dollari, senza una voce dedicata all’IA sovrana. Nella presentazione dei risultati, il direttore finanziario ha detto che questa attività, svolta principalmente tramite neocloud regionali, «è cresciuta del 35% rispetto al trimestre precedente ed è più che triplicata rispetto all’anno precedente nel secondo trimestre». Lo stesso comunicato afferma che la società «non include nelle proprie previsioni alcun ricavo dalla capacità di calcolo dei data center in Cina»: una precisazione che descrive il tema meglio di qualsiasi intervento a un summit.
A spingere questa corsa è una preoccupazione autentica, non solo l’enfasi dei fornitori. I governi hanno visto l’ondata dell’IA generativa arrivare quasi interamente da una manciata di laboratori americani — OpenAI, Google, Anthropic, Meta — seguita da vicino da una contro-ondata cinese guidata da DeepSeek, Alibaba e altri. Nessuno dei due schieramenti addestra i propri modelli principalmente in hindi, arabo, giapponese, coreano o nelle undici lingue ufficiali del Sud-est asiatico. Nessuno dei due risponde pienamente al regime di licenze per l’esportazione, alle leggi sulla protezione dei dati o alle norme sugli appalti di un governo straniero.
Per un Paese che si aspetta di vedere l’IA nei propri ospedali, tribunali, uffici delle imposte e forze armate entro un decennio, «useremo semplicemente il miglior modello americano o cinese disponibile» non è una politica: è un’esposizione al rischio. Così una coalizione insolitamente ampia di Stati, dalle monarchie del Golfo alle repubbliche europee alle democrazie dell’Asia orientale, è arrivata indipendentemente alla stessa conclusione: servono modelli di base propri, capacità di calcolo propria e, possibilmente, chip propri.
La scommessa del Golfo sull’intera filiera
Nessuna regione si è mossa più in fretta o ha speso in modo più visibile del Golfo. Il Technology Innovation Institute (TII) degli Emirati Arabi Uniti, un ente di ricerca governativo con sede ad Abu Dhabi, sviluppa la famiglia di modelli linguistici a pesi aperti Falcon dal 2023 e nel maggio 2025 ha rilasciato Falcon Arabic — il primo modello in lingua araba della serie Falcon, che secondo il TII supera gli altri modelli arabi disponibili nella regione nella Open Arabic LLM Leaderboard — insieme a Falcon H1, un’architettura più efficiente progettata per funzionare bene su hardware dalle risorse modeste.
Il TII fa parte di un ecosistema più ampio imperniato su G42, il conglomerato di Abu Dhabi attivo nell’IA le cui controllate operano nelle infrastrutture cloud, nell’IA per la sanità e nella tecnologia spaziale. G42 è diventato il principale strumento degli Emirati Arabi Uniti per la diplomazia dell’IA con Washington.
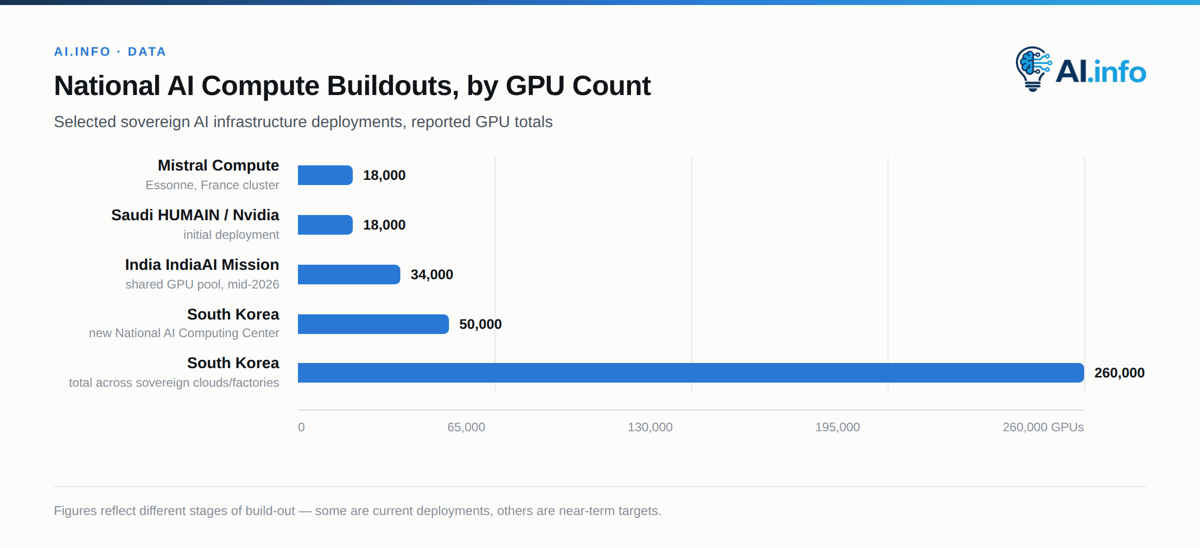
L’Arabia Saudita ha scelto una strada ancora più dispendiosa in termini di capitale. HUMAIN, società del Public Investment Fund presieduto dal principe ereditario Mohammed bin Salman, è stata lanciata nel maggio 2025 con un mandato che comprende data center, cloud, modelli e applicazioni. La sua prima partnership con Nvidia prevede un’installazione iniziale di 18.000 sistemi GB300 Grace Blackwell, destinata a crescere fino a diverse centinaia di migliaia di GPU e a una capacità prevista fino a 500 megawatt nell’arco di cinque anni. A questa si affianca un accordo separato per consentire alla Saudi Data & AI Authority di installare fino a 5.000 GPU Blackwell per una fabbrica nazionale di IA e applicazioni per le città intelligenti.
È fondamentale notare che nulla di tutto questo avviene senza il via libera di Washington: secondo quanto riportato, le autorizzazioni statunitensi all’esportazione per HUMAIN consentono acquisti equivalenti a un massimo di 35.000 chip della classe GB300, subordinati a condizioni di sicurezza e rendicontazione. È un promemoria del fatto che, nel Golfo, la capacità di calcolo «sovrana» resta una sovranità concessa su licenza da una potenza esterna.
Il modello di HUMAIN è arrivato il 3 settembre 2026. humain-m3, presentato come modello linguistico arabo di frontiera in anteprima per la ricerca, è stato sviluppato da MiniMax — un laboratorio cinese — sulla base del suo M3. Il principale attore nazionale saudita nell’IA usa chip americani per acquistare i quali ha bisogno di una licenza statunitense e offre un modello costruito su pesi aperti cinesi. Al livello con cui il pubblico entra effettivamente in contatto, la sovranità si è rivelata un lavoro di integrazione.
| Accordo | Dettaglio |
|---|---|
| Installazione iniziale Nvidia per HUMAIN | 18.000 sistemi GB300 Grace Blackwell |
| Obiettivo quinquennale di HUMAIN | Diverse centinaia di migliaia di GPU, capacità prevista fino a 500 MW |
| Autorizzazione statunitense all’esportazione per HUMAIN | Fino a 35.000 chip della classe GB300 |
| Accordo con la Saudi Data & AI Authority | Fino a 5.000 GPU Blackwell per una fabbrica nazionale di IA |
La risposta dell’Europa passa da Parigi
La Francia ha puntato la propria strategia per un’IA sovrana su un unico campione nazionale: Mistral AI, la startup parigina fondata nel 2023 che è quanto di più vicino l’Europa abbia a un concorrente di OpenAI o Anthropic nello sviluppo di modelli di frontiera. Lo Stato francese non possiede Mistral, ma il rapporto si configura come un allineamento strategico: Bpifrance, la banca pubblica d’investimento, ha coinvestito nei round di finanziamento di Mistral e l’azienda si avvale di infrastrutture pubbliche come il supercomputer Jean Zay.
Nel settembre 2025, il round di finanziamento Series C di Mistral ha raccolto 1,7 miliardi di euro, attribuendo alla società una valutazione di 11,7 miliardi di euro. Il round è stato guidato da ASML, colosso delle apparecchiature per la produzione di chip. L’azienda ha inoltre lanciato «Mistral Compute», un cluster di 18.000 GPU Nvidia Grace Blackwell ospitato in un data center da 40 megawatt nella regione dell’Essonne.
Da allora la valutazione è quasi raddoppiata. L’8 settembre 2026 Mistral ha annunciato un round Series D da 3 miliardi di euro, con una valutazione post-money superiore a 21 miliardi di euro, presentandolo come un modo per portare l’IA sovrana e a pesi aperti alla frontiera, anziché relegarla al ruolo di ripiego. Un mese prima aveva annunciato inferenza all’interno della regione, modelli aperti e nuove infrastrutture europee: una risposta all’obiezione precisa secondo cui un modello europeo erogato da un data center americano non è un modello europeo.
Al Paris AI Action Summit del febbraio 2025, la Francia ha inoltre annunciato impegni per circa 109 miliardi di euro in infrastrutture per l’IA — tra i maggiori impegni nazionali per l’IA al di fuori di Stati Uniti e Cina — oltre a uno stanziamento separato di 655 milioni di euro per strumenti di IA sviluppati specificamente per la pubblica amministrazione francese. Mistral ha anche iniziato a fornire modelli per applicazioni militari francesi, inserendo direttamente l’argomento della sovranità negli acquisti per la difesa.
| Paese/Regione | Programma | Impegno |
|---|---|---|
| Francia | Impegni per le infrastrutture di IA (Paris AI Action Summit) | ~109 miliardi di euro |
| UE (InvestAI) | Mobilitare investimenti nell’IA entro il 2030 | ~200 miliardi di euro (50 miliardi di euro pubblici) |
| UE (InvestAI Facility) | AI Gigafactories (fino a sette) | 20 miliardi di euro |
| India | IndiaAI Mission | 10.372 crore di rupie (~1,25 miliardi di dollari) |
| Corea del Sud (Naver/Nvidia/Brookfield) | Espansione della fabbrica nazionale di IA | ~10 miliardi di dollari, da 55 MW a 200 MW entro il 2028 |
Bruxelles, intanto, cerca di costruire la sovranità a livello dell’Unione anziché lasciarla ai singoli Stati membri. L’iniziativa InvestAI, presentata durante lo stesso vertice di Parigi, punta a mobilitare circa 200 miliardi di euro di investimenti nell’IA nell’UE entro il 2030, di cui circa 50 miliardi di fondi pubblici e una componente privata molto più ampia: un obiettivo che diversi analisti europei hanno poi criticato come più simile a un’aspirazione che a capitali già impegnati.
Un elemento più concreto è l’InvestAI Facility da 20 miliardi di euro, destinata a contribuire alla costruzione di un massimo di sette «AI Gigafactories» (procedura di appalto EuroHPC, luglio 2026), ciascuna inizialmente concepita per ospitare circa 100.000 chip per l’IA di ultima generazione. A questa si affianca il programma AI Factories dell’EuroHPC Joint Undertaking, che nel dicembre 2024 ha selezionato sette consorzi — in Finlandia, Germania, Grecia, Italia, Lussemburgo, Spagna e Svezia, con il coinvolgimento di oltre quindici Stati membri e associati — per sviluppare capacità di addestramento dell’IA sulla rete europea di supercomputer esistente.
L’obiettivo esplicito, nelle parole della stessa Commissione europea, è ridurre la dipendenza dai fornitori di potenza di calcolo non europei. Se sia possibile raggiungerlo mentre i chip alla base di queste infrastrutture continuano a provenire quasi interamente da Nvidia è un’altra questione.
I percorsi paralleli dell’Asia
Tra le grandi democrazie, quello dell’India è l’approccio più diretto dallo Stato. La IndiaAI Mission, avviata dal governo nel 2024 con uno stanziamento di circa 10.372 crore di rupie (nell’ordine di 1,25 miliardi di dollari), si è posta l’obiettivo di sviluppare contemporaneamente capacità di calcolo nazionali, dataset e modelli fondazionali sovrani.
Contare le GPU del pool condiviso è più difficile di quanto dovrebbe: le cifre pubblicate sulla capacità messa a disposizione dai fornitori selezionati all’inizio del 2026 andavano da 38.000 a 58.000 processori, a seconda della fonte e del mese. Il 27 febbraio 2026, al Rising Bharat Summit, Ashwini Vaishnaw ha detto che l’India avrebbe dovuto portare la propria capacità di calcolo a quasi 200.000 GPU o più. Gran parte di questa capacità proviene dalle infrastrutture realizzate da aziende come L&T e Yotta; la sola piattaforma «Shakti Cloud» di Yotta mette in funzione più di 20.000 GPU Blackwell Ultra.
Il principale progetto di modelli della missione è stato affidato a Sarvam AI, scelta nell’aprile 2025 come perno dell’ecosistema indiano di LLM sovrani. L’azienda ha reso open source due modelli mixture-of-experts, Sarvam-30B e il più grande Sarvam-105B, entrambi addestrati usando la capacità di calcolo della IndiaAI Mission e presentati all’India AI Impact Summit nel febbraio 2026. Un’iniziativa distinta, BharatGen, ha pubblicato un proprio modello multilingue, Param2, con lo stesso obiettivo di garantire una copertura adeguata delle numerose lingue ufficiali dell’India, a cui nessun laboratorio estero di modelli di frontiera ha dato priorità. L’idea di un programma imperniato su un unico soggetto non ha retto: sono arrivate centinaia di proposte di modelli, decine delle quali riguardavano modelli linguistici di grandi dimensioni, e la linea di BharatGen sviluppata all’IIT Bombay ha proceduto per tutto il tempo in parallelo a quella di Sarvam.
La versione giapponese punta su modelli più piccoli e sull’efficienza, anche per via dei rigidi vincoli energetici del paese. Dal 2024, il programma GENIAC, sostenuto dal governo e gestito tramite NEDO, ha dato a decine di progetti nazionali di IA accesso a cluster di GPU sovvenzionati nell’arco di due cicli di sei mesi. Il beneficiario più visibile è Sakana AI, una startup di Tokyo fondata nel 2023 da David Ha, Llion Jones e Ren Ito, ex ricercatori di Google, che ha raccolto 135 milioni di dollari in un round di serie B con una valutazione di 2,65 miliardi di dollari. Il suo obiettivo è sviluppare modelli efficienti nell’uso della capacità di calcolo e in sintonia con il contesto culturale, destinati ad applicazioni nella finanza e nella difesa, anziché cercare di superare la Silicon Valley sul piano delle dimensioni.
Sul versante delle imprese, SB Intuitions, controllata di SoftBank, ha sviluppato un proprio LLM, Sarashina, che secondo SoftBank conta circa 460 miliardi di parametri. Nel novembre 2025 ha lanciato tramite API una versione più leggera destinata alle imprese, Sarashina mini. SoftBank ha dichiarato che, a partire dal giugno 2026, distribuirà servizi di IA generativa basati su Sarashina attraverso la sua piattaforma «Cloud PF Type A», che utilizza Oracle Alloy, indicando esplicitamente come obiettivo la tutela della sovranità sui dati.
NTT ha seguito un percorso parallelo, ma con modelli più compatti, sviluppando tsuzumi: un LLM leggero, offerto in versioni da 0,6 miliardi e 7 miliardi di parametri, costruito interamente da zero anziché adattato da un modello open source esistente. Il suo aggiornamento dell’ottobre 2025, tsuzumi 2, è rivolto ai settori finanziario, medico e pubblico ed è proposto come alternativa nazionale più sicura e più capace di cogliere le specificità culturali rispetto all’impiego di modelli occidentali in ogni processo di lavoro interno.
La Corea del Sud ha affiancato a un analogo sforzo sui modelli un’espansione insolitamente ampia della capacità di calcolo. Naver, la principale società internet del paese, continua a sviluppare la sua famiglia di modelli HyperCLOVA X, ampliando al tempo stesso una partnership con Nvidia per un cloud sovrano, secondo un piano graduale che punta a infrastrutture dell’ordine dei gigawatt. Nell’ottobre 2025, il Ministero della Scienza e dell’ICT ha dichiarato che avrebbe assegnato circa 50.000 GPU Nvidia al settore pubblico per sostenere i modelli fondazionali di IA sovrana e la creazione del National AI Computing Center. La misura rientra in un progetto nazionale che, secondo Nvidia, prevede più di 260.000 GPU distribuite tra cloud sovrani e fabbriche di IA. Alla fine di luglio 2026, Naver, Nvidia e Brookfield hanno destinato circa 10 miliardi di dollari all’espansione di quella fabbrica nazionale di IA da 55 a 200 megawatt entro il 2028: Brookfield fornirà fino a 9 miliardi di dollari e Nvidia investirà circa 1 miliardo di dollari.
Singapore, senza ambizioni di capacità di calcolo pari a quelle dei suoi vicini più grandi, si è invece concentrata sulla copertura linguistica. La famiglia di modelli open source SEA-LION di AI Singapore, addestrata su circa mille miliardi di token con un’ampia rappresentazione delle undici lingue ufficiali del Sud-est asiatico, tra cui thailandese, vietnamita, birmano, khmer e lao, è stata sviluppata proprio per rimediare alle scarse prestazioni dei principali modelli occidentali nelle lingue della regione con poche risorse digitali.
La strozzatura dei chip alla base di tutto
Tutti questi programmi nazionali si scontrano con lo stesso collo di bottiglia: quasi tutti dipendono dall’hardware di Nvidia, e le esportazioni dell’hardware di Nvidia sono uno strumento della politica estera statunitense. L’«AI Diffusion Rule» dell’amministrazione Biden, emanata nel gennaio 2025, cercava di formalizzare questa situazione suddividendo il mondo intero in fasce: agli alleati più stretti era concesso un accesso in gran parte illimitato alle GPU di punta, una fascia intermedia era soggetta a limiti quantitativi e licenze, mentre gli Stati avversari ne erano esclusi.
La norma è entrata in vigore nel gennaio 2025, con una scadenza per adeguarsi fissata a maggio 2025. Nel maggio 2025 l’amministrazione Trump ha annunciato che non l’avrebbe applicata e che intendeva abrogarla e sostituirla, sostenendo che alienava i governi partner e cedeva quote di mercato ai fornitori non statunitensi. Nel frattempo, perseguiva accordi bilaterali, come quello tra HUMAIN e Nvidia in Arabia Saudita.
La politica verso la Cina ha subito oscillazioni ancora più brusche nello stesso anno. Il chip H20 di Nvidia, specifico per il mercato cinese, era stato progettato deliberatamente per rispettare le restrizioni alle esportazioni introdotte alla fine del 2023. Poi, nell’aprile 2025, il Dipartimento del Commercio ha cambiato rotta e lo ha bloccato comunque; a luglio e agosto ha cambiato di nuovo posizione, rilasciando licenze di esportazione a condizioni che, secondo quanto riferito, prevedevano che il governo statunitense trattenesse il 15% dei ricavi. Le autorità di regolamentazione cinesi hanno però scoraggiato gli acquirenti nazionali dall’acquistare i chip per motivi di sicurezza, affossando di fatto il prodotto indipendentemente da ciò che Washington consentiva.
Nel dicembre 2025 l’amministrazione ha invertito ancora la rotta, aprendo alla vendita in Cina del più potente H200, e nel maggio 2026 Washington aveva autorizzato le vendite di H200 a dieci aziende cinesi. I chip arrivati sono stati pochissimi. Nel gennaio 2026 agli agenti doganali cinesi è stato comunicato che l’H200 non era ammesso; a marzo Nvidia ha fermato la produzione dell’H200 per il mercato cinese; ad agosto, secondo quanto riportato, gli arrivi effettivi rappresentavano una piccola frazione della quota approvata, e le previsioni della stessa Nvidia non contemplano alcun ricavo dalla capacità di calcolo per i data center in Cina.
Entrambi i governi possono chiudere i rubinetti, e nel 2026 entrambi lo hanno fatto: Washington attraverso le licenze, Pechino alla frontiera. Queste continue inversioni di rotta mostrano il problema centrale per qualsiasi Paese che costruisca un’IA «sovrana» su chip statunitensi: la sovranità sul proprio modello conta poco se il governo di un altro Paese può, con pochi mesi di preavviso, assoggettare a nuove licenze l’hardware su cui si basa, imporvi nuove restrizioni o modificarne il prezzo.
Sovranità senza indipendenza
È questa la tensione che nessun materiale promozionale riesce davvero a risolvere. Un Paese può addestrare un proprio modello, ospitarlo sul proprio territorio e stabilire proprie norme sulla protezione dei dati, e restare comunque interamente dipendente da un fornitore estero per l’infrastruttura fisica su cui gira tutto il resto. Emirati Arabi Uniti, Arabia Saudita, Francia, India, Giappone e Corea del Sud stanno tutti costruendo, per scelta o per mancanza di alternative, le proprie capacità nazionali nell’IA sulle GPU di Nvidia, perché al momento non esiste un’alternativa valida alla scala necessaria.
La Cina è l’unica grande eccezione: anni di controlli sulle esportazioni l’hanno costretta a costruire uno stack parallelo basato sui chip Ascend di Huawei e su modelli addestrati nel Paese. È una forma di sovranità imposta dalle circostanze: costosa, più lenta, ma non subordinata alle licenze del governo di un altro Paese. Questo stack ha cominciato ad affacciarsi all’esterno: il modello in arabo presentato da Riyadh nel settembre 2026 è stato costruito su pesi aperti cinesi, non statunitensi.
Gli obblighi di localizzazione dei dati aggiungono una seconda dimensione, meno vistosa, alla stessa spinta. Il quadro europeo di protezione dei dati, la normativa indiana in evoluzione sulla protezione dei dati e norme analoghe nei Paesi del Golfo e dell’Asia orientale richiedono sempre più spesso che determinate categorie di dati — documenti pubblici, dati sanitari, documenti finanziari — siano elaborate e conservate entro i confini nazionali. È una forma di sovranità concreta e giuridicamente vincolante, distinta dalla capacità di addestrare modelli di frontiera e più facile da ottenere.
È anche il motivo per cui tante di queste strategie nazionali per l’IA abbinano la costruzione di modelli a quella di data center: un modello addestrato nel Paese che, per l’inferenza, deve comunque collegarsi a un cloud estero non risolve affatto il problema della localizzazione.
Che cosa determina davvero la corsa
La corsa all’IA sovrana non è propriamente una gara a chi costruisce il modello migliore: secondo la maggior parte dei benchmark pubblici, Falcon, Mistral, Sarvam e Sarashina sono tutti indietro rispetto agli attuali modelli di frontiera dei maggiori laboratori statunitensi e cinesi, e nessuno dei loro sostenitori afferma il contrario. È una gara a chi può stabilire le condizioni alle quali l’IA opera in una determinata giurisdizione: quali politiche sui contenuti si applicano, quale licenza di esportazione può interrompere l’accesso alla capacità di calcolo, quale lingua e quale ordinamento giuridico il modello comprende davvero e quale governo può essere obbligato — per ordine di un tribunale, per via normativa o per pressione geopolitica — a concedere o negare l’accesso.
Falcon e Mistral contano per Abu Dhabi e Parigi non tanto perché siano competitivi nelle classifiche, quanto perché non sono soggetti alla prossima inversione di rotta politica di un’amministrazione statunitense. È questa distinzione, non la qualità dei modelli in sé, a spingere i ministeri delle Finanze a staccare assegni a nove e dieci cifre. I chip su cui si basano restano però soggetti esattamente a quel genere di inversione di rotta. Per questo la sovranità oggi disponibile è parziale, condizionata e, come hanno mostrato le vicende dell’H20 e dell’H200, revocabile nell’arco di un solo esercizio finanziario.