Trasformazione dei settori
La rivoluzione dell’IA nella sanità: come l’intelligenza artificiale sta ricostruendo la medicina dalle fondamenta
Assistenti che redigono note cliniche durante milioni di visite, oltre 1.600 dispositivi di IA nell’elenco della FDA e, nel settembre 2026, la prima somministrazione in uno studio di fase III di un farmaco con un bersaglio individuato dall’
AI.info Team ·
Le pratiche burocratiche della medicina, riscritte in silenzio
Entrando in una sala visite nel 2026, il cambiamento più visibile non è un robot né uno schermo pieno di diagrammi di reti neurali. È un telefono appoggiato sulla scrivania, in ascolto. Gli assistenti di IA che redigono note cliniche durante le visite — Abridge, Dragon Copilot di Microsoft (il prodotto precedentemente noto come DAX di Nuance) e «Art for Clinicians» di Epic — assistono ormai a milioni di visite, trascrivono la conversazione e preparano una bozza della nota clinica prima ancora che il paziente abbia lasciato il parcheggio. È l’ambito meno appariscente dell’IA medica e, probabilmente, quello che sta già producendo i maggiori benefici su larga scala.
Le prove non vengono da un comunicato stampa. La Division of Research di Kaiser Permanente, in uno studio pubblicato su NEJM Catalyst e in lavori successivi tramite Permanente Medicine, ha seguito l’introduzione di questi assistenti da parte di The Permanente Medical Group a partire dalla fine del 2023: nell’arco di 63 settimane, lo strumento era stato usato in oltre 2,5 milioni di visite, i medici avevano risparmiato complessivamente quasi 16.000 ore di lavoro per la documentazione nel primo anno e l’uso era più frequente nella salute mentale, nella medicina d’urgenza e nelle cure primarie — proprio le specialità che segnalano i livelli più alti di burnout. I sondaggi tra medici e pazienti hanno dato risultati positivi e Kaiser ha continuato a pubblicare dati sul controllo della qualità man mano che l’adozione cresceva, anziché dichiarare vittoria dopo un progetto pilota.
Il mercato si è mosso altrettanto in fretta. Abridge, che ha sviluppato i propri modelli fondazionali invece di costruire un’interfaccia attorno a un LLM generalista, è stata nominata Best in KLAS per l’IA ambientale sia nel 2025 sia nel 2026. Nel giugno 2025 ha raccolto 300 milioni di dollari in un finanziamento di serie E, con una valutazione di 5,3 miliardi di dollari, a cui si è aggiunta nell’aprile 2026 un’estensione da 316 milioni di dollari alla stessa valutazione: capitali ingenti investiti per risolvere un problema decisamente poco attraente, quello della nota clinica.
Microsoft, che ha acquistato Nuance per 19,7 miliardi di dollari nel 2022, ha integrato DAX in Dragon Copilot e da allora ne ha ampliato le funzioni ben oltre la stesura delle note. All’HIMSS del marzo 2026, l’azienda ha riposizionato Dragon Copilot come assistente clinico anziché come strumento di trascrizione, lo ha esteso a infermieri e radiologi, lo ha aperto ad agenti di terze parti e ha dichiarato una base di utilizzo di oltre 100.000 professionisti clinici. La pagina del prodotto di Microsoft indica ora che è disponibile per i medici in dieci paesi, per gli infermieri solo negli Stati Uniti, mentre l’esperienza per la radiologia è ancora in anteprima. Epic, non volendo cedere il controllo del punto d’integrazione, è entrata a sua volta nel mercato nell’agosto 2025 con uno strumento nativo basato su Dragon Ambient AI di Microsoft e addestrato su Cosmos, il database aggregato di Epic che contiene circa 300 milioni di cartelle cliniche.
Il fatto che tre aziende ben finanziate competano per gestire gli stessi cinque minuti della giornata di un medico è un segnale plausibile che il peso della documentazione — non la diagnosi — fosse il problema della medicina più affrontabile con l’IA: il dato di riferimento (ciò che è stato detto nella stanza) è inequivocabile e l’errore possibile (una parola sbagliata in una nota) può essere corretto da una persona prima della firma.
Dove l’IA per la diagnostica per immagini ha davvero ottenuto le sue autorizzazioni
La diagnostica per immagini è l’ambito in cui l’IA applicata alla medicina vanta la storia più lunga e il percorso regolatorio meglio documentato. Alla fine del 2025, l’elenco pubblico della FDA dei dispositivi medici basati sull’IA contava circa 1.450 voci — il totale aggiornato deriva da rilevazioni di terzi, mentre la FDA riferisce ora di oltre 1.600 dispositivi autorizzati a settembre 2026 — di cui circa 295 autorizzati nel solo 2025. La radiologia rappresenta circa il 76% dell’elenco, ossia circa 1.100 dispositivi, perché dispone di molti dati ben etichettati e si presta, per sua natura, al riconoscimento di pattern.
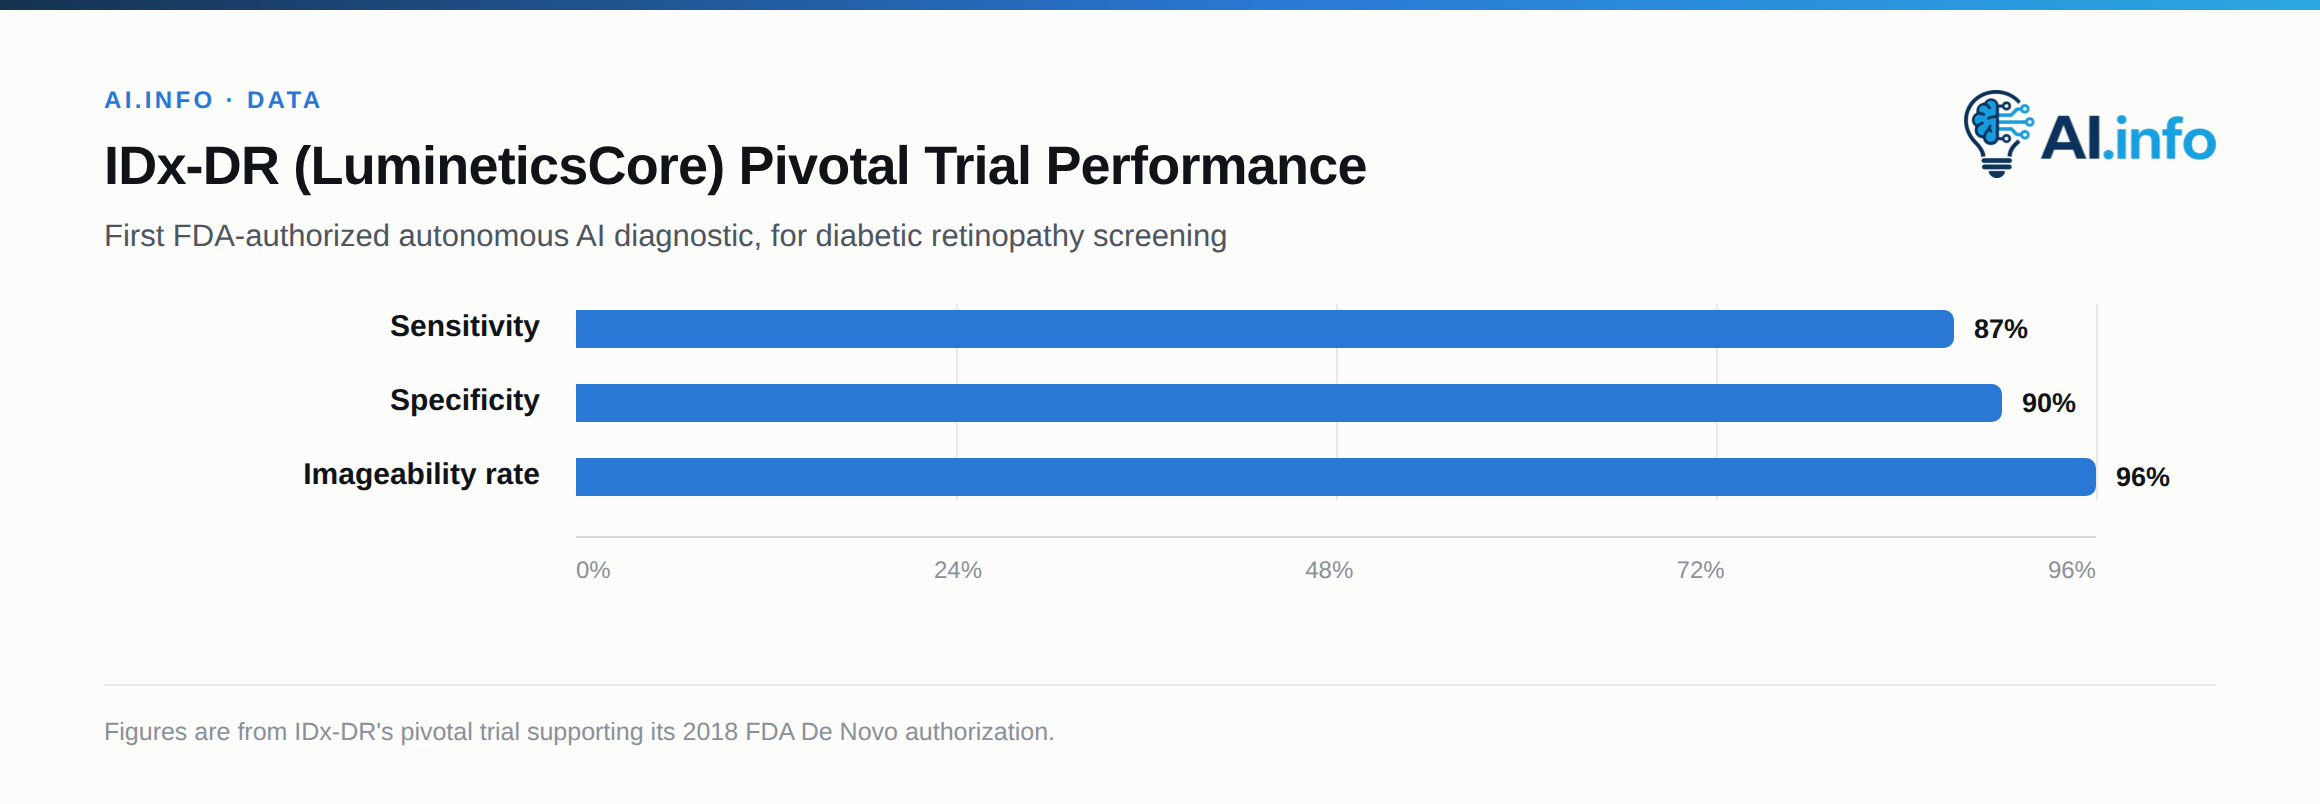
Il caso che ha segnato una svolta è IDx-DR, oggi ribattezzato LumineticsCore. Nel 2018 è diventato la prima IA diagnostica completamente autonoma a ottenere un’autorizzazione De Novo dalla FDA: non occorre che un medico interpreti l’immagine. Un tecnico delle cure primarie fotografa la retina di un paziente con una fotocamera Topcon e il software formula autonomamente una diagnosi di retinopatia diabetica più che lieve, senza che per quella valutazione sia necessario un oftalmologo.
Nello studio clinico decisivo ha raggiunto una sensibilità dell’87%, una specificità del 90% e un tasso del 96% di immagini idonee alla valutazione; in seguito, il suo fondatore ha riferito che era stato adottato in oltre 20 sedi negli Stati Uniti. La sua importanza non sta nella particolarità dell’algoritmo, ma nella categoria regolatoria stessa — una macchina autorizzata a formulare una diagnosi senza supervisione — che prima non esisteva.
La patologia ha raggiunto una propria tappa nel 2021, quando Paige Prostate è diventato il primo prodotto di IA autorizzato dalla FDA nella patologia digitale, con l’autorizzazione a supportare l’individuazione del cancro nelle agobiopsie prostatiche. Nella validazione, i patologi che usavano lo strumento hanno ridotto i falsi negativi di circa il 70% e i falsi positivi di circa il 24% rispetto alle letture senza assistenza. E — un dettaglio che dovrebbe rassicurare chi teme che l’IA impoverisca le competenze — i patologi non specialisti che usavano il software hanno raggiunto una sensibilità di rilevamento simile a quella dei patologi specialisti. È il risultato che l’IA per la diagnostica per immagini continua a mostrare: riduce il divario tra un clinico medio e uno specialista di alto livello in modo più affidabile di quanto riesca a migliorare le prestazioni del miglior lettore umano quando opera da solo.
| Strumento | Metrica | Miglioramento |
|---|---|---|
| Paige Prostate | Falsi negativi | ridotti di ~70% |
| Paige Prostate | Falsi positivi | ridotti di ~24% |
| Mammografia di DeepMind (USA) | Falsi positivi | ridotti del 5,7% |
| Mammografia di DeepMind (USA) | Falsi negativi | ridotti del 9,4% |
| Mammografia di DeepMind (Regno Unito) | Falsi positivi | ridotti dell’1,2% |
| Mammografia di DeepMind (Regno Unito) | Falsi negativi | ridotti del 2,7% |
Il lavoro di Google DeepMind sulla mammografia, pubblicato su Nature e realizzato con l’Imperial Centre di Cancer Research UK, Northwestern University e Royal Surrey County Hospital, si è basato su oltre 90.000 mammografie private dei dati identificativi, raccolte nel Regno Unito e negli Stati Uniti. Nei test retrospettivi sui dataset britannico e statunitense ha mostrato riduzioni assolute dei falsi positivi del 5,7% (USA) e dell’1,2% (Regno Unito), e dei falsi negativi del 9,4% (USA) e del 2,7% (Regno Unito).
DeepMind ha dichiarato apertamente il limite: lo studio utilizzava immagini provenienti prevalentemente dalle apparecchiature di un solo produttore, e sono gli studi clinici prospettici — non gli studi retrospettivi di lettura — a poter stabilire le prestazioni nel mondo reale. Questa avvertenza resta valida: l’adozione dell’IA nello screening è avanzata più lentamente di quanto lasciassero intendere i titoli del 2020, proprio perché l’accuratezza retrospettiva e il beneficio clinico prospettico sono due questioni diverse.
AlphaFold e il lungo percorso dalla previsione alla pillola
Il premio Nobel per la Chimica 2024 è andato a Demis Hassabis e John Jumper di Google DeepMind per AlphaFold, insieme a David Baker per la progettazione computazionale delle proteine: è la prima volta che un Nobel viene assegnato per un risultato basato sull’IA. Da quando è stato reso disponibile gratuitamente, l’AlphaFold Protein Structure Database è stato consultato da oltre 3 milioni di ricercatori in più di 190 paesi, tra cui oltre un milione di utenti in paesi a basso e medio reddito. Circa il 30% delle ricerche che lo citano è incentrato sulle malattie.
Questa diffusione è reale, non è frutto dell’entusiasmo mediatico: prevedere la struttura 3D di una proteina dalla sua sequenza di amminoacidi, un problema su cui i biologi hanno lavorato per decenni, è oggi qualcosa che un modello fa in pochi minuti.
Quello che AlphaFold non ha ancora fatto è portare un nuovo farmaco sugli scaffali delle farmacie. Isomorphic Labs, la società nata da DeepMind per la scoperta di farmaci, ha raccolto 600 milioni di dollari nel marzo 2025, ha stretto partnership con Eli Lilly e Novartis e nel febbraio 2026 ha presentato IsoDDE, un motore unificato di progettazione che combina la previsione delle strutture con la modellazione dell’affinità di legame. Ma non ha ancora somministrato una molecola a una persona. Intervenendo a Davos nel gennaio 2026, Demis Hassabis ha detto che le prime sperimentazioni cliniche sarebbero iniziate entro la fine del 2026, un anno dopo rispetto a quanto aveva previsto in precedenza. Nel settembre 2026, l’azienda doveva ancora raggiungere quel traguardo.
La molecola di Insilico Medicine per la stessa malattia è arrivata più avanti di qualsiasi altra nel settore. I risultati della fase IIa di INS018_055, ora chiamata rentosertib, sono stati pubblicati su Nature Medicine il 3 giugno 2025: 71 pazienti con fibrosi polmonare idiopatica in 22 centri cinesi, dodici settimane di trattamento e un aumento medio di 98,4 mL della capacità vitale forzata con 60 mg una volta al giorno, contro un calo di 20,3 mL con il placebo. Il 10 settembre 2026 Insilico ha somministrato la prima dose al primo paziente di GENESIS-IPF-3, uno studio di fase III di 52 settimane, randomizzato e controllato con placebo, che punta a coinvolgere 320 pazienti in 47 centri in Cina: è la prima volta che un composto con un bersaglio selezionato dall’IA e una struttura generata dall’IA raggiunge questa fase.
Sono entrambi primati significativi. Nessuno dei due dimostra ancora che i farmaci progettati con l’IA funzionino meglio, costino meno o arrivino più rapidamente rispetto a quelli sviluppati con il percorso convenzionale: uno studio di fase III in cui è appena stato arruolato il primo paziente è un punto di partenza, non un risultato. La valutazione più onesta dell’impatto di AlphaFold è questa: ha trasformato la biologia strutturale come strumento di ricerca, ma finora non è dimostrato che acceleri l’approvazione dei farmaci. Sono due affermazioni diverse, che la comunicazione periodica del settore tende a confondere.
I fallimenti che dovrebbero frenare l’ottimismo
Il caso che oggi ogni sistema sanitario cita come monito è l’Epic Sepsis Model, un algoritmo proprietario di allerta precoce integrato nell’Epic EHR e adottato da centinaia di ospedali statunitensi senza una validazione esterna indipendente. Quando ricercatori esterni hanno finalmente potuto metterlo alla prova, i risultati sono stati negativi: una validazione dell’University of Michigan ha rilevato che il modello non individuava due terzi dei casi di sepsi che avrebbe dovuto riconoscere, mentre un’analisi separata su una finestra di 6 ore ha riscontrato una sensibilità di appena il 14,7% e un valore predittivo positivo del 7,6%. In altre parole, la stragrande maggioranza degli avvisi era costituita da falsi allarmi, mentre la maggior parte dei casi reali passava inosservata.
Il danno non era che il modello sbagliasse, ma che uno strumento clinico ampiamente diffuso fosse rimasto in uso per anni sulla base delle prestazioni dichiarate dal fornitore, prima che qualcuno ne verificasse la calibrazione nel mondo reale. È questo, oggi, l’argomento centrale a favore di una validazione esterna obbligatoria per ogni modello di previsione clinica prima di una diffusione su larga scala, e non soltanto al momento dell’autorizzazione della FDA, ma in modo continuativo: un modello addestrato sui dati di un ospedale subisce una deriva quando incontra la popolazione di pazienti, l’organizzazione del personale e le abitudini di documentazione di un altro.
| Sistema | Che cosa non ha funzionato | Esito documentato |
|---|---|---|
| Epic Sepsis Model | Introdotto senza validazione indipendente | Non ha individuato due terzi dei casi di sepsi; sensibilità del 14,7%, PPV del 7,6% |
| IBM Watson for Oncology | Addestrato principalmente sui protocolli di un solo ospedale | MD Anderson ha speso ~62 milioni di dollari prima di accantonarlo nel 2016 |
| Algoritmo commerciale di previsione del rischio | Usava la spesa come indicatore indiretto della gravità della malattia | La correzione della distorsione ha portato la quota di pazienti neri segnalati dal 17,7% al 46,5% |
IBM Watson for Oncology è una versione più vecchia e più costosa della stessa lezione. L’University of Texas MD Anderson Cancer Center ha speso circa 62 milioni di dollari per un progetto chiamato Oncology Expert Advisor prima di accantonarlo nel 2016. Documenti interni di IBM emersi in seguito grazie a STAT News, nel 2018, hanno mostrato che durante i test il sistema aveva talvolta raccomandato trattamenti oncologici «non sicuri e scorretti».
Il fallimento era in parte strutturale: Watson era stato addestrato in larga misura su casi e protocolli del Memorial Sloan Kettering, e le sue raccomandazioni non si adattavano senza problemi alle popolazioni di pazienti e alle pratiche terapeutiche di altre istituzioni. Era un problema di generalizzazione dei dati di addestramento, non un bug isolato. Nessun paziente ha subito danni, perché gli output errati sono stati intercettati prima dell’uso clinico, ma l’episodio resta il caso di riferimento per capire che cosa accade quando il marketing di un sistema di IA corre più veloce della sua validazione.
La distorsione è il terzo tipo di fallimento ricorrente. Il caso documentato più chiaro è quello analizzato in un articolo pubblicato da Ziad Obermeyer su Science nel 2019: un algoritmo commerciale di previsione del rischio, ampiamente utilizzato dagli ospedali per individuare i pazienti da destinare a un’assistenza aggiuntiva. L’algoritmo usava la spesa sanitaria pregressa come indicatore indiretto della gravità della malattia: una scorciatoia apparentemente ragionevole, che però non funzionava perché, a parità di gravità effettiva, per i pazienti neri si era storicamente speso meno a causa delle disuguaglianze nell’accesso alle cure.
Il risultato era che, a parità di punteggio di rischio, i pazienti neri erano significativamente più malati dei pazienti bianchi, e l’algoritmo ne indirizzava all’assistenza aggiuntiva molti meno di quanti avrebbe dovuto. Secondo lo studio, correggere la distorsione avrebbe portato la quota di pazienti neri segnalati per ricevere un aiuto aggiuntivo dal 17,7% al 46,5%. Collaborando con il produttore, il gruppo di Obermeyer ha mostrato che un nuovo addestramento basato su una misura più diretta del bisogno di cure riduceva la distorsione razziale dell’84%.
Una volta individuato il difetto, correggerlo era fattibile. Ma l’algoritmo aveva operato con quel difetto in produzione, senza che nessuno se ne accorgesse, per un periodo imprecisato prima che lo rilevasse un audit accademico. È lo schema comune a tutti e tre i fallimenti: non era evidente che gli strumenti non funzionassero finché qualcuno esterno al fornitore non li ha messi alla prova nella realtà.
La regolamentazione cerca di recuperare terreno, non di tenere il passo
L’approccio della FDA è passato dall’autorizzare singolarmente algoritmi statici al gestire l’IA come una categoria di prodotti che continuano a cambiare dopo l’autorizzazione. Le linee guida del gennaio 2025 sulla gestione del ciclo di vita delle funzioni software dei dispositivi basate sull’IA, ancora contrassegnate come «Bozza — Non destinata all’applicazione» nel settembre 2026, delineano un quadro per l’intero ciclo di vita del prodotto. Chiedono ai produttori una descrizione del modello, la provenienza dei dati, prestazioni documentate a sostegno di affermazioni specifiche e un’analisi delle distorsioni. Il documento complementare è già definitivo: le linee guida della FDA sui piani prestabiliti di controllo delle modifiche per le funzioni software dei dispositivi basate sull’IA, pubblicate nell’agosto 2025, consentono a un produttore di concordare in anticipo esattamente come e quando un modello possa aggiornarsi senza una nuova domanda di autorizzazione alla commercializzazione.
L’agenzia ha inoltre dichiarato che esaminerà modi per identificare e contrassegnare le voci di quell’elenco basate su foundation model, dai modelli linguistici di grandi dimensioni alle architetture multimodali, e chiede ai proponenti di inserire l’informazione nei loro riepiloghi pubblici. È un riconoscimento del fatto che l’IA generativa non si inserisce facilmente in un quadro concepito per classificatori fissi che analizzano immagini; nel settembre 2026 quel contrassegno non era ancora comparso nell’elenco. Tutto questo non risolve la questione aperta più difficile: come si valida un sistema il cui comportamento può legittimamente cambiare ogni pochi mesi, distribuito in sistemi sanitari con popolazioni di pazienti, modelli di organizzazione del personale e pipeline di dati diversi da quelli del set di validazione utilizzato dal produttore?
Il filo conduttore
Bisogna fare chiarezza di fronte a due narrazioni contrapposte. Non è vero che l’IA stia fallendo silenziosamente in medicina: il sistema di screening della retinopatia diabetica, lo strumento di analisi patologica della prostata e i sistemi di trascrizione ambientale sono in uso su scala reale, con risultati pubblicati, fanno risparmiare ore di lavoro ai medici e individuano malattie. Ma non è nemmeno vero che la medicina venga «ricostruita dalle fondamenta» dalle macchine intelligenti, come promette il titolo di questo stesso articolo.
Quello che sta accadendo è più circoscritto e più utile: l’IA funziona nei campi in cui esiste un dato di riferimento chiaro e gli errori sono correggibili — un’immagine della retina mostra una lesione oppure no; una nota corrisponde alla conversazione registrata oppure viene corretta prima della firma. Fallisce invece, a volte con costi elevati, quando i dati su cui un modello è stato addestrato non rispecchiano più la popolazione che il modello deve valutare: dagli avvisi sulla sepsi di Epic ai piani terapeutici di Watson, fino a un punteggio di rischio basato sui costi che scambiava la disparità nell’accesso alle cure per buona salute.
Il Nobel legato ad AlphaFold è reale. Lo è anche il fatto che nessun farmaco progettato con l’IA abbia ancora superato una sperimentazione di fase III, dimostrando che l’intero processo funziona dall’inizio alla fine. Il primo farmaco con un bersaglio selezionato dall’IA e una molecola generata dall’IA ad arrivare a quella fase ha iniziato la somministrazione ai partecipanti soltanto nel settembre 2026. Una valutazione onesta nel 2026 non parla né di rivoluzione né di clamore ingiustificato: la tecnologia è valida esattamente quanto lo sono le procedure adottate per verificarla. E finora il rigore di queste verifiche è stato estremamente disomogeneo: si va da uno scanner retinico sottoposto a controlli accurati a un modello per la sepsi rimasto in uso per anni prima che qualcuno lo verificasse su dati esterni.