Trasformazione dei settori
L’IA agentica nelle imprese: quando il software comincia ad agire
Come l’architettura dell’adozione dell’IA è passata dagli assistenti che rispondono ai prompt agli agenti autonomi che pianificano, agiscono e raggiungono obiettivi, e che cosa significa per il lavoro, la governance e la sicurezza.
AI.info Team ·
Dai chatbot ai colleghi di lavoro
Per gran parte del boom dell’IA generativa, il software aziendale si è limitato a rispondere. Riassumeva documenti, scriveva bozze di email, rispondeva alle domande in una finestra di chat. Non faceva nulla di propria iniziativa. È questa la distinzione che l’«IA agentica» dovrebbe cancellare: anziché produrre un testo su cui poi interviene una persona, il modello pianifica una sequenza di passaggi, chiama strumenti e API, legge i risultati e decide che cosa fare dopo, spesso senza che una persona esamini ogni passaggio.
Nella finanza, in particolare, significa un agente che non si limita a spiegare che cos’è un modello di flussi di cassa attualizzati, ma recupera i documenti depositati, costruisce il modello, lo verifica confrontandolo con società comparabili e restituisce una bozza di memorandum.
È per questo cambiamento che il 2026 è diventato l’anno in cui i fornitori di software aziendale hanno smesso di dire «copilot» e hanno cominciato a dire «agente» o «lavoratore digitale». Ed è anche per questo che la distanza tra le promesse commerciali e la realtà operativa è diventata la questione centrale del settore. Una parte è reale e misurabile. Molto è ancora un progetto pilota accompagnato da un comunicato stampa.
I framework che fanno funzionare il sistema
Sotto i prodotti di marca c’è un insieme più ristretto di framework open source su cui è costruita, di fatto, la maggior parte dei sistemi agentici. LangGraph di LangChain, un livello di orchestrazione basato su grafi che concatena chiamate ai modelli, invocazioni di strumenti e diramazioni condizionali, è diventato il framework a cui le imprese si rivolgono quando hanno bisogno di verificabilità: poiché il flusso di lavoro è rappresentato da un grafo esplicito, gli ingegneri possono individuare il nodo preciso in cui un processo è fallito o è stato riportato a uno stato precedente. È importante quando il processo interviene sulla contabilità generale o sul conto di un cliente.
Secondo la misura più semplice del numero di stelle su GitHub, però, l’astrazione basata sui ruoli di CrewAI ha in realtà aumentato il proprio vantaggio su LangGraph: un promemoria del fatto che la popolarità tra gli sviluppatori e le preferenze delle imprese in fatto di architettura non sono la stessa cosa.
CrewAI ha scommesso sulla scelta opposta: invece di esporre il grafo, offre agli sviluppatori un’astrazione basata sui ruoli. Si definiscono un agente «ricercatore» e un agente «redattore», li si assegna a una squadra e si lascia che si passino i compiti. Questa semplicità si vede nella sua crescita: circa 2.800 stelle su GitHub a gennaio 2024 e 58.800 a settembre 2026, contro le 41.900 di LangGraph.
AutoGen di Microsoft ha seguito una terza strada, evolvendosi da prototipo di ricerca a runtime basato su eventi. Il suo successore, Microsoft Agent Framework, che riunisce AutoGen e Semantic Kernel, ha raggiunto la versione 1.0 disponibile a livello generale nell’aprile 2026, rivolgendosi espressamente ai team che hanno bisogno di agenti capaci di reagire a eventi asincroni anziché di eseguire uno script fisso.
OpenAI ha concentrato i propri strumenti intorno all’Agents SDK e ad AgentKit, uno strumento visuale per costruire flussi di lavoro agentici presentato alla sua conferenza per sviluppatori del 2025. Nell’aprile 2026 ha aggiunto la possibilità di eseguire codice in modo nativo in un ambiente isolato, consentendo a un agente di eseguire codice o comandi shell in quell’ambiente anziché nell’infrastruttura dello sviluppatore: una risposta diretta alla domanda che ogni team di sicurezza pone quando qualcuno propone per la prima volta di dare a un modello accesso alla shell.
OpenAI, in particolare, ha anche cominciato a ritirare parti della propria gamma di strumenti per agenti lanciate appena un anno prima: l’avviso di dismissione di Agent Builder, lo strumento senza codice, è stato pubblicato il 3 giugno 2026. La chiusura di Agent Builder, della piattaforma Evals e della Prompts API riutilizzabile è prevista per il 30 novembre 2026, indirizzando gli sviluppatori verso l’Agents SDK, che richiede di scrivere codice, o verso ChatGPT Workspace Agents. È un dato significativo di per sé: persino i fornitori stanno ancora scoprendo quali astrazioni reggano davvero nell’uso operativo.
MCP: l’infrastruttura su cui tutti si sono accordati
Se i framework divergono su come costruire un agente, c’è stata una convergenza insolita su come un agente debba comunicare con gli strumenti. Anthropic ha introdotto il Model Context Protocol (MCP) nel novembre 2024 come specifica aperta per collegare un modello a fonti di dati e strumenti esterni attraverso un’interfaccia standard, invece di lasciare che ogni fornitore scriva una propria integrazione su misura.
L’adozione è stata rapida per i tempi degli standard infrastrutturali: nel giro di circa diciotto mesi, MCP era supportato da Claude, ChatGPT, Microsoft Copilot, Cursor e dagli strumenti di Google per Gemini. Anthropic ha riferito di oltre 10.000 server MCP pubblici attivi e più di 97 milioni di download mensili degli SDK.
I conteggi effettuati al di fuori dell’azienda si collocano nello stesso ordine di grandezza e continuano a crescere: una rilevazione del registro ufficiale MCP del 24 maggio 2026 ha restituito 9.652 schede di server attuali, mentre il topic mcp-server di GitHub, che quel giorno comprendeva 15.926 repository, ne elenca 29.765 a settembre 2026. Un sondaggio di Stacklok condotto su 100 responsabili tecnici senior, pubblicato nel 2026, ha rilevato che il 41% delle loro organizzazioni utilizzava server MCP in produzione, su scala limitata o ampia.
Nel dicembre 2025, Anthropic ha affidato la governance del protocollo alla nuova Agentic AI Foundation della Linux Foundation, con la partecipazione di Block, Google, Microsoft, AWS, Cloudflare, Bloomberg e OpenAI. È stata una scelta deliberata per far apparire MCP come un’infrastruttura neutrale anziché come il formato proprietario di un singolo fornitore: lo stesso passo per costruire fiducia compiuto decenni prima da HTTP e TCP/IP.
Questa stessa apertura è anche il punto vulnerabile di MCP. Poiché la descrizione di uno strumento è semplicemente un testo che il modello legge e considera affidabile, i ricercatori di sicurezza hanno documentato attacchi di «avvelenamento degli strumenti», in cui un server MCP malevolo o compromesso inserisce nei metadati di uno strumento istruzioni nascoste che il modello segue senza che l’utente le veda mai. Una segnalazione del 2026 ha riferito che fino a 200.000 server MCP erano a rischio di compromissione completa tra IDE e servizi cloud; una scansione separata di Trend Micro ha individuato quasi 500 server MCP esposti a Internet senza alcuna autenticazione.
Da allora Anthropic ha rilasciato un’estensione Enterprise-Managed Authorization, che consente ai reparti IT di controllare centralmente a quali server MCP i dipendenti possono collegarsi: un segnale che lo standard sta superando l’assunto secondo cui ogni fornitore di strumenti è affidabile per definizione.
Dove la finanza sta davvero mettendo al lavoro gli agenti
I servizi finanziari si sono mossi più rapidamente della maggior parte degli altri settori, in parte perché i flussi di lavoro sono già incentrati su documenti e dati, in parte perché i fornitori hanno preso di mira proprio questo settore. A maggio 2026 Anthropic ha lanciato dieci template di agenti specifici per la finanza, distribuiti come plugin attraverso Claude Cowork e Claude Code. Coprono attività come la preparazione dei pitchbook, le verifiche KYC, l’analisi delle conference call sui risultati e la chiusura di fine mese, con comandi come /dcf, /comps e /lbo pensati per essere lanciati direttamente dal terminale di un analista.
Anthropic ha dichiarato che gli istituti finanziari rappresentano circa il 40% dei suoi 50 maggiori clienti per fatturato e ha citato Goldman Sachs, Citi, Visa e AIG tra quelli che hanno adottato i suoi prodotti. In questi annunci, però, «adottare» di solito significa aver stipulato un contratto aziendale a pagamento, non che ogni analista dell’istituto abbia un agente che costruisce i suoi modelli.
Le banche, dal canto loro, descrivono impieghi più graduali e circoscritti. JPMorgan ha dichiarato che la sua divisione di private banking usa sistemi di IA per esaminare l’attività dei mercati durante la notte, le posizioni dei clienti e le ricerche, così che i consulenti possano dedicare più tempo ai clienti. Ha inoltre attribuito in parte a questi strumenti un aumento del 20% delle vendite lorde della divisione: un dato riferito dalla banca, non verificato da una revisione indipendente.
JPMorgan ha anche dichiarato di voler impiegare agenti capaci di operare autonomamente per un’ora o due, rispetto alle sessioni di due o tre minuti tipiche degli strumenti attuali. È già di per sé un’indicazione di dove si trovi davvero la tecnologia: gli agenti oggi in produzione operano ancora, perlopiù, su intervalli brevi.
Morgan Stanley, separatamente, sta aprendo le sue piattaforme di gestione dei piani azionari — Shareworks ed Equity Edge — ad agenti di IA esterni gestiti dai suoi clienti aziendali. Partirà con una manciata di clienti iniziali e prevede di estendere l’accesso ai suoi circa 3.400 clienti dei servizi di gestione nel corso dell’anno successivo.
ServiceNow ha pubblicato uno dei confronti prima-dopo più concreti della categoria, ricavato dalle proprie operazioni finanziarie interne: una richiesta rivolta al team finanziario da un dipendente delle vendite, che prima richiedeva in media quattro giorni per essere risolta, ora viene risolta in circa otto secondi grazie a un flusso di lavoro con agenti e misure di sicurezza integrate. È un risultato reale, specifico e misurato internamente, non ipotetico. Ma è anche ServiceNow a misurare ServiceNow: vale la pena tenerlo presente quando si legge un caso di studio pubblicato da un fornitore, compreso questo.
Il problema dell’affidabilità che nessuno ha risolto
La riserva da tenere presente in tutto questo è che gli agenti restano inaffidabili in modi che contano sempre di più man mano che aumenta la loro autonomia. I benchmark accademici rendono concreto il divario. Tau-bench, un benchmark del 2024 basato su compiti realistici di assistenza clienti, articolati in più scambi, nei settori delle compagnie aeree e del commercio al dettaglio, ha rilevato che i modelli più avanzati di quell’anno portavano a termine correttamente appena la metà dei compiti al primo tentativo. La costanza dei risultati nei tentativi ripetuti sullo stesso compito — una metrica chiamata pass^k — era nettamente peggiore: i tassi di successo scendevano verso il 25% quando a un modello veniva chiesto di risolvere lo stesso compito in modo affidabile per otto volte consecutive.
I ricercatori che hanno sviluppato il benchmark hanno individuato uno schema ricorrente: un singolo piccolo errore all’inizio di un processo in più fasi — un arrotondamento sbagliato, un campo letto male — si propaga e invalida tutte le azioni successive, perché ogni passaggio dipende dalla correttezza del precedente. È proprio questa dinamica di accumulo degli errori a rendere un flusso di lavoro finanziario con una dozzina di passaggi interdipendenti un obiettivo più difficile per la piena autonomia rispetto a un compito che richiede una sola risposta a una domanda.
Da allora il benchmark è stato ricostruito due volte. τ²-bench (Barres e coautori, arXiv:2506.07982, giugno 2025) ha permesso anche all’utente, oltre che all’agente, di agire sull’ambiente e ha aggiunto un ambito delle telecomunicazioni, in cui l’agente deve guidare un cliente nell’esecuzione di una soluzione che non può attuare da sé; τ³-bench è seguito all’inizio del 2026, con compiti sottoposti a verifica, attività basate sul reperimento di informazioni, interazioni vocali e un ambito bancario. I punteggi grezzi sono saliti a ogni generazione — ai vertici della classifica testuale di τ²-bench, che combina commercio al dettaglio, compagnie aeree e telecomunicazioni, i risultati sono ormai intorno alla metà della fascia degli ottanta punti percentuali, con Qwen3.5-397B-A17B di Alibaba in testa all’87,9% di pass^1 — ma lo schema documentato dai ricercatori non è scomparso. Il successo continua a diminuire quando si ripete lo stesso compito e le telecomunicazioni, l’ambito in cui l’esito dipende dal fatto che l’utente faccia ciò che dice l’agente, sono rimaste il più difficile dei tre per ogni modello esaminato nello studio.
A livello organizzativo, uno studio del MIT pubblicato a metà del 2025 e ampiamente citato («The GenAI Divide», basato su interviste a 52 dirigenti, un sondaggio tra 153 responsabili e l’analisi di circa 300 implementazioni rese pubbliche) ha rilevato che il 95% dei progetti pilota aziendali di IA generativa non produceva alcun impatto misurabile su profitti e perdite. La stessa ricerca ha riscontrato una netta differenza tra gli approcci: i progetti pilota costruiti attorno a un fornitore esterno specializzato riuscivano in circa due terzi dei casi, contro circa un terzo per i progetti che le aziende cercavano di realizzare interamente al proprio interno. Secondo la formulazione del rapporto, le collaborazioni esterne avevano dunque un tasso di successo all’incirca doppio rispetto ai progetti interni: uno schema che aiuta a capire perché Salesforce, ServiceNow, Microsoft e Anthropic vendano tutti modelli preconfigurati per agenti, anziché limitarsi a offrire accesso diretto ai modelli.
| Risultato (MIT, «GenAI Divide», 2025) | Quota |
|---|---|
| Progetti pilota aziendali di IA generativa senza un impatto misurabile su profitti e perdite | 95% |
| Progetti pilota costruiti attorno a un fornitore esterno specializzato che hanno avuto successo | circa due terzi |
| Progetti pilota realizzati interamente all’interno dell’azienda che hanno avuto successo | circa un terzo |
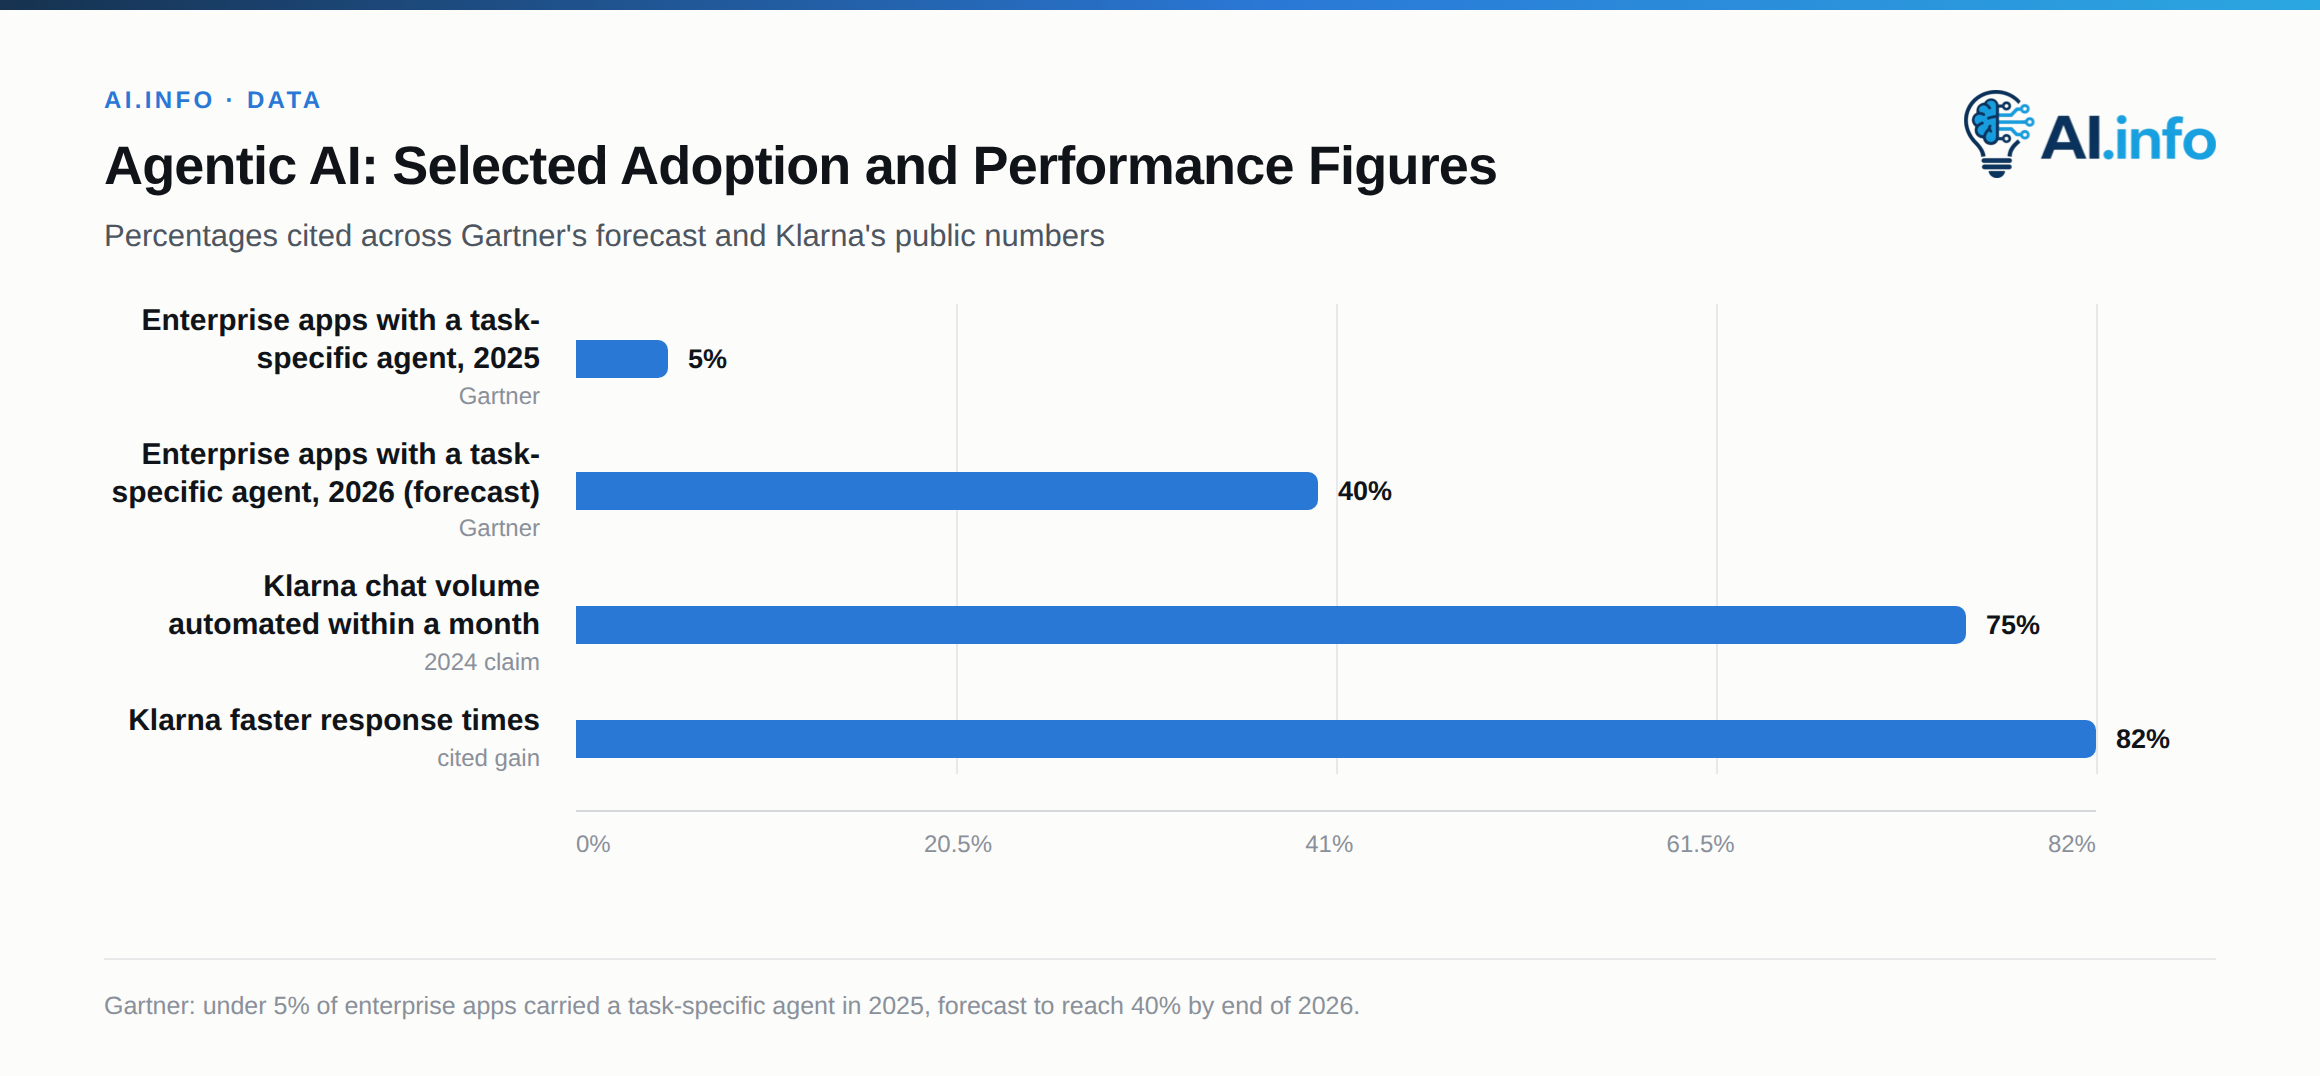
Il pubblico ripensamento di Klarna è il caso ammonitore più citato del settore, e vale la pena essere precisi su ciò che è accaduto. Nel febbraio 2024, la società di servizi «compra ora, paga dopo» ha dichiarato che il suo assistente di IA gestiva un carico di lavoro equivalente a quello di 700 addetti all’assistenza clienti e che, entro un mese dal lancio, aveva assunto la gestione di due terzi delle chat.
Nel 2025 l’azienda ha iniziato a fare marcia indietro: l’amministratore delegato Sebastian Siemiatkowski ha detto ai giornalisti che aver dato troppo peso ai costi come criterio di valutazione aveva danneggiato la qualità del servizio, e Klarna ha ricominciato ad assumere addetti all’assistenza per gestire i casi emotivamente delicati e quelli articolati in più passaggi con cui l’IA aveva difficoltà. La posizione attuale dell’azienda non è un abbandono dell’automazione — il suo assistente ha gestito l’80% delle chat dell’assistenza clienti nel 2025 e Klarna cita miglioramenti concreti, come richieste risolte in meno di due minuti anziché undici — ma il passaggio a un modello deliberatamente ibrido, in cui gli esseri umani intervengono dove l’agente non riesce.
È lo schema che emerge in tutto il settore: si sperimenta la piena autonomia, i problemi di qualità affiorano nei casi più difficili e si reinserisce, di solito senza clamore, un livello di supervisione umana.
| Metrica dell’assistente di IA di Klarna | Valore |
|---|---|
| Carico di lavoro equivalente dichiarato (febbraio 2024) | 700 addetti umani |
| Volume di chat automatizzato entro un mese (dichiarazione iniziale) | due terzi |
| Chat dell’assistenza clienti gestite dall’assistente (2025) | 80% |
| Tempo di risoluzione delle richieste (dichiarazione iniziale) | meno di 2 minuti, rispetto agli 11 minuti precedenti |
Che cosa significa per le aziende acquirenti
Per il 2026, la conclusione pratica è che l’IA agentica è una realtà, ma ha un campo d’applicazione più ristretto di quanto suggerisca il marketing del settore. I framework e i protocolli — LangGraph, CrewAI, AutoGen, l’Agents SDK, MCP — sono ormai abbastanza convergenti da rendere la costruzione di un agente un problema ingegneristico risolto, a differenza di due anni fa. A non essersi consolidata è la fiducia nel lasciare che questi agenti operino senza supervisione in attività che possono avere conseguenze finanziarie o reputazionali.
Le implementazioni che funzionano davvero hanno caratteristiche comuni: un ambito circoscritto, periodi di autonomia limitati a minuti anziché ore, una verifica umana prima di qualsiasi azione irreversibile e un’infrastruttura di valutazione. Microsoft Copilot Studio, per esempio, considera ora esplicitamente i propri modelli di valutazione come sistemi che richiedono a loro volta test e monitoraggio, sulla base del principio che un agente è affidabile solo quanto il sistema che ne valuta i risultati.
La previsione di Gartner secondo cui il 40% delle applicazioni aziendali includerà un agente specifico per determinate attività entro la fine del 2026, rispetto a meno del 5% nel 2025, probabilmente coglie la direzione di marcia. Che questi agenti preparino la documentazione KYC perché una persona la controlli, oppure autorizzino direttamente la transazione, è la distinzione che determinerà se questa fase del software aziendale produrrà un autentico aumento della produttività o finirà per aggiungersi al cimitero dei progetti pilota.