Guide pratiche
Implementare l’inferenza ML in tempo reale
Come costruire sistemi di inferenza ML a bassa latenza che restituiscono previsioni in pochi millisecondi. Il testo tratta l’ottimizzazione dei modelli, le architetture di serving, la cache e l’ottimizzazione delle prestazioni.
AI.info Team ·
Partire dal budget di latenza, non dal modello
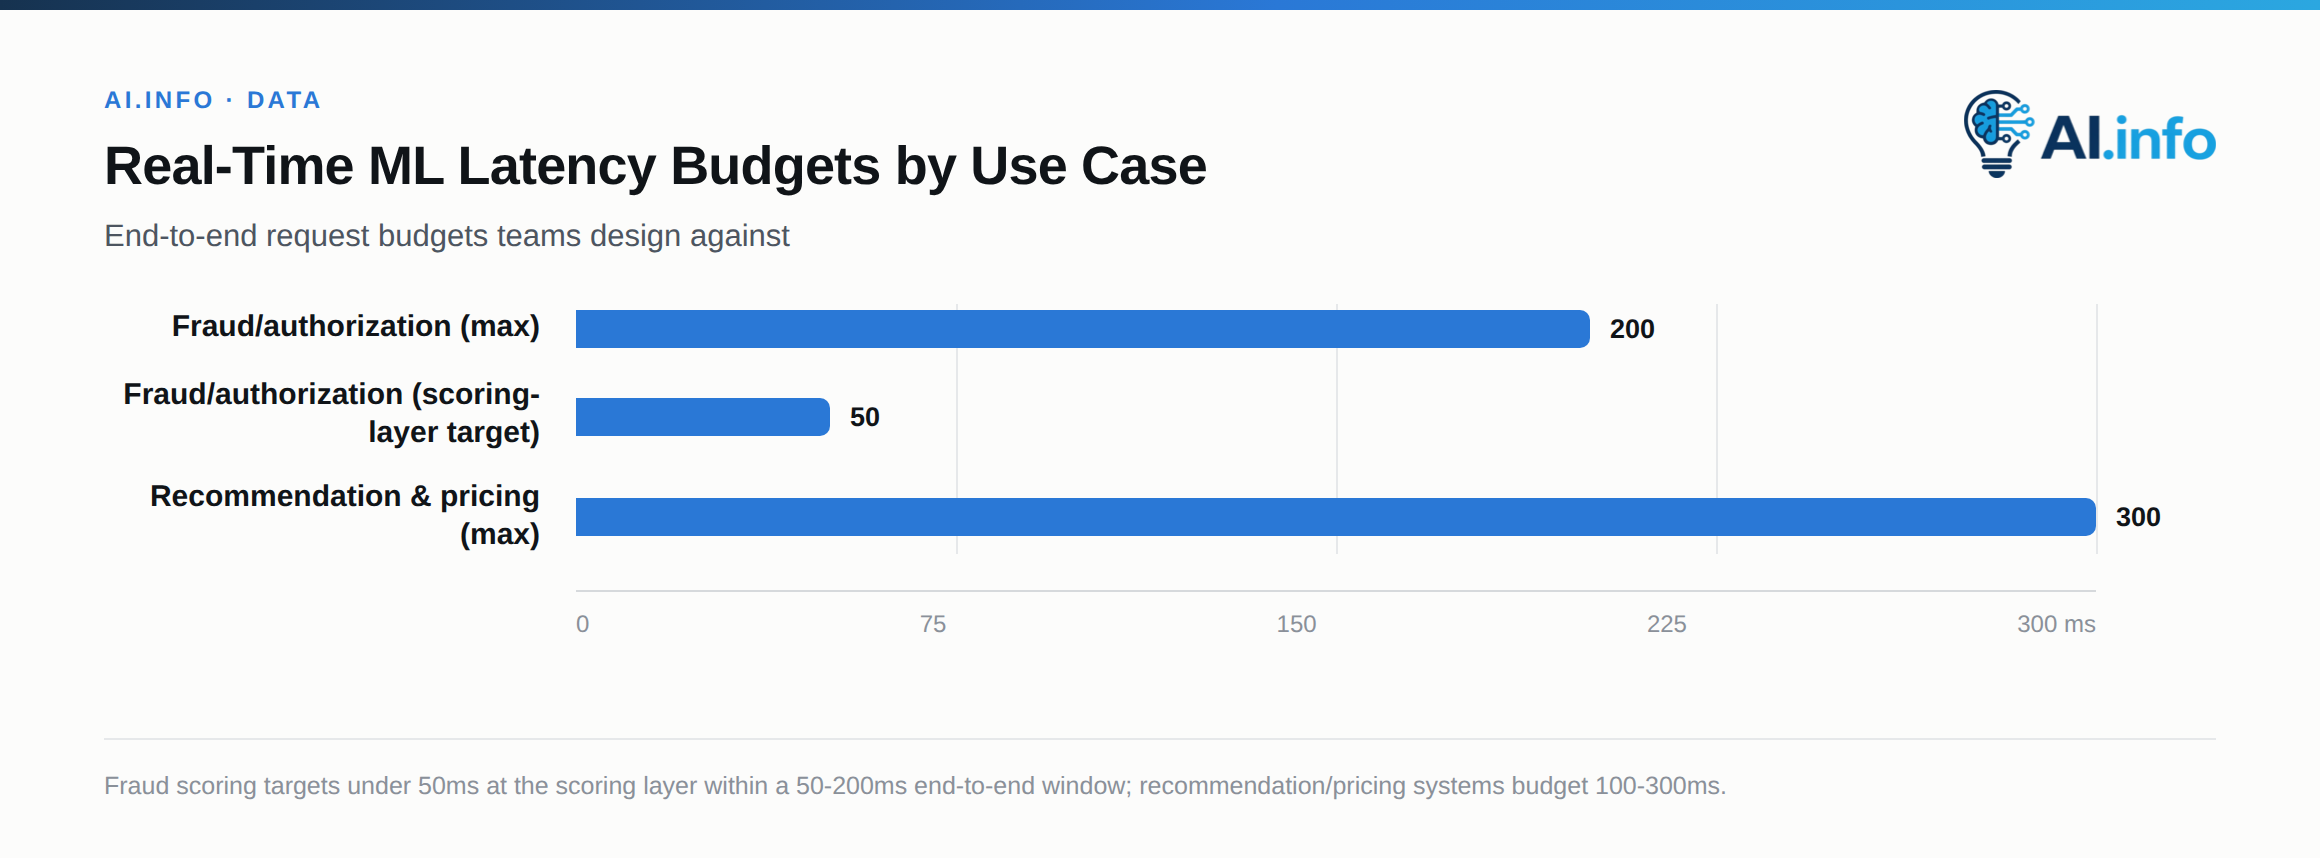
L’inferenza ML in tempo reale è un problema di sistemi travestito da problema di modellazione. Prima di scegliere un framework, scomponete lo SLA in un budget per ogni passaggio compiuto dalla richiesta. Per l’attribuzione di un punteggio di rischio frode e casi d’uso analoghi nel percorso di autorizzazione, il budget di latenza end-to-end al p99 è in genere di 100-200 ms; i team esperti puntano a meno di 50 ms per la sola attribuzione del punteggio, lasciando margine per il transito in rete, l’arricchimento delle feature e la logica che determina le azioni successive.
I sistemi di raccomandazione e di definizione dei prezzi sono di solito più tolleranti (100-300 ms end-to-end), ma la disciplina nel definire il budget è identica: assegnate un numero di millisecondi alla rete, al recupero delle feature, al pre-processing, al passaggio in avanti del modello, al post-processing e alla serializzazione. Trattate ogni voce come un vincolo di progettazione, non come un dettaglio a cui pensare dopo.
La criticità da prevenire è la latenza di coda, non quella media. Un modello che impiega in media 8 ms ma arriva a 400 ms sotto carico violerà continuamente gli SLA, perché una singola richiesta rivolta all’utente spesso si dirama in più chiamate al modello, ognuna delle quali può essere quella lenta. Ottimizzate e monitorate il p99 (e spesso il p99,9), non la media o il p50.
Aggiornamento delle feature: il feature store online
Nei modelli per il rilevamento delle frodi, le raccomandazioni e la definizione dei prezzi, gran parte delle informazioni utili proviene da feature calcolate altrove (aggregati, embedding, contatori) e associate al momento della richiesta, non soltanto dai dati grezzi della richiesta. Di conseguenza, il collo di bottiglia è spesso il feature store, non il modello. L’infrastruttura deve fornire le feature in pochi millisecondi per lasciare al modello una parte del budget; se il recupero delle feature consuma il budget, i team sono costretti a usare modelli più semplici, con un aumento diretto delle frodi non rilevate o un peggioramento delle raccomandazioni.
Feast è il principale feature store open source per questo schema. La sua architettura si divide nettamente in:
- Store offline (BigQuery, Snowflake, Parquet su S3) per recuperare le feature storiche durante l’addestramento.
- Store online (Redis, DynamoDB o SQLite per lo sviluppo) per recuperare con bassa latenza i valori più recenti delle feature durante l’inferenza.
- Un processo di materializzazione/push che mantiene lo store online sincronizzato con i valori calcolati delle feature, così da non dover ricalcolare gli aggregati nel percorso della richiesta.
La scelta dello store conta più di quanto molti team si aspettino. I benchmark condotti da Feast hanno individuato in Redis, servito tramite il server Java gRPC, la combinazione di gran lunga più veloce; uno studio di ottimizzazione del giugno 2026, condotto su un pod Redis autonomo, ha misurato un p99 di 4,61 ms per il recupero di una singola riga tramite il feature server REST, con 718 richieste al secondo per pod, e di 1,70 ms con vettori di feature precalcolati. DynamoDB è una ragionevole alternativa gestita per chi vuole evitare di gestire Redis, ma è prevedibile che abbia una latenza di coda superiore. Anche AWS descrive ElastiCache per Redis come un’architettura di «feature store online a latenza bassissima» proprio per questo caso d’uso.
| Store | Metrica | Valore |
|---|---|---|
| Redis (feature server REST di Feast, ottimizzato) | p99, recupero di una singola riga | 4,61 ms |
| Redis (feature server REST di Feast, un pod) | Throughput | 718 richieste/sec |
| Redis (vettori di feature precalcolati) | p99, recupero di una singola riga | 1,70 ms |
Regole pratiche:
- Precalcolate e materializzate gli aggregati (conteggi su finestre mobili, embedding, feature di velocità) a intervalli regolari o tramite streaming: non calcolateli mai in modo sincrono nel percorso della richiesta.
- Collocate lo store online insieme al livello di serving per evitare passaggi tra zone di disponibilità (AZ); poche centinaia di microsecondi di latenza di rete si sommano quando occorre recuperare decine di feature.
- Usate un’unica operazione multi-get in batch per tutte le feature necessarie a una richiesta, anziché N chiamate sequenziali.
Framework per servire i modelli
Oggi tre strumenti coprono la maggior parte dei servizi self-hosted di inferenza in tempo reale: la scelta dipende dalla varietà dei framework, dall’hardware di destinazione e dalle dimensioni del team. Un quarto figurava un tempo in questo elenco, ma ne è uscito.
NVIDIA Triton Inference Server è la scelta predefinita quando serve usare le GPU in modo efficiente con più framework (ONNX, TensorRT, PyTorch, TensorFlow e persino backend Python personalizzati) dietro un unico server. Le sue due funzionalità principali per i carichi di lavoro in tempo reale sono:
- Batching dinamico — Triton mette in coda le richieste in arrivo per un intervallo configurabile tramite
max_queue_delay_microsecondse le raggruppa in batch, puntando apreferred_batch_sizequando è configurato. Si accetta così una breve attesa aggiuntiva in cambio di un utilizzo molto migliore della GPU. Un tutorial di NVIDIA su Triton mostra che, con 16 richieste concorrenti su una A100, il batching dinamico riduce la latenza p99 del 69% (da 34,2 ms a 10,7 ms) e aumenta il throughput di 3,3 volte (da 975 a 3.188 inferenze al secondo), con un picco di utilizzo della GPU del 74%. Il parametro da regolare è il tempo di attesa in coda: se è troppo lungo, si supera il limite di latenza; se è troppo breve, i batch non si riempiono mai.
| Metrica (16 richieste concorrenti, A100) | Prima | Dopo |
|---|---|---|
| Latenza p99 | 34,2 ms | 10,7 ms |
| Throughput | 975 inferenze al secondo | 3.188 inferenze al secondo |
- Esecuzione concorrente dei modelli — più istanze di modelli (o più copie dello stesso modello) vengono eseguite in parallelo sulla stessa GPU tramite gli stream CUDA, così un modello lento non blocca quelli che lo seguono.
TorchServe non è più un’opzione. Lo strumento ufficiale di PyTorch per servire i modelli recava dal 2024 un avviso di manutenzione limitata e il repository pytorch/serve è stato archiviato il 7 agosto 2025: è di sola lettura, senza aggiornamenti, correzioni di bug, nuove funzionalità o patch di sicurezza in programma, e con un’avvertenza esplicita che le vulnerabilità potrebbero non essere risolte.
Le versioni esistenti si installano ancora e continuano a gestire il traffico. Per un team che oggi usa TorchServe, quindi, la domanda non è se funzioni, ma chi lo aggiornerà quando verrà individuata una CVE in una delle sue dipendenze. Va considerato un sistema da cui migrare entro una scadenza, non una scelta predefinita. Le alternative più comuni sono il backend PyTorch di Triton, per le flotte di GPU che già richiedono il supporto di più framework, e BentoML, per i team che vogliono una gestione operativa meno complessa rispetto a Triton.
BentoML punta alla rapidità di sviluppo ed è la destinazione più comune per i team che usano solo PyTorch e lasciano TorchServe: consente di impacchettare un modello insieme al codice di preprocessing in un «Bento», distribuirlo come container o su una piattaforma gestita e attivare e configurare il batching adattivo. Secondo benchmark pubblicati, BentoML sostiene oltre 1.000 richieste al secondo con una latenza p95 inferiore a 50 ms su un carico di lavoro della classe di ResNet50 con hardware di fascia contenuta: prestazioni sufficienti per la maggior parte dei servizi in tempo reale non basati su LLM e, per i piccoli team, un percorso verso la produzione molto più breve rispetto alla messa in funzione di Triton.
Ray Serve è lo strumento giusto quando il «modello» è in realtà una pipeline — trasformazione delle feature, retrieval, modello di ranking, post-elaborazione basata su regole di business — distribuita su più deployment che devono poter scalare in modo indipendente. I deployment di Ray Serve vengono eseguiti come attori Ray e il suo autoscaler regola il numero di repliche confrontando il numero medio di richieste in corso per replica con il valore configurato di target_ongoing_requests, entro i limiti fissati da min_replicas/max_replicas. Quando si compongono più modelli, ogni deployment della catena presenta in genere caratteristiche diverse di latenza e concorrenza: i parametri di autoscaling vanno quindi regolati per ciascun deployment, non a livello globale.
# Ray Serve: two-stage pipeline, each deployment autoscales independently
from ray import serve

@serve.deployment(
    autoscaling_config={
        "min_replicas": 2,
        "max_replicas": 20,
        "target_ongoing_requests": 4,
    }
)
class FeatureEnricher:
    async def __call__(self, request):
        ...  # feature-store lookups

@serve.deployment(
    autoscaling_config={"min_replicas": 4, "max_replicas": 50, "target_ongoing_requests": 2},
    ray_actor_options={"num_gpus": 0.25},
)
class Scorer:
    async def __call__(self, features):
        ...  # model.forward()
Compilazione e quantizzazione del modello
Prima di aumentare il numero di repliche, conviene ridurre il costo di ogni richiesta. Le leve sono due e di solito si usano insieme:
Esportazione in ONNX + ONNX Runtime separa il formato usato per servire il modello dal framework di addestramento e consente ottimizzazioni a livello di grafo (fusione degli operatori, constant folding) indipendenti dal backend hardware.
TensorRT (direttamente o come provider di esecuzione di ONNX Runtime) compila il grafo in un motore specifico per l’hardware. Gli incrementi di velocità riportati variano molto a seconda dell’architettura, ma sono sistematicamente elevati: per le CNN della classe di ResNet50, sono stati misurati motori TensorRT INT8 circa 3,7 volte più veloci rispetto a FP32, e la quantizzazione INT8 produce in genere incrementi tra 2 e 4 volte con una perdita minima di accuratezza, se calibrata correttamente. Per ottenere l’aumento di velocità dei Tensor Core serve hardware che supporti INT8 — tutti gli acceleratori NVIDIA per data center da Turing in poi, dal T4 a Hopper e Blackwell — e, prima del deployment, occorre una fase di calibrazione (si fanno passare dati rappresentativi nel modello FP32 per calcolare le scale di quantizzazione). Saltare la calibrazione e limitarsi a convertire i pesi peggiora l’accuratezza senza che il problema sia immediatamente evidente.
Con gli acceleratori attuali, il limite inferiore è sceso sotto INT8. I Tensor Core di quarta generazione di Hopper (H100, H200) hanno introdotto FP8; la quinta generazione di Blackwell (B200, B300) aggiunge FP4, che Hopper non supporta. Per l’hardware acquistato negli ultimi due anni, la domanda non è se quantizzare, ma per quale formato a meno di 8 bit effettuare la calibrazione. Il rigore richiesto per la calibrazione resta lo stesso.
La sequenza pratica è questa: prima esportare in ONNX e verificare su un insieme di dati tenuto da parte la parità numerica rispetto al modello nel framework di addestramento; poi quantizzare e verificare di nuovo la parità, prima di passare a TensorRT. A ogni passaggio l’accuratezza può peggiorare, e individuare la causa di un problema che combina esportazione e quantizzazione è molto più difficile che esaminare i due passaggi separatamente.
Cache, batching e riduzione del carico
Tre interventi poco costosi prima di ricorrere ad altro hardware:
- Cache a livello di richiesta. Se la stessa coppia (utente, articolo) o lo stesso schema di transazione riceve ripetutamente un punteggio in un breve intervallo, metti il punteggio in cache con un TTL breve (secondi, non minuti, per le frodi e i prezzi, dove usare dati non aggiornati ha un costo). Mettere in cache i punteggi è l’ottimizzazione più efficace per il riordinamento delle raccomandazioni, in cui l’insieme dei candidati cambia appena da una richiesta all’altra.
- Cache delle caratteristiche separata dalla cache delle previsioni. Anche quando la previsione finale non può essere messa in cache (perché i candidati cambiano a ogni chiamata), di solito possono esserlo le caratteristiche dell’utente e dell’articolo, riducendo le chiamate al feature store.
- Batching adattivo/dinamico sul server, come descritto sopra per Triton e BentoML: è il meccanismo che permette di ottenere più capacità di elaborazione dalle GPU senza acquistarne altre, al costo di qualche millisecondo di attesa in coda.
- Riduzione del carico e timeout. Ogni percorso in tempo reale ha bisogno di un’alternativa esplicita: un’euristica veloce o l’ultimo punteggio valido noto, conservato in cache, da restituire quando il modello principale non riesce a rispondere entro la porzione di tempo a sua disposizione. Attendere senza limiti che il modello risponda è il modo in cui una sola dipendenza lenta provoca un’interruzione completa del servizio.
Autoscaling e capacità per i picchi di traffico
Il traffico ML in tempo reale è per sua natura irregolare (vendite lampo, gruppi dediti alle frodi che testano carte a ondate, picchi di raccomandazioni legati a notizie dell’ultima ora), quindi l’autoscaling basato soltanto sull’utilizzo di CPU/GPU reagisce troppo tardi: l’utilizzo aumenta solo quando la coda si è già accumulata. È preferibile basare l’autoscaling su un indicatore anticipatore:
- Ray Serve effettua l’autoscaling in base alle richieste in corso per replica, un indicatore indiretto della lunghezza della coda, anziché all’utilizzo grezzo.
- Per Triton dietro Kubernetes, dimensiona la capacità in base al tempo di attesa delle richieste in coda o all’utilizzo della GPU esposto tramite Prometheus/DCGM, mantenendo un numero minimo di repliche già pronte, sufficiente ad assorbire il tempo necessario all’aumento della capacità (avvio del container più caricamento del modello) senza violare gli SLA.
- Mantieni il numero minimo di repliche abbastanza alto da superare il ritardo nell’aumento della capacità: i pod con GPU che caricano pesi di modello di diversi gigabyte possono impiegare decine di secondi prima di essere pronti, un’eternità rispetto a uno SLA di 100ms.
Sicurezza del rilascio: shadow e canary
Non indirizzare mai il 100% del traffico di produzione verso un modello appena distribuito. Due approcci complementari:
- Traffico shadow (dark) — duplica le richieste live e inviale al nuovo modello, registra le sue previsioni, ma fornisci le risposte del modello attualmente in produzione. Lo shadowing permette di verificare latenza e distribuzione degli output sotto carico reale senza rischi per gli utenti ed è l’unico modo per individuare le derive del feature store o i bug di serializzazione che sfuggono agli unit test.
- Rilascio canary — indirizza una piccola percentuale (1-5%) del traffico live verso la nuova versione del modello e confronta le metriche di business (tasso di approvazione, tasso di clic, tasso di individuazione delle frodi) e i percentili di latenza con quelli del modello in uso prima di aumentare gradualmente la quota. Strumenti nativi per Kubernetes come KServe o Seldon Core supportano i rilasci canary con ripartizione del traffico.
Monitorare ciò che conta davvero
Misura separatamente ogni passaggio, non solo la richiesta nel suo complesso:
- Latenza p50/p95/p99/p99.9 suddivisa per fase: recupero delle caratteristiche, preelaborazione, passaggio forward del modello, postelaborazione.
- Utilizzo della GPU/dell’acceleratore e lunghezza della coda (sia Triton sia Ray Serve espongono nativamente metriche Prometheus).
- Deriva nella distribuzione delle previsioni: un modello che restituisce punteggi concentrati in una fascia sospettosamente ristretta è spesso il primo segnale di una pipeline delle caratteristiche con dati non aggiornati o malfunzionante, ben prima che le metriche di accuratezza lo rilevino.
- Mancato aggiornamento delle caratteristiche: tempo trascorso dall’ultima scrittura per ciascuna chiave delle caratteristiche nell’archivio online; se questa metrica cresce, il processo di materializzazione sta accumulando ritardo e ogni punteggio prodotto a valle usa, senza che sia evidente, i dati di ieri.
Errori comuni da riconoscere
- Ricalcolare le caratteristiche aggregate in modo sincrono nel percorso della richiesta. Se una caratteristica «in tempo reale» richiede di esaminare le transazioni recenti al momento dell’inferenza, non è un feature store: è una query al database che si spaccia per feature store. E non appena il volume crescerà, assorbirà gran parte del tempo a disposizione.
- Usare il batching per impostazione predefinita quando il carico consiste in richieste singole per le quali la latenza è critica. Il batching dinamico aiuta i carichi GPU limitati dalla capacità di elaborazione; con un limite rigido di 20ms e una bassa concorrenza, qualche millisecondo di attesa in coda può costare più di quanto faccia risparmiare. Misura prima di abilitarlo.
- Considerare la quantizzazione gratuita. INT8 senza calibrazione, o calibrato su dati non rappresentativi, riduce senza che sia evidente l’accuratezza nei casi rari (schemi di frode poco frequenti, articoli senza dati pregressi) proprio dove conta di più: verifica il risultato su un insieme di dati tenuto da parte che includa classi rare, non soltanto sull’accuratezza aggregata.
- Nessun percorso alternativo. Ogni modello in tempo reale ha bisogno di un comportamento documentato e testato per il caso «il modello non ha risposto in tempo» che non sia «bloccare la richiesta dell’utente».