Guide pratiche
L’economia dell’inferenza: quantizzazione, speculative decoding e l’arte di servire gli LLM a basso costo
PagedAttention, continuous batching, costi della cache KV, quantizzazione, speculative decoding, instradamento MoE e fasce di prezzo per i batch: perché il costo minimo per token continua a scendere, mentre sopra di esso è tornata una fasci
AI.info Team ·
Perché l’inferenza assorbe ormai il budget per l’IA
L’addestramento conquista i titoli; l’erogazione presenta il conto. Secondo le stime del settore, l’inferenza rappresenta il 55-80% della spesa delle imprese per le GPU destinate all’IA. Gli analisti che monitorano la fatturazione dell’infrastruttura cloud affermano che, all’inizio del 2026, l’inferenza ha superato il 55% della spesa per l’IA nel cloud, sorpassando per la prima volta l’addestramento. Il problema emerge nelle call sui risultati finanziari, non solo nei benchmark: Marc Benioff, CEO di Salesforce, ha detto nel podcast All-In che Salesforce è sulla traiettoria per spendere 300 milioni di dollari in token di Anthropic nel 2026; Bill McDermott, CEO di ServiceNow, ha parlato pubblicamente di clienti «sorpresi dalla tokenizzazione dei modelli» quando le fatture basate sull’utilizzo incidono sui loro budget.
L’addestramento è una spesa in conto capitale una tantum, ammortizzata su tutte le richieste che un modello servirà. Ciascuna di quelle richieste comporta una chiamata di inferenza distinta e, su larga scala, il loro numero fa impallidire il costo dell’addestramento: una sola funzione di chat molto usata o uno strumento di programmazione agentica può generare in un mese più token di quanti ne abbia richiesti l’intero preaddestramento.
L’inferenza è inoltre soggetta a vincoli di latenza che l’addestramento non ha: un processo di addestramento può attendere in coda, ma un utente che fissa un indicatore di caricamento no. Questo impone di predisporre capacità in eccesso rispetto al carico medio, per far fronte ai picchi. Ogni tecnica descritta di seguito agisce su una di tre leve: ridurre il calcolo per token, ridurre la memoria per token oppure ridurre il numero di token da calcolare.
Il crollo dei prezzi e il ritorno di una fascia superiore
La prova più evidente che l’erogazione è diventata molto più efficiente è il prezzo di listino. GPT-4 è stato lanciato nel 2023 a 30 dollari per milione di token in input e 60 dollari per milione di token in output. GPT-5.1 è ancora a listino a 1,25/10 dollari per milione di token in input/output: un calo di 24 volte per l’input e di 6 volte per l’output, per un modello che ottiene nei benchmark risultati nettamente superiori all’originale del 2023.
GPT-5.1 non è più il modello di punta nel listino di OpenAI, e i modelli che lo precedono non costano meno. Nella famiglia GPT-5.6, Sol, il modello di punta, è a listino a 4/20 dollari per milione di token per i contesti brevi e a 8/30 dollari oltre tale soglia; Terra a 2/12 dollari; e Luna, la fascia più piccola, a 0,20/1,20 dollari. È con Luna che il crollo è proseguito — il suo prezzo dell’input è 150 volte inferiore a quello di GPT-4 — mentre Sol costa per token più di GPT-5.1.
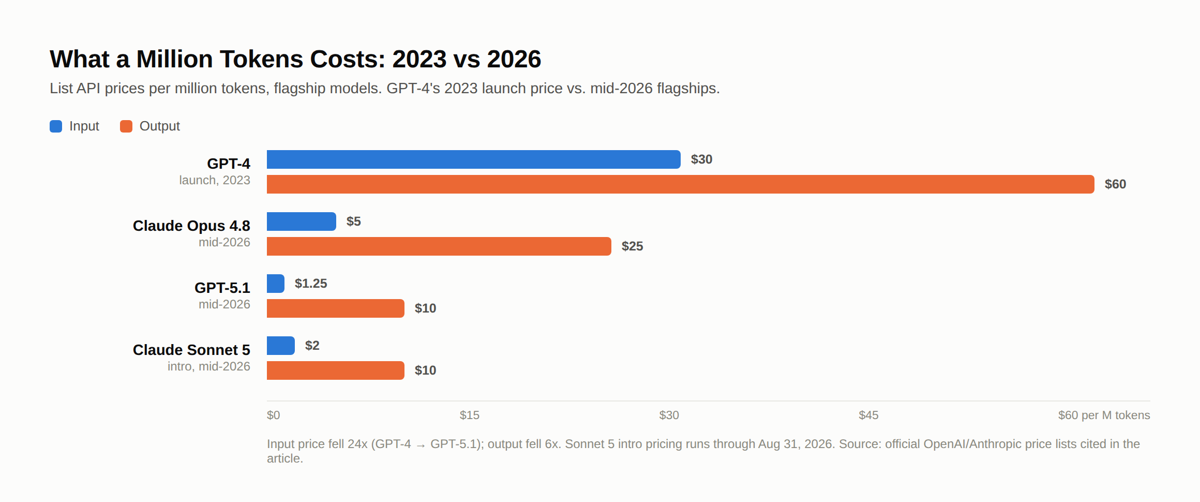
I prezzi di Anthropic raccontano la stessa storia a due facce. Opus 5 e Opus 4.8 sono entrambi a listino a 5/25 dollari per milione di token. Claude Sonnet 5 costa 2/10 dollari e quello che era stato presentato come prezzo introduttivo è ora il prezzo standard: Anthropic afferma che l’aumento a 3/15 dollari previsto per il 1° settembre 2026 non avrà luogo. Pur essendo un modello più potente, Sonnet 5 costa ancora 6 volte meno del prezzo originale dell’output di GPT-4.
Al di sopra di tutti si colloca una fascia che non esisteva quando questa curva è stata tracciata per la prima volta: Claude Fable 5.1 a 10 dollari per milione di token in input e 50 dollari per milione di token in output, e Mythos 5.1 con prezzi a partire dagli stessi importi. Anche la modalità fast di Opus 5 e Opus 4.8 ha gli stessi prezzi. Il prezzo minimo continua a scendere e il tetto è stato ricostruito più in alto. Fare un budget basandosi sull’idea che «i prezzi scendono e basta» significa prevedere i costi della fascia usata l’anno scorso, non di quella che il responsabile di prodotto vuole quest’anno.
Anche i confronti del prezzo per token tra generazioni sono meno netti di quanto sembrino. Anthropic osserva che Claude 4.7 e i modelli successivi usano un tokenizer più recente, che produce circa il 30% di token in più per lo stesso testo. Un taglio del prezzo per token non equivale a un taglio del prezzo per attività svolta, e l’unico dato di cui fidarsi è quello della propria fattura.
Non è beneficenza: è l’effetto cumulativo di chip migliori (H100 e ora Blackwell), software di erogazione più evoluto e formati di quantizzazione che al lancio di GPT-4 non esistevano. È l’ingegneria alla base del resto di questo articolo, e una curva che si può sfruttare anche gestendo i modelli sulla propria infrastruttura.
Lo stack di serving: vLLM, SGLang e TensorRT-LLM
vLLM, sviluppato alla UC Berkeley (paper presentato a SOSP 2023), è diventato il motore open source di riferimento per il serving per un motivo: PagedAttention. L’allocazione tradizionale della cache KV riserva per ogni richiesta un buffer contiguo dimensionato sulla lunghezza massima della sequenza. Questo spreca memoria GPU a causa della frammentazione: la maggior parte delle richieste non raggiunge mai quella lunghezza, ma la memoria viene comunque riservata. PagedAttention riprende il meccanismo di paginazione dei sistemi operativi: suddivide la cache KV in piccoli blocchi non contigui, di dimensione fissa, allocati quando servono, così come la memoria virtuale mappa la RAM fisica. La riduzione dello spreco di memoria riportata arriva fino al 90%.
La seconda idea fondamentale è il continuous batching (batching in-flight o a livello di iterazione). Il batching ingenuo elabora un batch fisso durante la decodifica finché tutte le sequenze non sono terminate. Un batch di 32 richieste procede quindi al ritmo della sequenza più lenta, lasciando inattive le risorse della GPU destinate alle richieste concluse prima. Il continuous batching pianifica invece il lavoro a livello di singolo passo di decodifica: a ogni forward pass, lo scheduler rimuove le sequenze terminate e ne ammette di nuove dalla coda. Nel paper originale su vLLM è stato misurato un aumento del throughput di 2-4 volte, a parità di latenza, rispetto a sistemi all’avanguardia come FasterTransformer e Orca.
SGLang punta invece sui prefissi ripetuti (prompt di sistema condivisi, esempi few-shot, cronologie di conversazioni a più turni). La sua struttura RadixAttention conserva le voci della cache KV in un albero radix, così una nuova richiesta riutilizza automaticamente la cache del prefisso corrispondente più lungo già elaborato. I benchmark di SGLang riportano un throughput fino a 5 volte superiore a quello di vLLM e Guidance nei carichi di lavoro con molti prefissi condivisi; dati recenti su H100 con Llama-3.1-8B collocano SGLang a circa 16.200 token al secondo contro i 12.550 di vLLM, un vantaggio di circa il 29%. Sotto una sovrapposizione dei prefissi condivisi di circa il 60%, però, il vantaggio si riduce fino ad avvicinarsi alla parità.
TensorRT-LLM, il motore di Nvidia basato sul compilatore TensorRT, implementa nativamente batching in-flight, cache KV paginata, quantizzazione e decodifica speculativa attraverso un gestore dei batch in C++, oltre al prefill suddiviso in blocchi, che permette di alternare l’elaborazione dei prompt lunghi alla decodifica in corso. Richiede più lavoro di configurazione rispetto a vLLM o SGLang (bisogna creare engine specifici per ciascun modello), ma sfrutta al massimo l’hardware Nvidia ed è la scelta abituale una volta fissati il modello e la generazione di GPU per la produzione.
Cache KV: il costo in memoria che nessuno mette a budget
La cache KV conserva le proiezioni key e value di ogni token già elaborato, così il meccanismo di attention non deve ricalcolarle per ogni nuovo token. È questo che rende la decodifica autoregressiva lineare, anziché quadratica, rispetto alla lunghezza del testo generato. La cache è conservata per ciascuna sequenza, ciascun livello e ciascuna testa di attention, e cresce con ogni token generato o acquisito.
Esempio di calcolo (ipotesi esplicitate). Consideriamo un modello denso della classe 70B con 80 livelli e una dimensione nascosta di 8.192, in FP16 (2 byte per valore), senza grouped-query attention (il caso peggiore). La dimensione della cache KV per token è 2 (K e V) × 80 livelli × 8.192 dimensioni nascoste × 2 byte ≈ 2,62 MB per token. I modelli della classe 70B usati in produzione impiegano in genere la grouped-query attention, con un rapporto di circa 8:1 tra teste query e teste KV, riducendo la dimensione a circa 330 KB per token.
Per un singolo contesto di 32K token, sono comunque 330 KB × 32.768 ≈ 10,3 GB di HBM per una sequenza, prima ancora che arrivi un secondo utente contemporaneo. Su una H100 da 80 GB, quella sola richiesta con un contesto lungo occupa già un ottavo della memoria totale. È per questo che l’allocazione paginata, a livello di blocco, è preferibile alla prenotazione di un buffer contiguo dimensionato sul caso peggiore per ogni richiesta.
| Scenario (modello della classe 70B, FP16) | Cache KV per token |
|---|---|
| Senza grouped-query attention (caso peggiore) | ≈2,62 MB per token |
| Con grouped-query attention (rapporto di ~8:1) | ≈330 KB per token |
| Singolo contesto di 32K token (con GQA) | ≈10,3 GB totali |
Il prefix caching è la risposta economica allo stesso problema: se i primi N token di una richiesta coincidono con quelli di una richiesta precedente (un prompt di sistema, un documento RAG, lo schema di uno strumento), si leggono le voci della cache KV già memorizzate invece di ricalcolarle. Anthropic applica alle letture dalla cache una tariffa pari a 0,1 volte quella standard per l’input — uno sconto del 90% — mentre la scrittura costa 1,25 volte la tariffa standard con un TTL di 5 minuti o 2 volte con un TTL di 1 ora. Lo sconto si cumula con la riduzione del 50% della Batch API, quindi una richiesta in batch che usa la cache può costare appena il 5% di una richiesta senza cache alla tariffa standard. Per i modelli del livello Fable 5.1 e Mythos 5.1, la tariffa di lettura dalla cache è pari a 0,025 volte quella standard anziché a 0,1 volte: 0,25 dollari per milione di token contro una tariffa base di 10 dollari. Con gli sconti cumulati, il costo minimo scende così a circa l’1,25%.
OpenAI adotta un approccio equivalente: i prompt di almeno 1.024 token vengono memorizzati automaticamente nella cache su GPT-5.6 e sui modelli successivi (per i modelli precedenti dipende dalle impostazioni della richiesta). Sulla maggior parte di questi modelli, le richieste che trovano una corrispondenza nella cache godono di uno sconto del 90% rispetto alla tariffa standard per l’input, e sui restanti lo sconto arriva fino al 95%. Se un carico di lavoro presenta una qualsiasi struttura ripetuta — come accade per la maggior parte dei sistemi agentici e RAG — il prefix caching offre un vantaggio quasi gratuito, purché il contenuto stabile preceda quello variabile: qualsiasi modifica prima di un punto di interruzione della cache invalida tutto ciò che viene dopo.
Quantizzazione: da FP16 a FP8 a FP4/INT4
La quantizzazione riduce la precisione dei pesi (e talvolta delle attivazioni) per diminuire la memoria occupata e aumentare la capacità di calcolo: le operazioni a precisione inferiore sono più veloci sull’hardware progettato per eseguirle. Ogni passaggio richiede nuovo hardware e nuove tecniche di calibrazione, non soltanto un formato numerico più piccolo.
FP8 è supportato nativamente da Hopper (H100/H200): i Tensor Core di quarta generazione e il Transformer Engine eseguono direttamente i calcoli matriciali in FP8, offrendo sullo stesso chip un throughput dei Tensor Core pari a circa 2x quello di FP16 e dimezzando la memoria occupata. Per contenere la perdita di accuratezza, combinano automaticamente FP8 e FP16 a seconda dell’operazione. Nell’inferenza, la perdita di qualità rispetto a FP16 è in genere minima: una riduzione di precisione quasi «gratuita». Per questo FP8 è ormai pressoché lo standard per servire modelli di grandi dimensioni su flotte di GPU della classe H100.
INT4/FP4 comporta una riduzione più marcata e richiede una calibrazione più attenta. GPTQ (2022) è un metodo post-addestramento applicato in un solo passaggio che comprime i pesi a 3-4 bit mantenendo le attivazioni in FP16; usa una correzione dell’errore del secondo ordine per limitare il degrado. AWQ, invece, individua in base all’ampiezza delle attivazioni i canali dei pesi più importanti e li protegge in via prioritaria. Valutazioni indipendenti indicano che, a 4 bit, AWQ preserva l’accuratezza con maggiore costanza rispetto a GPTQ su modelli della famiglia Llama di diverse dimensioni, richiedendo meno dati di calibrazione. Nessuno dei due metodi è privo di costi: la quantizzazione a 4 bit riduce in misura rilevabile la qualità in alcuni compiti di ragionamento e nei casi meno comuni. Per questo, nelle implementazioni in produzione, si eseguono benchmark sul proprio insieme di valutazione anziché affidarsi a un valore aggregato di perplexity riportato in un paper.
FP4 è il passo più recente e dipende dall’hardware: il formato NVFP4 di Nvidia è supportato nativamente solo dai chip Blackwell (B200, B300, RTX 5090, RTX PRO 6000). Usa piccoli blocchi di microscaling da 16 valori, con fattori di scala dei blocchi in FP8 (e4m3), rendendo il calcolo a virgola mobile a 4 bit praticabile dal punto di vista numerico, non solo veloce. I benchmark di Nvidia su Llama-2-70B mostrano che Blackwell arriva a fornire fino a 4x i token/sec per GPU di H100, mentre Fireworks riferisce che il suo stack FireAttention V4 supera i 250+ token/sec per utente su B200. Ma questi vantaggi si ottengono solo dopo che una flotta è effettivamente passata da Hopper a Blackwell.
Decodifica speculativa, distillazione e modelli piccoli
La decodifica speculativa affronta un collo di bottiglia diverso: la decodifica autoregressiva è limitata dalla larghezza di banda della memoria e genera un token per ogni passaggio di inferenza, anche quando resta capacità di calcolo inutilizzata. Un modello di bozza piccolo ed economico propone diversi token successivi; il modello bersaglio, più grande, li verifica tutti in un unico passaggio di inferenza elaborato in batch, accettando quelli che avrebbe generato comunque. Quando le previsioni del modello di bozza sono buone, si ottiene così un’accelerazione nella generazione di più token.
Medusa ed EAGLE sono i due approcci dominanti. Entrambi addestrano teste di previsione aggiuntive sul modello bersaglio stesso, anziché usare un modello di bozza separato. I benchmark SpecBench indicano per entrambi un’accelerazione complessiva di circa 2,4x su una singola A100, che sale a circa 2,8x nelle conversazioni a più turni e nel ragionamento matematico: più il seguito è prevedibile, maggiore è il vantaggio. EAGLE-3 riporta accelerazioni di 2-6x a seconda delle dimensioni del modello e della configurazione dei batch; per i modelli più grandi (70B+) la tendenza è verso 4-6x, perché il costo aggiuntivo delle teste di previsione diventa trascurabile rispetto al risparmio sulla larghezza di banda della memoria. Nei benchmark di produzione su H100, EAGLE-3 supera EAGLE-2 e Medusa-2 del 15-25% in token/sec. DeepSeek-V3 addestra la previsione di più token direttamente nel modello di base, rendendo la decodifica speculativa una capacità integrata anziché un’aggiunta.
| Metodo | Accelerazione |
|---|---|
| Medusa / EAGLE (SpecBench, singola A100) | ~2,4x |
| Medusa / EAGLE (più turni, ragionamento matematico) | ~2,8x |
| EAGLE-3 (modelli 70B+) | 4-6x |
Distillazione e modelli piccoli riducono i costi dall’altro lato: non serve usare un modello grande per compiti che uno piccolo svolge abbastanza bene. Llama 3.2 offre varianti di solo testo da 1B e 3B per l’esecuzione su dispositivi periferici e a basso costo; Phi-3.5-Mini di Microsoft è un modello da 3,8B parametri ottimizzato per il ragionamento e il codice; Gemma 3 di Google è disponibile in una versione multilingue e multimodale da 4B.
Google ha reso noto che i suoi modelli Gemma 2 2B e 9B sono stati addestrati tramite distillazione della conoscenza da un modello insegnante più grande, migliorando in misura rilevabile la qualità rispetto all’addestramento da zero di modelli delle stesse dimensioni. Un modello distillato da 8B che raggiunge la soglia di qualità richiesta per un compito può costare 5-10x meno per token di un modello da 70B+, anche prima di applicare la quantizzazione o la decodifica speculativa.
Esecuzione dei modelli MoE e fascia batch/offline
Le architetture mixture-of-experts separano il numero di parametri dal costo computazionale per token. DeepSeek-V3 è l’esempio pubblico più chiaro: 671B parametri complessivi, ma solo 37B attivi per token. A ogni passaggio di inferenza lavora circa il 5,5% del modello. Ogni livello MoE ha 1 esperto condiviso e 256 esperti selezionabili tramite instradamento, di cui 8 vengono scelti per token con un instradamento top-k. A questo si aggiunge la multi-head latent attention (MLA), che riduce la memoria occupata dalla cache KV, altrimenti capace di vanificare il risparmio.
Secondo il rapporto tecnico di DeepSeek, il risultato è una qualità di livello pari a quella dei modelli più avanzati a circa un decimo del costo di addestramento di un modello denso con capacità comparabili. La stessa sparsità riduce anche il calcolo necessario per l’inferenza: per ogni token vengono eseguite solo le operazioni FLOP degli esperti attivi, anche se la memoria HBM deve contenere tutti gli esperti. Il compromesso dei modelli MoE si riassume così: usare più memoria GPU (per ospitare tutti gli esperti) in cambio di meno calcolo GPU (per eseguirne solo una parte). Per questo i modelli MoE richiedono GPU con molta memoria e batch di grandi dimensioni.
Le fasce batch/offline sono la leva più economica per tutto ciò che non richiede una bassa latenza. Sia Anthropic sia OpenAI offrono endpoint batch asincroni con uno sconto fisso del 50% sui token di input e di output; i risultati vengono in genere restituiti ben prima che trascorrano 24 ore. Per valutazioni, classificazioni su larga scala, aggiornamenti retroattivi degli embedding o elaborazione notturna di documenti, la modalità batch equivale quasi a un 2x gratuito sul costo. Inoltre, lo sconto batch di Anthropic si combina in modo moltiplicativo con il prompt caching: il costo di una richiesta elaborata in batch con prompt in cache può scendere a circa il 5% di quello di una richiesta senza cache alla tariffa standard.
Sviluppare o acquistare: quando conviene davvero gestire i modelli sulla propria infrastruttura
Per il noleggio delle H100 non esiste una tariffa unica di mercato, e i rilevamenti differiscono di oltre il doppio. Una rilevazione aggiornata ad agosto 2026 indica una fascia da 1,49 dollari/ora (una tariffa promozionale di Vast.ai) a 6,98 dollari/ora su Azure, una fascia intermedia di 2,89-3,90 dollari e nessuna media pubblicata, perché i fornitori propongono le H100 in nodi di dimensioni, regioni e fasce di servizio diverse. Un’altra rilevazione, riferita a settembre 2026, indica 2,89-11,06 dollari/ora, con una mediana vicina a 4,17 dollari per i cloud specializzati contro 7,89 dollari per gli hyperscaler. È proprio questa forbice il dato significativo: la scelta tra sviluppare e acquistare dipende da quale fornitore sia effettivamente disposto a venderti capacità, e gestire i modelli sulla propria infrastruttura conviene solo se quelle GPU restano occupate.
Esempio di calcolo (ipotesi esplicitate). Supponiamo di gestire sulla propria infrastruttura un modello della classe 70B in FP8 su 2 H100 SXM a 3,20 dollari/ora ciascuna (6,40 dollari/ora in totale), una tariffa pubblicata da un cloud specializzato. Il modello viene servito con batching continuo tramite vLLM e sostiene, per ipotesi illustrativa non verificata con un benchmark, una produzione aggregata di 2.000 token di output al secondo a pieno utilizzo. Sono 7,2 milioni di token all’ora, per un costo combinato di circa 0,89 dollari/Mtok limitato al noleggio delle GPU (esclusi i costi del lavoro ingegneristico).
Confrontiamo il risultato con un costo combinato per token di input e output in rapporto 3:1, calcolato sui prezzi standard di Claude Sonnet 5: (3×2 dollari + 1×10 dollari) / 4 = 4 dollari/Mtok. Con queste ipotesi, gestire il modello sulla propria infrastruttura sembra costare circa 4-5 volte meno, ma solo con un utilizzo vicino al 100%. Se l’utilizzo scende al 30% (un livello realistico per un traffico a picchi), il costo effettivo sale a circa 2,96 dollari/Mtok, cancellando gran parte del vantaggio prima ancora di conteggiare il team necessario per gestire vLLM in produzione e affrontare i guasti delle GPU. Il confronto, inoltre, non è a parità di token, perché il tokenizer più recente del modello ospitato fa addebitare più token per lo stesso testo.
La regola pratica è questa: gestire i modelli sulla propria infrastruttura conviene quando il traffico è elevato e costante e mantiene le GPU vicine alla saturazione — pipeline batch interne, funzionalità con molte richieste al secondo o modelli sottoposti a fine-tuning che nessun fornitore di API offre. Le API convengono quando il traffico ha picchi, quando serve una qualità di frontiera che nessun modello aperto raggiunge o quando i volumi sono troppo bassi per tenere occupato un parco di GPU. La maggior parte dei team sottovaluta quest’ultima condizione e paga ore di GPU inattive che, con la cache attiva, sarebbero costate meno sotto forma di chiamate API.
A settembre 2026, la maggior parte dei grandi cloud è ancora nel pieno della migrazione da Hopper a Blackwell. Le tariffe per la capacità B200, dove sono disponibili, vanno da 3,50 a 27,04 dollari/ora; le allocazioni di NVIDIA sono già impegnate anche per il 2027 e la capacità di packaging CoWoS è esaurita, anche se Lambda offre istanze B200 attivabili direttamente dagli utenti. Hopper resta ampiamente disponibile. Il parco di H100 su cui si basano i costi odierni dell’FP8 non è quello su cui si baseranno i costi futuri dell’FP4: per la maggior parte dei team, l’FP4 è ancora un progetto, non un prezzo.