Orizzonti futuri
La guerra dei modelli del mondo: perché la prossima battaglia tra architetture riguarda l’ancoraggio dell’IA alla realtà fisica
Tre scommesse su come ancorare l’IA al mondo fisico — generare video, prevedere rappresentazioni vettoriali o costruire ambienti 3D persistenti — e perché Cosmos 3 di NVIDIA, che ora produce anche azioni per i robot, ha cambiato i termini d
AI.info Team ·
La battaglia sbagliata si prende tutta l’attenzione
Da tre anni, il dibattito più acceso sull’IA riguarda la scala: quanti parametri, quanti token, quante GPU. Quel dibattito si sta esaurendo, non perché qualcuno l’abbia vinto, ma perché ha smesso di essere la questione interessante. I laboratori di frontiera che sviluppano sistemi per la robotica, la guida autonoma e la simulazione fisica non competono più sulla grandezza dei loro modelli linguistici. Competono su una domanda molto più circoscritta e decisiva: quando una macchina deve prevedere che cosa accadrà nel mondo fisico, deve prevedere i pixel o qualcosa di completamente diverso?
È questa la vera battaglia tra architetture del 2026, combattuta sotto la bandiera dei «modelli del mondo». Google DeepMind ha Genie 3. NVIDIA ha Cosmos. Wayve ha GAIA-3. OpenAI ha Sora, che voglia o no questa etichetta. World Labs di Fei-Fei Li ha Marble. E Yann LeCun, dopo aver lasciato Meta, dove per dodici anni è stato responsabile scientifico per l’IA, ha preso la sua Joint Embedding Predictive Architecture (JEPA) e fondato AMI Labs per costruire modelli del mondo a modo suo.
Tutte queste iniziative rivendicano lo stesso obiettivo — ancorare l’IA alla realtà fisica — e quasi nessuna concorda su che cosa richieda questo «ancoraggio». Sarà questo disaccordo, non i punteggi nei benchmark, a determinare quali aziende finiranno per controllare l’infrastruttura su cui funzionerà l’IA incarnata.
Persino i laboratori che traggono ancora i maggiori profitti dai modelli linguistici ora dicono apertamente ciò che prima lasciavano intendere. Demis Hassabis di Google DeepMind ha sostenuto che, per arrivare all’AGI, servono due cose oltre a rendere più grandi gli assistenti conversazionali: un vero modello del mondo che comprenda la fisica e lo spazio, e una sperimentazione automatizzata che permetta a un sistema di mettere alla prova la propria comprensione confrontandola con la realtà anziché con altro testo. È un’ammissione notevole da parte di un laboratorio che possiede anche Gemini: riconoscere che prevedere il token successivo, per quanto bene lo si faccia, non equivale a prevedere lo stato successivo di una stanza.
Tre schieramenti, un problema irrisolto
Al di là dei marchi, le scommesse su come costruire un modello del mondo sono in realtà tre, ben distinte.
L’approccio generativo: prevedere il video
Cosmos di NVIDIA, lanciato al CES 2025 come piattaforma di «modelli fondazionali del mondo», generava video basati sulla fisica a partire da testo, immagini o dati dei sensori di un robot. Da allora ha smesso di essere soltanto un modello video. Il 31 maggio 2026, al GTC Taipei, NVIDIA ha presentato Cosmos 3, che definisce il primo omnimodello completamente aperto: un unico modello mixture-of-transformers capace nativamente di ragionamento visivo e generazione su testo, immagini, video, suoni ambientali e traiettorie d’azione. È stato pubblicato con la licenza OpenMDW 1.1 della Linux Foundation nelle varianti Super e Nano; una variante Edge per l’inferenza in tempo reale era ancora in arrivo al momento del lancio e, a ottobre 2026, figurava nella documentazione di riferimento dei modelli NVIDIA. Le traiettorie d’azione sono la parte che conta qui. Il modello è pensato per fare da base a modelli di azione del mondo che producano indicazioni su ciò che un robot deve fare, non riprese di un robot mentre lo fa.
GAIA-3 di Wayve, un modello da 15 miliardi di parametri lanciato nel dicembre 2025, fa qualcosa di simile per la guida: prende riprese reali di guida e le ricrea introducendo variazioni controllate — cambiando la traiettoria del veicolo autonomo e mantenendo fisicamente coerente tutto il resto della scena — con lo scopo dichiarato di convalidare il software di guida autonoma, non soltanto di generare clip per l’addestramento.
Genie 3 di DeepMind, presentato nell’agosto 2025, genera a partire da un prompt testuale mondi 3D completamente interattivi ed esplorabili a 24 fotogrammi al secondo, mantenendo la coerenza fisica benché DeepMind affermi di non aver mai programmato esplicitamente tale persistenza. Non è più una demo: il 29 gennaio 2026 Google ha reso disponibile Project Genie, un prototipo sperimentale basato su Genie 3, agli abbonati a Google AI Ultra negli Stati Uniti, con generazioni limitate a 60 secondi e l’avvertenza che i mondi potrebbero non rispettare le leggi fisiche del mondo reale. E Sora di OpenAI, pur essendo commercializzato come generatore di video, è stato presentato dalla stessa OpenAI come un «simulatore del mondo»: la tesi implicita è che, addestrando un modello abbastanza grande a prevedere video, la comprensione della fisica emerga come effetto collaterale.
L’approccio predittivo: saltare i pixel
Yann LeCun sostiene da anni che l’intero schieramento generativo stia cercando di risolvere il problema sbagliato. La sua posizione, esposta nel suo articolo del 2022 «A Path Towards Autonomous Machine Intelligence» e messa in pratica con I-JEPA e V-JEPA, è che prevedere i pixel grezzi costringe un modello a sprecare capacità su dettagli irrilevanti e imprevedibili — la trama esatta delle foglie che frusciano, la distribuzione del rumore in un fotogramma video — quando ciò che conta davvero per la pianificazione e il controllo è la struttura sottostante.
JEPA prevede invece in uno spazio di rappresentazione astratto: il modello impara a prevedere la rappresentazione vettoriale di una porzione mascherata o futura di un video, non i suoi pixel. V-JEPA 2 di Meta, pubblicato nel giugno 2025, è stato addestrato in questo modo su video; la sua versione condizionata dalle azioni, V-JEPA 2-AC, è stata poi sottoposta a fine-tuning su meno di 62 ore di dati relativi a bracci robotici provenienti dal dataset Droid, sufficienti per pianificare operazioni di presa e posizionamento zero-shot con robot in ambienti mai visti prima. Il lavoro è proseguito dopo l’uscita di LeCun: il 16 marzo 2026 Meta ha pubblicato V-JEPA 2.1, una famiglia di modelli addestrati con una nuova procedura per ottenere rappresentazioni dense temporalmente coerenti. Si tratta di un rilascio di ricerca incrementale, non di un prodotto.
LeCun ha poi portato questa scommessa del tutto fuori da Meta: nel novembre 2025 ha annunciato che avrebbe lasciato l’azienda alla fine dell’anno, in un contesto di attriti segnalati dalla stampa per il cambio di rotta di Meta verso lo sviluppo commerciale di LLM sotto la nuova divisione Superintelligence Labs, e ha cofondato AMI Labs con Alexandre LeBrun per dedicarsi a tempo pieno ai modelli del mondo basati su JEPA.
La scuola spaziale: prevedere una struttura persistente
World Labs di Fei-Fei Li occupa una terza posizione. Anziché prevedere il fotogramma successivo di un video o la successiva rappresentazione astratta, il suo prodotto Marble genera ambienti 3D persistenti e modificabili a partire da testo, immagini, video o schemi approssimativi: scene spaziali esplicite che si possono esplorare, modificare e riutilizzare, pensate espressamente per la robotica, i videogiochi e la simulazione. World Labs li chiama «grandi modelli del mondo», e questa definizione conta: la scommessa è che l’ancoraggio alla realtà sia fondamentalmente un problema di geometria prima ancora che di previsione.
Un robot o un sistema autonomo ha bisogno di un modello persistente della stanza in cui si trova, i cui elementi siano identificabili e richiamabili, non soltanto di un’allucinazione dall’aspetto plausibile dei pochi secondi successivi.
Perché la scommessa sui pixel è più fragile di quanto sembri
Le demo della scuola generativa sono, senza eccezioni, la cosa visivamente più impressionante che accada oggi nel campo dell’IA. Ed è anche questo il problema. Un modello che produce un video convincente di una stanza non è la stessa cosa di un modello che ne ha appreso le leggi fisiche, e i suoi limiti continuano a emergere proprio nel modo previsto da LeCun.
Nei video di Sora sono comparse sedie dal nulla, fiamme di candele che non tremolano e animali con un numero sbagliato di arti: i critici hanno segnalato violazioni della permanenza degli oggetti e della continuità spaziotemporale che nessun grado di fedeltà visiva può mascherare. OpenAI stessa ha riconosciuto che Sora può non riuscire a simulare la fisica di scene complesse o a rappresentare correttamente specifici rapporti di causa ed effetto.
Project Genie limita a 60 secondi la durata di un mondo generato: un limite accettabile per un prototipo destinato ai consumatori, ma un vincolo concreto per qualsiasi applicazione che debba eseguire una strategia di controllo robotico più a lungo. La verità scomoda per la scuola generativa è che il fotorealismo e la correttezza fisica sono correlati solo debolmente, e le metriche usate per promuovere questi sistemi — qualità dei fotogrammi, coerenza temporale, risoluzione — misurano perlopiù il primo.
Colmare questo divario è precisamente lo scopo della previsione in stile JEPA: rinunciando del tutto a ricostruire i pixel, costringe il modello a rappresentare soltanto le parti di una scena che sono effettivamente prevedibili e quindi davvero utili alla pianificazione. Resta da verificare empiricamente se questo vantaggio teorico si traduca, su larga scala, in prestazioni migliori dei robot nel mondo reale: i risultati di V-JEPA 2 con i robot sono promettenti, ma provengono da compiti di manipolazione strettamente delimitati, non dall’impiego di sistemi robotici in situazioni aperte. La scommessa di LeCun è più lineare sul piano architetturale. Non è ancora comprovata sul piano commerciale.
Il mercato non aspetta che la teoria trovi una risposta
È proprio su questa distinzione — tra un’architettura più lineare e una validità commerciale comprovata — che si stanno orientando oggi gli investimenti, e non in modo uniforme. NVIDIA ha già integrato Cosmos in un ecosistema operativo di partner nella robotica e nell’automotive, tra cui 1X, Figure AI, Agility, Agile Robots, Foretellix, Galbot, NEURA Robotics, XPENG e Uber. Questo fa di Cosmos meno una scommessa sulla ricerca e più un livello infrastrutturale destinato a essere adottato indipendentemente da quale architettura a valle finirà per prevalere. Secondo l’azienda, Wayve usa già oggi GAIA-3 per ridurre di circa cinque volte il tasso di scarto dei test sintetici nella propria procedura di validazione della guida autonoma: un vantaggio operativo concreto, non una promessa.
World Labs e AMI Labs, per contro, sono scommesse sull’architettura, e gli investitori le valutano di conseguenza, con aggressività. World Labs ha chiuso un round da 1 miliardo di dollari nel febbraio 2026, comprendente un investimento di 200 milioni di dollari da parte di Autodesk insieme ad AMD, Nvidia, Fidelity ed Emerson Collective, dopo aver raccolto 230 milioni di dollari all’uscita dalla fase stealth nel 2024, con una valutazione di circa 1 miliardo di dollari. In precedenza nello stesso anno era stato riferito di trattative su una valutazione di 5 miliardi di dollari, e l’azienda si è rifiutata di confermare se il round concluso avesse aumentato la sua valutazione: il dato certo, quindi, è la somma effettivamente raccolta, non la cifra riportata.
AMI Labs si è mossa ancora più in fretta: fondata alla fine del 2025, entro marzo 2026 aveva raccolto più di 1,03 miliardi di dollari in un round seed a una valutazione pre-money di 3,5 miliardi di dollari. Secondo quanto riportato, si tratta del più grande round seed mai raccolto da un’azienda europea. A guidarlo congiuntamente sono state Cathay Innovation, Greycroft, Hiro Capital, HV Capital e Bezos Expeditions, con Nvidia e Temasek tra gli investitori: cifre confermate in modo indipendente da TechCrunch e Sifted. Sia AMI sia World Labs sono, va notato, scommesse sulla ricerca che non generano ancora ricavi. NVIDIA vende infrastrutture ad aziende che stanno già immettendo robot sul mercato.
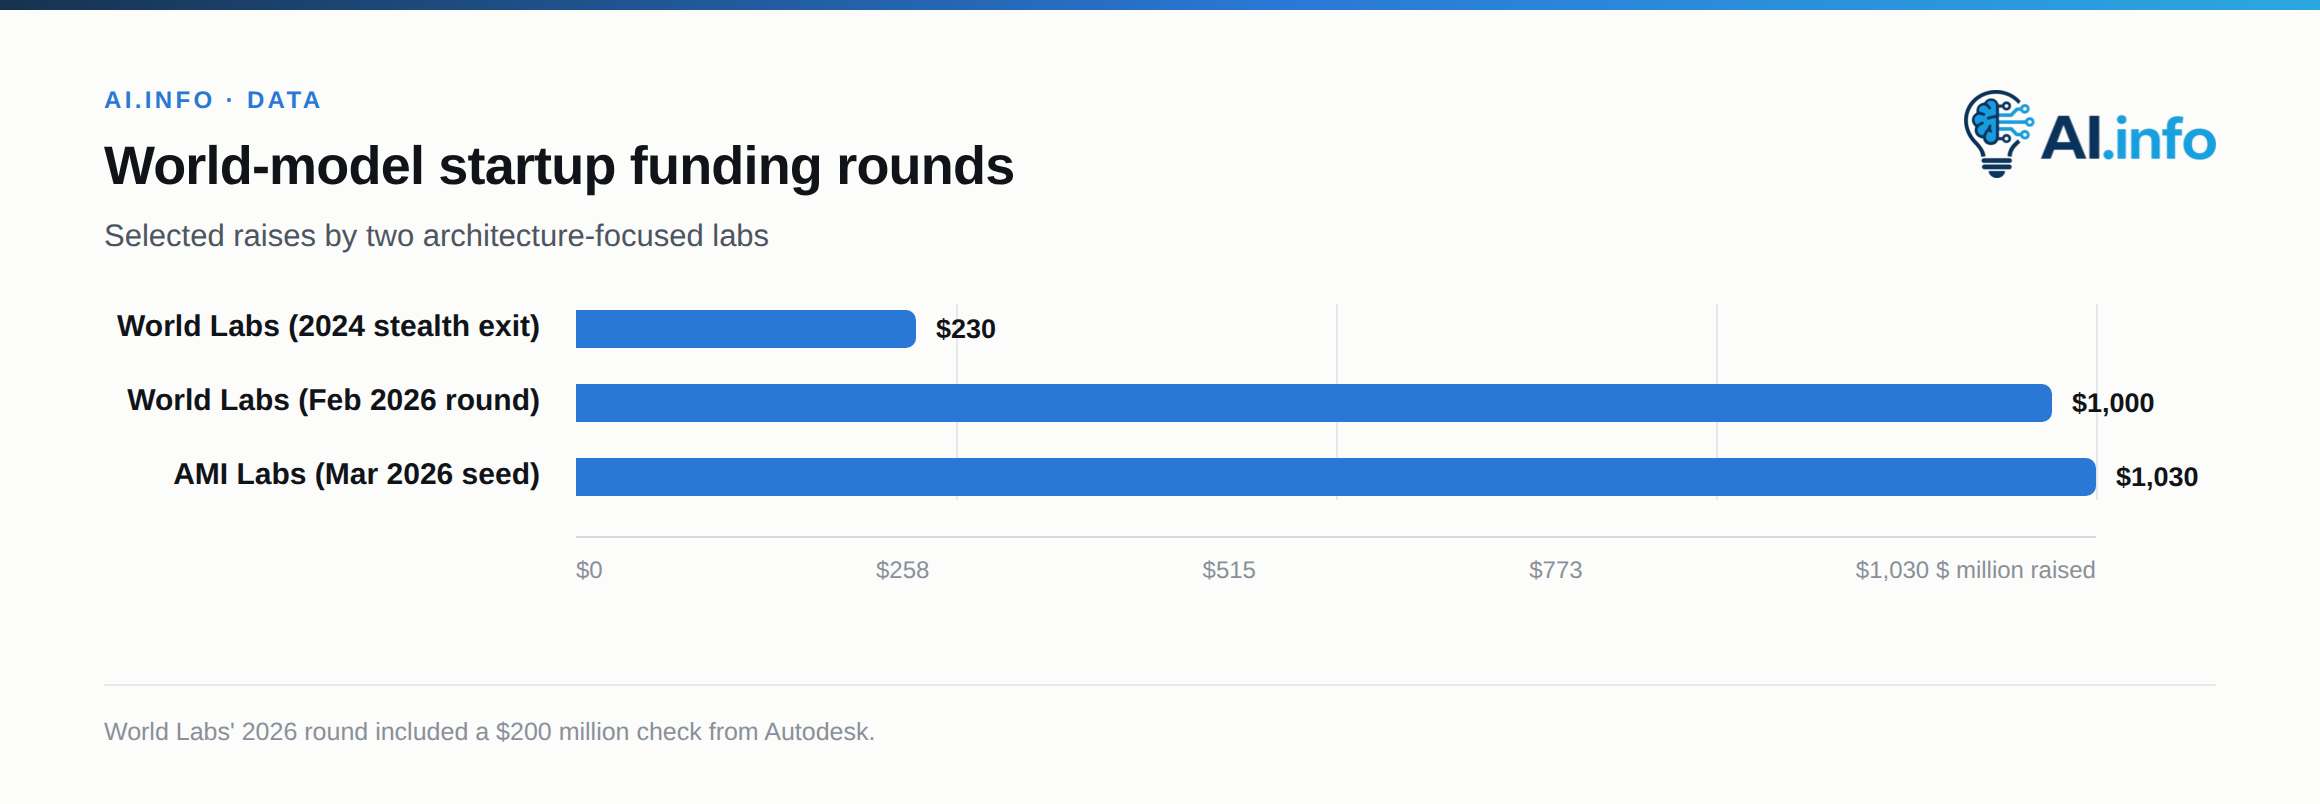
| Azienda | Evento | Somma / valutazione |
|---|---|---|
| World Labs | Uscita dalla fase stealth (2024) | 230 milioni di dollari raccolti, valutazione di circa 1 miliardo di dollari |
| World Labs | Trattative sulla valutazione (inizio 2026) | Valutazione di circa 5 miliardi di dollari (secondo quanto riportato) |
| World Labs | Round di finanziamento (febbraio 2026) | 1 miliardo di dollari raccolto (compresi 200 milioni di dollari da Autodesk) |
| AMI Labs | Round seed (marzo 2026) | 1,03 miliardi di dollari raccolti a una valutazione pre-money di 3,5 miliardi di dollari |
Questa asimmetria è il segnale rivelatore. Le scuole generativa e spaziale-generativa hanno trovato clienti paganti perché i loro risultati sono immediatamente utilizzabili come simulatori, generatori di dati sintetici e strumenti di validazione: per vendere a un’azienda uno strumento che riduce di cinque volte i costi dei test non serve risolvere la questione filosofica della «vera comprensione». La scuola predittiva vende una promessa di efficienza nell’uso dei dati di addestramento e di generalizzazione più facile da sostenere alla lavagna che in un term sheet. È proprio per questo che LeCun ha avuto bisogno di oltre 1 miliardo di dollari di capitale paziente, raccolto al di fuori del bilancio di una Big Tech, anche solo per tentare di realizzarla su larga scala.
Di cosa hanno davvero bisogno i robot, e chi ci è più vicino
L’indicazione più chiara di cosa debba significare, in pratica, «ancoraggio al mondo reale» viene dall’impiego a cui questi sistemi sono destinati: non generare video impressionanti, ma chiudere il ciclo tra previsione e azione usando il minor numero possibile di dati raccolti nel mondo reale. Il risultato di pianificazione zero-shot di V-JEPA 2-AC — meno di 62 ore di dati raccolti dai robot per ottenere comportamenti utilizzabili di prelievo e posizionamento di oggetti in ambienti nuovi — è una prova più solida dell’efficienza nell’uso dei dati di qualsiasi risultato pubblicato dai sostenitori degli approcci generativi. È questa, infatti, la vera strozzatura della robotica: raccogliere dati sulle interazioni dei robot nel mondo reale è lento e costoso, ed espandere la raccolta senza cautela è pericoloso.
Cosmos e GAIA-3 affrontano un’altra strozzatura, altrettanto reale: generano scenari sintetici a costi abbastanza bassi da consentire di sottoporre una policy di guida o di manipolazione a test rigorosi su casi limite che una flotta reale incontrerebbe di rado. Nessuna delle due strozzature è inventata. Ma non sono la stessa strozzatura e, fino al 2026, nessun singolo sistema le aveva affrontate entrambe.
Cosmos 3 è il primo tentativo credibile di farlo. Riunire la generazione e la produzione di azioni in un unico modello open source riduce la distanza tra il simulatore e la policy che dovrebbe addestrare: è la convergenza che, come indicato in precedenza in questo saggio, andava tenuta d’occhio. Ciò che non offre è la persistenza: un modello onnicomprensivo che produce una traiettoria continua a non conservare, tra un episodio e l’altro, una mappa della stanza a cui si possa accedere direttamente. È ciò che costruisce World Labs e ciò di cui un robot impegnato in un turno di lavoro ha effettivamente bisogno.
La convergenza di cui nessuno tiene ancora conto
Descrivere tutto questo come una guerra con un unico vincitore è probabilmente sbagliato, e vale la pena dirlo chiaramente: i laboratori che la vedono così sono i più esposti. Un robot che opera in un ambiente non strutturato ha bisogno di un modello spaziale persistente della stanza in cui si trova (la scommessa di World Labs), di una rappresentazione predittiva efficiente di come lo stato di quella stanza cambierà in seguito alle sue azioni (la scommessa di LeCun) e di una gamma abbastanza ampia di scenari sintetici per essere messo alla prova in situazioni che non ha ancora affrontato (la scommessa di NVIDIA e Wayve).
Il limite di 60 secondi di Project Genie e i problemi di Sora con la permanenza degli oggetti indicano entrambi la stessa lacuna: nessuno dei sistemi puramente generativi mantiene ancora uno stato del mondo persistente e accessibile direttamente, come quello su cui si fondano fin dall’inizio gli approcci spaziali e predittivi. Per contro, nessuno ha mostrato un sistema basato su JEPA capace di raggiungere la ricchezza visiva o la flessibilità generativa di Genie 3 o Cosmos. Al momento, queste architetture risolvono problemi vicini ma non identici, chiamandoli la stessa battaglia.
Ora non bisogna guardare quale demo somigli di più a un videogioco, ma se qualcuno aggiungerà il terzo elemento mancante. Cosmos 3 riunisce in un unico modello la generazione condizionata dalle azioni e una copertura di scenari sintetici a basso costo. Lo stato 3D persistente resta altrove, e il ciclo si chiuderà solo quando tutti e tre gli elementi funzioneranno insieme, in tempo reale, con una flotta che li corregga.
È un problema di integrazione tanto quanto di ricerca, e l’integrazione favorisce chi dispone già sia dell’infrastruttura di calcolo sia dei dati sulle interazioni raccolti su scala di una flotta necessari per chiudere il ciclo. Per ora, questo profilo sembra corrispondere più a NVIDIA e Wayve che ai puristi delle architetture, pur ben finanziati. AMI Labs e World Labs si sono assicurati il tempo necessario per dimostrare che le loro scommesse architetturali sono giuste. Non si sono ancora assicurati, però, prove su scala di una flotta di robot che dimostrino che avere ragione basti.