Orizzonti futuri
Perché i robot non possono imparare come hanno fatto i chatbot: il collo di bottiglia dei dati per l’IA incarnata
L’entusiasmo per i robot umanoidi nasconde il vero limite: per i robot non esiste un corpus su scala internet che associ i dati alle azioni. Simulazione, teleoperazione in realtà virtuale e video in prima persona sono le tre soluzioni del 2
AI.info Team ·
Perché i robot non sono ancora più intelligenti? L’entusiasmo per gli umanoidi si scontra con il muro dei dati
Nel 2026 i robot umanoidi dominano i palchi delle presentazioni. Le macchine di terza generazione di Figure smistano componenti in uno stabilimento di assemblaggio BMW a Spartanburg, 1X ha esaurito in cinque giorni le prenotazioni per un anno di capacità produttiva di Neo, Tesla ha smantellato a Fremont la linea su cui costruiva la Model S per produrvi invece Optimus, e i finanziamenti di venture capital continuano ad arrivare a ritmi che due anni fa sarebbero sembrati assurdi. Se si chiede a un ingegnere di queste aziende perché un robot continui a maneggiare maldestramente un calice di vino o a lasciar cadere un tovagliolo di stoffa, la risposta raramente riguarda chip o attuatori. Il problema sono i dati.
I grandi modelli linguistici hanno imparato a scrivere, ragionare e programmare assimilando un corpus di testi raccolto nell’arco di tre decenni di internet aperto: blog, libri, forum, repository di codice. Per i robot non esiste un corpus equivalente. Ken Goldberg, ricercatore di robotica alla UC Berkeley, ha espresso il divario senza mezzi termini: a un essere umano servirebbero circa 100.000 anni per leggere i testi usati per addestrare i grandi modelli linguistici di oggi.
«Non abbiamo neanche lontanamente una quantità simile di dati per addestrare i robot, e 100.000 anni corrispondono soltanto alla quantità di testi di cui disponiamo per addestrare i modelli linguistici», ha detto. Nessuno sa esattamente quanti dati sulle interazioni fisiche servano a un robot capace di svolgere compiti generali, ma ogni stima attendibile indica una quantità molto superiore a quella raccolta finora.
I 100.000 anni di divario nei dati per addestrare l’IA incarnata
I testi possono crescere di scala perché copiarli e trasmetterli non costa quasi nulla. Un post scritto una sola volta viene letto da milioni di persone. Con i dati dei robot non funziona così. Ogni dimostrazione richiede un robot fisico, un ambiente fisico e, in quasi tutti i sistemi attualmente in uso, un essere umano che guidi direttamente il braccio oppure lo sorvegli abbastanza da vicino da poter intervenire. La seconda osservazione di Goldberg, ancora più amara, spiega direttamente il limite: «Ogni otto ore di lavoro producono soltanto altre otto ore di dati».
Un modello come GPT non è stato addestrato facendo scrivere una persona per otto ore: ha attinto a un corpus costruito da miliardi di persone nell’arco di decenni. Un braccio robotico teleoperato produce esempi di addestramento esattamente alla velocità con cui un essere umano riesce a muoverlo.
In un rapporto dell’aprile 2026, Bessemer Venture Partners ha quantificato questa scarsità: i dati sulla manipolazione robotica raccolti nel mondo ammontano complessivamente a circa 300.000 ore, contro circa un miliardo di ore di video disponibili su internet per il preaddestramento di modelli linguistici e video. Open X-Embodiment, il dataset più usato che comprende robot di forme diverse, realizzato con i dati di 21 istituzioni tra cui Google DeepMind, contiene poco più di un milione di traiettorie reali di robot appartenenti a 22 piattaforme: una risorsa importante per la ricerca, ma trascurabile rispetto al corpus con cui è stato addestrato un grande modello linguistico.
DROID, un progetto accademico che coinvolge più laboratori di 13 istituzioni in tre continenti, ha aggiunto circa 76.000 traiettorie e circa 350 ore di interazione teleoperata in 564 scene e 86 compiti. Dati utili, diversificati, eppure ancora esigui rispetto a quelli a disposizione dell’IA basata sui testi.
| Dataset | Traiettorie | Ambito |
|---|---|---|
| Open X-Embodiment | Oltre 1 milione | 22 piattaforme, 21 istituzioni |
| DROID | ~76.000 | 13 istituzioni, 564 scene, 86 compiti |
| NVIDIA GR00T-Mimic (sintetico) | 780.000 | Generate in 11 ore a partire da dimostrazioni reali |
| Fonte dei dati | Dimensioni |
|---|---|
| Testi usati per addestrare gli attuali grandi modelli linguistici (stima di Goldberg) | ~100.000 anni di lettura per un essere umano |
| Dati sulla manipolazione robotica raccolti nel mondo (Bessemer, 2026) | ~300.000 ore |
| Video disponibili su internet per il preaddestramento | ~1 miliardo di ore |
Modelli del mondo per i robot: la simulazione diventa la prima soluzione
La prima risposta adottata nella pratica è smettere di raccogliere dati esclusivamente nel mondo reale e generare esperienze sintetiche da cui un robot possa imparare prima ancora di entrare in contatto con l’hardware. La piattaforma Isaac GR00T di NVIDIA abbina un modello di base visione-linguaggio-azione, GR00T N1, a una pipeline di dati sintetici chiamata GR00T-Mimic, che a partire da un numero ridotto di dimostrazioni umane registrate produce dataset simulati molto più ampi.
NVIDIA ha dichiarato di aver generato 780.000 traiettorie sintetiche, l’equivalente di circa 6.500 ore di dimostrazioni umane, o nove mesi di registrazione continua, in appena 11 ore di calcolo. L’addestramento dei modelli fondamentali del mondo Cosmos dell’azienda ha richiesto una risorsa di altro tipo: circa 10.000 GPU H100 in funzione per circa tre mesi.
NVIDIA non è la sola a puntare su modelli del mondo addestrati sui video anziché su una fisica programmata a mano. Genie 3 e Dreamer 4 di Google DeepMind generano ambienti interattivi in cui una policy può esercitarsi prima dell’impiego, e Wayve, specializzata nella guida autonoma, ha applicato la stessa idea al proprio settore con un modello da 8,4 miliardi di parametri chiamato GAIA-2. Anche mettere a disposizione un modello del mondo all’avanguardia è costoso: il funzionamento di Genie 3 di Google è stato stimato a circa 100 dollari per ogni ora di ambiente generato. Questo contribuisce a spiegare perché i finanziamenti destinati a questo approccio siano cresciuti così rapidamente.
I finanziamenti sono affluiti sulla scommessa che i modelli del mondo consentano di superare il limite dei dati. AMI Labs, la nuova impresa di Yann LeCun, ha raccolto 1,03 miliardi di dollari in finanziamenti seed nel marzo 2026, con una valutazione pre-money di 3,5 miliardi di dollari, con l’obiettivo dichiarato di costruire modelli del mondo anziché un altro grande modello linguistico.
World Labs di Fei-Fei Li ha chiuso un round da 1 miliardo di dollari il 18 febbraio 2026, portando i finanziamenti complessivi a circa 1,23 miliardi di dollari. Con il sostegno di Autodesk, AMD, NVIDIA, Fidelity e Sea, l’azienda punta a costruire modelli di intelligenza spaziale nell’ambito della linea di prodotti Marble. Bessemer ha citato la stima di Mahesh Krishnamurthi, cofondatore di Vayu Robotics, secondo cui circa 6 miliardi di dollari sono affluiti a sei o sette aziende che sviluppano modelli del mondo nel solo primo trimestre del 2026. Separatamente, ha previsto che nei due anni successivi i costi complessivi dei dati per la robotica nell’intero settore supereranno i 3 miliardi di dollari.
Teleoperazione in VR e corsa alla raccolta di dati sulla destrezza
La simulazione gestisce abbastanza bene la locomozione — camminare, mantenere l’equilibrio, riprendersi dopo un inciampo — perché i motori fisici modellano con precisione la dinamica dei corpi rigidi. È molto meno affidabile nella manipolazione fine, perciò le aziende continuano ad affidarsi a persone che pilotano direttamente i robot, sempre più spesso con visori VR di consumo anziché con attrezzature industriali. I visori Apple Vision Pro e Meta Quest 3 sono ormai presenti nei sistemi di teleoperazione perché tracciano senza configurazioni aggiuntive il movimento delle mani su sei gradi di libertà, anche se ogni sistema ha comunque bisogno di un livello di adattamento che associ le 27 articolazioni di una mano umana a una pinza o a una mano robotica dotata di destrezza con 12-16 gradi di libertà.
Il gruppo di ricerca di Apple ha sviluppato ARMADA, un sistema che, attraverso Vision Pro, sovrappone un robot virtuale al mondo reale: una persona può così mostrare un compito a mani nude e produrre comunque dati compatibili con i limiti di un robot fisico. È importante perché elimina del tutto la necessità di possedere un robot.
Accanto ai visori restano molto diffuse attrezzature più vecchie ed economiche: ALOHA 2, un sistema bimanuale di bracci in configurazione leader-follower che costa circa 15.000-20.000 dollari da costruire, produce tra 10 e 30 episodi dimostrativi utilizzabili per ogni ora di lavoro umano; UMI, un dispositivo di acquisizione montato al polso, permette di raccogliere dati anche in normali cucine e officine, senza che sia presente alcun robot.
Figure AI ha aperto un Helix Lab dedicato per utilizzare su larga scala la propria infrastruttura di VR e teleoperazione a supporto di Helix, il suo modello visione-linguaggio-azione. I suoi annunci di lavoro parlano ora di «creatori di dati per Helix» e «piloti di robot umanoidi» che indossano dispositivi di teleoperazione per guidare i robot nello svolgimento dei compiti e caricare i risultati. Ciò che questa infrastruttura alimenta si trova ora in fabbrica: Helix 02, il modello di Figure che trasforma i pixel in azioni, guida i robot Figure 03 arrivati il 30 giugno 2026 nel capannone 52 dello stabilimento BMW di Spartanburg per disporre parti non smistate nei carrelli di consegna. È un lavoro più difficile del caricamento di lamiere svolto lì dal suo predecessore per oltre 30.000 X3 nel 2025.
1X ha portato ai consumatori la versione più diretta di questa scommessa. A chi acquista Neo, il suo robot domestico — 20.000 dollari per la consegna prioritaria nel 2026, oppure 499 dollari al mese per una consegna successiva — viene detto fin dall’inizio che operatori umani vedranno l’interno delle loro case mentre pilotano il robot. Il 30 aprile 2026, 1X ha aperto a Hayward, in California, una fabbrica con una capacità di 10.000 unità l’anno per produrli.
Il fondatore Bernt Børnich ha spiegato esplicitamente il motivo: «Se non abbiamo i vostri dati, non possiamo migliorare il prodotto». Nel 2025 Tesla ha preso la direzione opposta, abbandonando le tute per la cattura del movimento e le attrezzature di teleoperazione a favore di lavoratori che indossano sistemi di telecamere montati su caschi e zaini per registrare attività ordinarie, come piegare una camicia. La modifica è stata introdotta proprio per raccogliere dati più rapidamente dopo che Ashok Elluswamy ha assunto la guida del programma Optimus al posto di Milan Kovac.
Preaddestramento su video egocentrici: apprendere dai movimenti delle mani umane
La terza soluzione rinuncia del tutto ai robot e alle attrezzature di teleoperazione, e attinge ai video di persone che vivono semplicemente la propria vita. Il dataset Ego4D di Meta, realizzato con 13 università partner, contiene quasi 3.700 ore di video in prima persona girati da 931 persone munite di telecamera in 74 località di nove paesi: riprese di attività come cucinare, riparare oggetti, fare giardinaggio e altre forme di manipolazione quotidiana, senza alcun robot coinvolto.
Il progetto EgoScale di NVIDIA, pubblicato nel febbraio 2026 con collaboratori della UC Berkeley e della University of Maryland, ha preaddestrato una policy visione-linguaggio-azione su 20.854 ore di video egocentrici di persone riprese con guanti che ne tracciavano i movimenti: oltre 20 volte la quantità di dati usata nei precedenti tentativi di preaddestramento su video di esseri umani.
Lo studio ha individuato una chiara legge di scala log-lineare tra il volume dei dati di preaddestramento e le prestazioni successive dei robot: un primo indizio del fatto che le policy robotiche migliorino in modo prevedibile all’aumentare dei dati, come accade per i modelli linguistici. La policy risultante ha superato del 54% un modello di riferimento non preaddestrato su una mano robotica dotata di destrezza con 22 gradi di libertà.
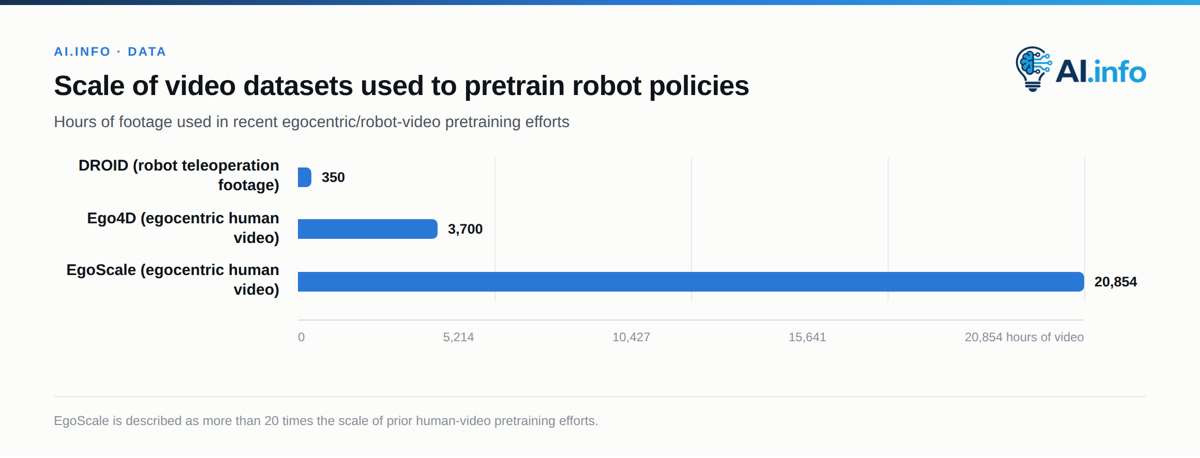
Il modello del mondo V-JEPA 2 di Meta ha seguito un approccio affine ma distinto: preaddestramento su circa un milione di ore di video generici tratti da internet per acquisire un’intuizione della realtà fisica, seguito da fine-tuning su meno di 62 ore di filmati specifici di robot provenienti da DROID. Il sistema risultante, V-JEPA 2-AC, è stato impiegato zero-shot su bracci robotici Franka in due laboratori distinti nei quali non aveva mai operato prima. Ha ottenuto un tasso di successo tra il 65 e l’80% nei compiti di presa e posizionamento immaginando, prima di agire, le conseguenze per circa 16 secondi, senza aver prima raccolto neppure un fotogramma di dati in nessuno dei due laboratori.
Il divario sim-to-real: perché gli oggetti riflettenti e trasparenti continuano a mettere in crisi le policy
Nessuna di queste tre soluzioni ha colmato il divario visivo tra simulazione e realtà, che i ricercatori indicano sempre più spesso come una delle cause principali del fallimento delle policy di manipolazione quando un robot esce dal laboratorio. La randomizzazione del dominio — variare texture, illuminazione e proprietà degli oggetti all’interno di un simulatore durante l’addestramento — resta la misura più usata, ma non riesce a coprire in modo affidabile le superfici riflettenti e trasparenti: una ciotola in acciaio inossidabile, un bicchiere, un contenitore di plastica per alimenti.
I motori di rendering progettati per privilegiare la velocità rispetto all’accuratezza fisica spesso non eseguono il ray tracing. Non possono quindi riprodurre il modo in cui la luce si riflette su un piano di lavoro a specchio o si rifrange attraversando l’acqua, e una policy addestrata su quella rappresentazione imperfetta impara a riconoscere indizi visivi che nella stanza reale non esistono.
I benchmark accademici sul sim-to-real hanno misurato cali dal 24 al 30% nei tassi di successo delle operazioni di manipolazione quando una policy addestrata esclusivamente in simulazione incontra telecamere e illuminazione reali. I ricercatori che sviluppano pipeline di rendering basate sulla fisica hanno inoltre riscontrato che materiali riprodotti accuratamente e un’illuminazione plausibile sono necessari, non facoltativi, per colmare quel divario. La fisica dei corpi deformabili aggrava il problema: la dinamica dei tessuti, la deformazione delle spugne e l’attrito dei cassetti non sono ancora modellati con sufficiente fedeltà perché una policy di presa addestrata in simulazione si trasferisca in modo affidabile alla realtà.
Il momento GPT-2.5: che cosa compra davvero l’ondata di finanziamenti del 2026
Nell’aprile 2026, Bessemer Venture Partners ha definito la fase raggiunta dal settore «il momento GPT-2.5 della robotica»: le capacità sono reali e avanzano rapidamente, e le leggi di scala iniziano a emergere in studi come EgoScale, ma resta ampia la distanza tra una dimostrazione in laboratorio e la soglia del 99,9% di affidabilità sul campo. Physical Intelligence ha rilasciato quattro policy generaliste in diciotto mesi, a dimostrazione del punto: π0 ha piegato il bucato e sparecchiato i tavoli dopo essere stata addestrata su 68 compiti distribuiti su sette piattaforme robotiche; π0.7, rilasciata il 16 aprile 2026, riporta il trasferimento zero-shot tra robot con caratteristiche fisiche diverse — un robot che piega il bucato senza che gli sia mai stato mostrato come svolgere quel compito — e il funzionamento di una macchina per espresso.
I calcoli della stessa Bessemer mostrano perché quella soglia conta: una policy che riesce nel 95% dei casi in ciascuna fase di un compito composto da dieci fasi porta a termine l’intero compito solo nel 60% circa dei casi, un tasso di fallimento che nessun magazzino o stabilimento può permettersi.
Nessuna delle tre soluzioni attuali sostituisce completamente il corpus delle dimensioni di internet che ha reso possibili i chatbot. Combinarle è ormai la strategia dichiarata di ogni laboratorio importante: simulazione per la locomozione e la scala, teleoperazione per i dati sulla destrezza che solo gli esseri umani possono generare in modo affidabile e video in prima persona per le ampie conoscenze pregresse sul mondo fisico che nessuna delle altre due fonti fornisce a basso costo.
La quarta speranza è che le flotte di robot impiegati sul campo diventino motori di produzione di dati che nessun rilascio di dataset potrebbe eguagliare. L’esperienza di Tesla nel corso dell’anno mostra quanto lentamente ciò avvenga. Durante la presentazione dei risultati del 28 gennaio 2026, Musk ha detto che le diverse centinaia di unità Optimus presenti nelle fabbriche Tesla erano lì principalmente per apprendere e raccogliere dati, più che per svolgere lavoro produttivo: motori di produzione di dati in senso letterale, e per il momento nient’altro. Ad agosto 2026 Tesla non aveva ancora mostrato pubblicamente Optimus Gen 3, quando ha comunicato agli investitori che il progetto era stato finalizzato e che le vendite commerciali avrebbero potuto iniziare «già» nella seconda metà del 2027. Musk è stato diretto.
«No, la produzione di Optimus sarà estremamente lenta all’inizio, perché tutto è nuovo. Non è come costruire un’auto.» — Elon Musk, amministratore delegato, Tesla
XPeng ha avviato una linea automatizzata per robot umanoidi a Guangzhou nel settembre 2026 e punta alla produzione su larga scala entro fine anno: sarebbe la prima flotta abbastanza numerosa da mettere alla prova la teoria dei motori di produzione di dati. Finché una di queste linee non raggiungerà la produzione su larga scala, il corpus continuerà a essere costruito un’ora di lavoro di un braccio robotico alla volta, proprio come lo aveva descritto Goldberg.