Orizzonti futuri
Il futuro degli agenti di IA: quando il software può agire, non solo rispondere
Gli agenti sono software che agisce, e i risultati dal 2023 mostrano che i progressi si concentrano dove un compito può essere valutato automaticamente: SWE-bench Verified è vicino al 96-97%, mentre per le attività desktop a risultato apert
AI.info Team ·
Dal completamento automatico agli agenti che agiscono
Per gran parte dell’ultimo decennio, «IA» significava un sistema che rispondeva. Si digitava una domanda, il sistema restituiva un testo e lo scambio finiva lì. La transizione in corso riguarda invece software che agisce: percepisce uno stato del mondo (una schermata, un file system, la risposta di un’API), pianifica il passo successivo, esegue un’azione, ne osserva il risultato e ripete il ciclo finché non raggiunge un obiettivo.
Questo ciclo di percezione, pianificazione e azione, costruito attorno a un modello linguistico capace di usare strumenti esterni, è ciò che oggi il settore intende per «agente». La distinzione conta perché cambia ciò che può andare storto. Nel peggiore dei casi, un chatbot produce una frase sbagliata. Nel peggiore dei casi, un agente compie un’azione sbagliata nel mondo: cancella un file, prenota un volo, rimborsa due volte un cliente.
Le basi tecniche di questa svolta precedono l’attuale ondata di entusiasmo. Nell’ottobre 2022, ricercatori di Princeton e Google pubblicarono ReAct («Synergizing Reasoning and Acting in Language Models»), mostrando che alternare passaggi espliciti di ragionamento e azioni basate sull’uso di strumenti permetteva a un modello linguistico di seguire un piano, aggiornarlo quando le azioni fallivano e rimediare agli errori molto meglio dei modelli che si limitavano a ragionare o ad agire.
Nei benchmark interattivi ALFWorld e WebShop, ReAct superò i modelli di riferimento basati sull’apprendimento per imitazione e per rinforzo rispettivamente di 34 e 10 punti percentuali nel tasso di successo assoluto, usando appena uno o due esempi nel contesto. Qualche mese dopo, Toolformer di Meta AI (febbraio 2023) mostrò un’idea complementare: un modello può imparare, in modo auto-supervisionato, quando usare una calcolatrice, un motore di ricerca o un traduttore, semplicemente verificando se la chiamata API riduce il proprio errore di previsione sul testo circostante.
Il modello da 6,7 miliardi di parametri di Toolformer ottenne il 29,4% nel benchmark matematico SVAMP, quasi il triplo del 10,0% di GPT-3 175B: un modello piccolo con lo strumento giusto batteva un modello molto più grande che ne era privo. Insieme, ReAct e Toolformer fornirono i due elementi che ogni agente successivo ha combinato: un ciclo in cui si ragiona su cosa fare dopo e un meccanismo per agire ricorrendo a risorse esterne ai parametri del modello.
L’ondata di entusiasmo del 2023 e la successiva correzione
Ciò che gli articoli di ricerca proponevano con cautela, la comunità open source lo mise a disposizione senza prudenza. AutoGPT comparve su GitHub il 30 marzo 2023, due settimane dopo il rilascio di GPT-4, con una proposta semplice: assegnargli un obiettivo, lasciarlo lavorare e tornare a lavoro finito. Superò le 30.000 stelle in 13 giorni e poco dopo oltrepassò le 100.000: secondo la maggior parte delle ricostruzioni, all’epoca era il repository cresciuto più rapidamente nella storia di GitHub.
La promessa era la piena autonomia. La realtà era un agente capace di formulare da sé i propri sotto-obiettivi, ma privo di un modo affidabile per capire se li avesse davvero raggiunti. Così si bloccava in cicli ripetitivi, contraddiceva i propri passaggi precedenti, esauriva i budget per le API e raramente portava a termine i compiti in più fasi che gli venivano assegnati.
La successiva evoluzione di AutoGPT, dall’«impiegato autonomo» verso uno strumento di automazione dei flussi di lavoro più vincolato, non fu un cambiamento di ambizione: fu il riconoscimento di quello che si rivelò il problema centrale. Non ci si può fidare di un agente che non sa verificare i propri progressi abbastanza da lasciarlo operare senza supervisione.
Questa correzione cambiò il modo di porre la domanda di ricerca del settore. Anziché «un modello può decidere cosa fare?», la domanda più difficile diventò «è possibile rendere un sistema composto da modello e strumenti abbastanza affidabile da compiere più di pochi passaggi senza che un essere umano debba accorgersi quando devia dall’obiettivo?». Tutto ciò che è seguito — interfacce standardizzate per gli strumenti, esecuzione in ambienti isolati, valutazione strutturata dei compiti, ambiti di applicazione più ristretti — è una risposta a questo cambio di prospettiva.
Dare le mani agli agenti: computer use, Operator e MCP
Due sviluppi infrastrutturali, alla fine del 2024, hanno trasformato l’«agente» da tecnica di prompting a categoria di prodotti. Il 22 ottobre 2024 Anthropic ha presentato una beta pubblica di «computer use» per Claude 3.5 Sonnet: il modello poteva osservare uno screenshot, decidere dove spostare un cursore virtuale, fare clic e digitare, così da usare normali software desktop mai progettati per avere un’API.
Anthropic ha chiarito che la capacità era ancora rudimentale: scorrere, trascinare e usare lo zoom restavano operazioni poco affidabili. Ha inoltre introdotto misure di sicurezza per azioni sensibili, come quelle relative a contenuti elettorali o all’interazione con siti governativi. OpenAI ha seguito con Operator il 23 gennaio 2025, rendendolo disponibile agli abbonati al piano Pro in anteprima di ricerca il 1° febbraio. Operator si basava su un modello «Computer-Using Agent» che combinava le capacità visive di GPT-4o con un ragionamento addestrato tramite apprendimento per rinforzo sui pixel grezzi, usando mouse e tastiera virtuali.
La parabola di Operator è istruttiva: è stato integrato nel più ampio prodotto «ChatGPT agent» e la sua interfaccia autonoma è stata dismessa il 31 agosto 2025, poco più di sette mesi dopo il lancio. Lo schema si è poi ripetuto. Agent Builder di OpenAI, uno strumento no-code lanciato verso la fine del 2025, è stato dichiarato deprecato nel giugno 2026 e sarà dismesso il 30 novembre 2026, circa un anno dopo la sua comparsa. Il computer use come categoria continua a cambiare in tempo reale; nessuno, nemmeno i laboratori che lo sviluppano, ha ancora individuato la forma di prodotto giusta.
L’altro sviluppo infrastrutturale era meno visibile nelle demo, ma forse più importante: il Model Context Protocol. Anthropic ha reso MCP open source nel novembre 2024 come modalità standard con cui un modello può individuare e chiamare strumenti — file system, database, prodotti SaaS — senza che ogni integrazione richieda codice di raccordo su misura. L’argomento era strutturale: i modelli erano «intrappolati in compartimenti stagni di informazioni» e ogni nuova fonte di dati richiedeva un connettore personalizzato.
L’importanza di MCP sta nel fatto che è stato adottato anche fuori da Anthropic, tra gli altri da OpenAI e Google DeepMind, e poi ha cessato del tutto di appartenere ad Anthropic. Il 9 dicembre 2025 Anthropic ha donato il protocollo alla Agentic AI Foundation, un fondo a gestione dedicata nell’ambito della Linux Foundation, cofondato con Block e OpenAI e sostenuto da Google, Microsoft, AWS, Cloudflare e Bloomberg. In circa tredici mesi, un componente infrastrutturale interno a un’azienda è diventato un’infrastruttura neutrale. Standardizzare il modo in cui un agente si collega a uno strumento non rende l’agente più affidabile, ma permette di progettare l’affidabilità una volta sola, a livello di protocollo, anziché per ogni integrazione: è lo stesso motivo per cui una porta comune conta più di qualsiasi singolo dispositivo che la utilizzi.
Che cosa mostrano davvero i benchmark
Generare entusiasmo è facile; dimostrare capacità misurabili no. Quattro benchmark, letti in sequenza, raccontano una storia coerente su dove si trovano gli agenti e perché.
WebArena, introdotto nel 2023 per mettere alla prova gli agenti con attività realistiche sul web (acquisti, forum, hosting di codice, gestione dei contenuti), ha rilevato che il miglior agente basato su GPT-4 completava dall’inizio alla fine solo il 14,41% dei compiti, contro un tasso di successo umano del 78,24% su un campione di un compito per ciascuno dei 170 template. Non era un benchmark che un agente fosse vicino a saturare: mostrava che, all’epoca, la navigazione autonoma sul web perlopiù non funzionava.
| Benchmark | Metrica | Punteggio |
|---|---|---|
| WebArena | Tasso di successo umano | 78,24% |
| WebArena | Miglior agente basato su GPT-4 | 14,41% |
| GAIA | Tasso di successo umano | ~92% |
| GAIA | GPT-4 + plugin | ~15% |
Tau-bench, pubblicato a metà del 2024 per mettere alla prova agenti impegnati in conversazioni realistiche a più turni con clienti simulati, nel rispetto delle politiche aziendali (in contesti di vendita al dettaglio e trasporto aereo), rivela meglio perché gli agenti falliscono, non solo quanto spesso. Nella sua classifica congelata, GPT-4o ha raggiunto un tasso di successo del 60,4% nei compiti di vendita al dettaglio e del 42,0% in quelli delle compagnie aeree a pass^1 (successo in un tentativo); Claude 3.5 Sonnet (ottobre 2024) ha migliorato quei risultati, arrivando rispettivamente al 69,2% e al 46,0%.
Ma il dato più importante dello studio è quello che accade con pass^k, che richiede a un agente di riuscire in tutti i k tentativi indipendenti dello stesso compito, anziché in uno soltanto: il punteggio di GPT-4o nella vendita al dettaglio scende da circa il 60% a pass^1 a circa il 25% a pass^8. Lo stesso agente, alle prese otto volte con lo stesso compito, non produce in modo affidabile lo stesso risultato ogni volta. Questa instabilità — non la mancanza di capacità in sé — è il principale problema irrisolto nell’impiego degli agenti ovunque un’azienda abbia bisogno di una risposta coerente.
| Modello / regime (tau-bench, 2024) | Vendita al dettaglio | Compagnie aeree |
|---|---|---|
| GPT-4o (pass^1, successo in un tentativo) | 60,4% | 42,0% |
| Claude 3.5 Sonnet, ott 2024 (pass^1) | 69,2% | 46,0% |
| GPT-4o (pass^8, solo vendita al dettaglio) | ~25% | — |
Tau-bench è stato poi sostituito dal suo successore, tau-squared-bench, e i risultati di punta hanno fatto molta strada. La classifica di OpenRouter per la sezione Airline di tau-squared-bench, ottenuta il 19 settembre 2026, colloca Gemini 3.7 Flash all’80,6%, Claude Fable 5 all’80,0% e Claude Opus 5 al 79,2%, contro il 42,0% ottenuto da GPT-4o nella sezione dedicata alle compagnie aeree nel 2024. Ciò che non è cambiato è quanto riporta la classifica: l’accuratezza di una singola esecuzione, senza una colonna pass^k. Il numero che tutti citano è ancora un numero pass^1, e nulla di ciò che ha sostituito tau-bench ha superato la sua conclusione: pass^1 presenta gli agenti sotto una luce più favorevole di quanto meritino.
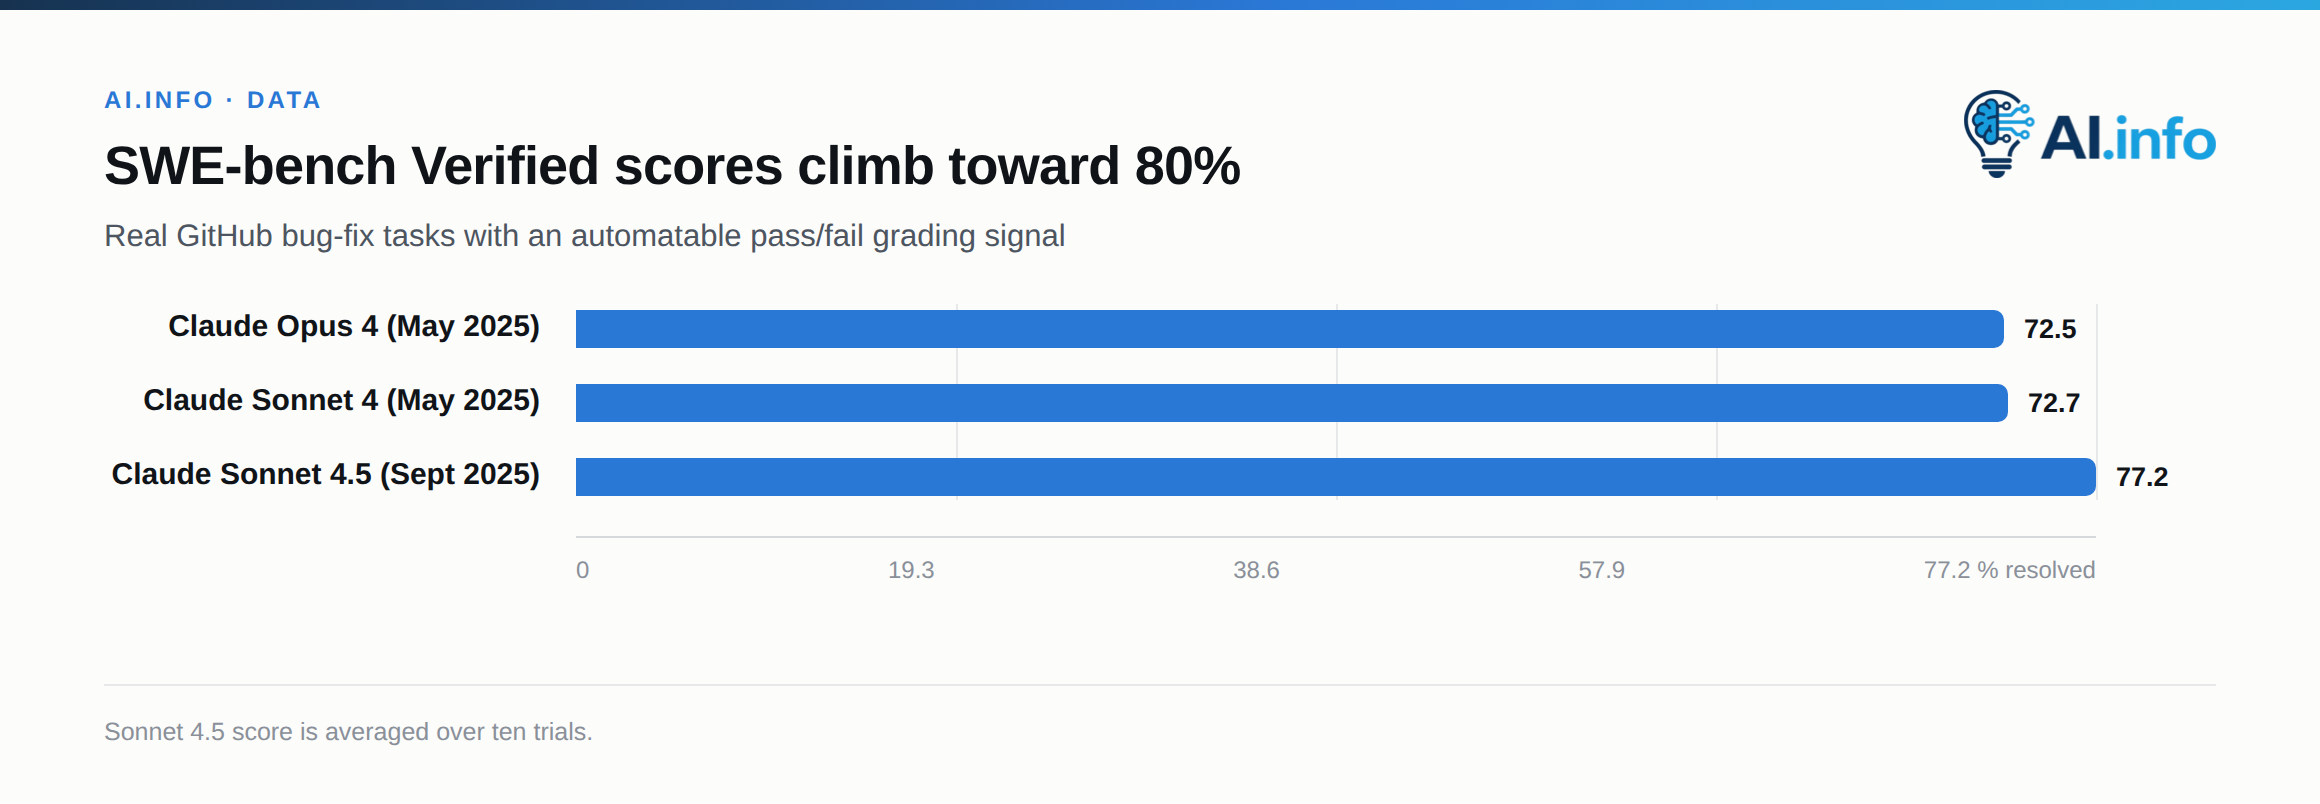
SWE-bench Verified, un sottoinsieme di 500 problemi reali di correzione di bug su GitHub, convalidati da esseri umani e introdotto da OpenAI e dagli autori originali di SWE-bench nell’agosto 2024, è il benchmark in cui i progressi degli agenti sono stati più misurabili, perché «la suite di test è stata superata?» offre un criterio di valutazione inequivocabile e automatizzabile, una rarità nella valutazione degli agenti. Claude Opus 4 e Claude Sonnet 4 di Anthropic (maggio 2025) hanno ottenuto rispettivamente il 72,5% e il 72,7%; Claude Sonnet 4.5 (settembre 2025) ha raggiunto il 77,2% come media di dieci prove.
Quei dati appartengono ormai al passato e il benchmark è vicino alla saturazione. La rilevazione di BenchLM del 18 settembre 2026 colloca Claude Opus 5 al 96%, Claude Mythos 5 al 95,5% e Claude Fable 5 al 95%; quella di Vals.ai del 1º settembre 2026 colloca Opus 5 al 97% e indica che sette degli 86 modelli valutati hanno ottenuto almeno il 95%. Le due rilevazioni differiscono di un punto sul modello in testa, e nessuna lascia molto margine al di sopra.
Il progresso è reale ed è concentrato proprio nell’unico ambito in cui il risultato prodotto da un agente può essere verificato meccanicamente anziché valutato da una persona.
GAIA, un benchmark costruito per valutare compiti da assistente generalista che richiedono navigazione sul web, ragionamento in più passaggi e gestione di file, ha mostrato con nettezza il divario nel suo studio originale del 2023: le persone coinvolte hanno risolto circa il 92% delle domande, mentre GPT-4 con l’aggiunta di plugin ne ha risolto circa il 15%. Le domande di GAIA sono concepite per essere concettualmente semplici per una persona e difficili per un agente proprio perché richiedono di concatenare diversi passaggi inaffidabili — una ricerca, la lettura di un file, una verifica aritmetica — nei quali un solo errore, in qualsiasi punto della catena, invalida la risposta finale.
Il problema degli errori che si accumulano
Considerati insieme, i quattro benchmark indicano un unico meccanismo che spiega gran parte del divario: gli errori si moltiplicano a ogni passaggio, e la maggior parte dei compiti di valore richiede molti passaggi. Se un agente è affidabile al 95% in ciascuna singola azione — una stima generosa per l’uso reale degli strumenti — la probabilità che completi un compito di 20 passaggi senza commettere nemmeno un errore è 0,95 elevato alla 20ª potenza, cioè circa il 36%.
Con un’affidabilità del 90% per passaggio, un compito di 20 passaggi riesce solo nel 12% circa dei casi. È esattamente ciò che misurano direttamente i risultati pass^k di tau-bench: non «l’agente sa svolgere il compito?», ma «l’agente sa svolgerlo allo stesso modo ogni volta?». E la risposta, anche per i modelli di frontiera nel 2024–2025, era spesso no.
È per questo che gli ambiti in cui gli agenti hanno compiuto i progressi reali più rapidi — la programmazione e i flussi di lavoro aziendali dall’ambito ben delimitato — sono quelli in cui si può contenere il numero di passaggi oppure è disponibile, alla fine, una verifica automatizzabile e poco costosa (i test vengono superati, una diff viene compilata, un campo strutturato supera la validazione). Questo permette al sistema di riprovare, anziché propagare senza che nessuno se ne accorga un risultato intermedio errato.
È anche per questo che gli agenti generalisti per l’«uso del computer», chiamati a completare compiti aperti e articolati in molti passaggi attraverso software imprevedibili, senza una verifica formale del successo, restano la categoria più difficile e meno affidabile. La risposta del settore è stata alzare l’asticella non appena gli agenti l’hanno superata: OSWorld, nel cui paper originale il miglior modello otteneva il 12,24% contro un risultato umano di riferimento del 72,36%, ha visto agenti dichiarare punteggi superiori a quel riferimento e il 26 giugno 2026 ha pubblicato OSWorld 2.0, dove il miglior agente completa il 20,6% dei compiti. Chi lavora sugli agenti per browser in produzione sostiene che i benchmark non abbiano mai misurato ciò che causa davvero i problemi: selettori DOM che cambiano, accessi scaduti, banner dei cookie e finestre modali, bruschi limiti di frequenza e azioni che non si possono annullare. Come si legge in un’analisi del 2026, «i benchmark pubblici misurano il completamento quando tutto va come previsto; in produzione si misura la capacità di recupero per ciascun tipo di errore». Il risultato iniziale di WebArena, pari a 14 punti, e la breve vita commerciale di Operator sono due sintomi della stessa difficoltà.
Il calcolo degli errori che si accumulano spiega anche un fenomeno che a prima vista sembra paradossale: gli agenti appaiono spesso impressionanti in una singola dimostrazione e inaffidabili in produzione. Una demo è, per sua natura, un percorso riuscito mostrato dopo aver scartato quelli falliti; un valore pass^1 misura il successo di un compito in un singolo tentativo, non questa selezione dei soli tentativi riusciti. L’impiego in produzione, invece, richiede una coerenza di livello pass^k su migliaia di input mai visti: un’asticella fondamentalmente più alta che fare bella figura una volta sola.
La tabella di marcia interna di ogni laboratorio deve ormai fare i conti con questo divario tra una demo convincente e un sistema affidabile. È per questo che l’«affidabilità», più che l’«intelligenza pura», è diventata la metrica che determina se un agente viene distribuito.
Le prospettive
La traiettoria indicata dagli ultimi tre anni non è quella di «agenti che diventano sempre più intelligenti in ogni ambito, finché non sapranno fare tutto». È più circoscritta, e più utile: i progressi si concentrano dove esiste un segnale di verifica e si arrestano dove non c’è. Negli anni successivi è andata così: il benchmark valutabile meccanicamente è quasi saturo, mentre quello aperto sull’uso del desktop è stato sostituito con una versione più difficile dopo che gli agenti avevano superato il suo risultato umano di riferimento. È probabile che la prossima fase di sviluppo degli agenti assomigli meno a un aumento dell’autonomia e più a un potenziamento delle verifiche: ambienti di esecuzione isolati, approvazioni esplicite prima di azioni irreversibili, sistemi di valutazione che confrontano l’output di un agente con una griglia di criteri prima di accettarlo e cicli di nuovi tentativi che considerano un singolo tentativo sacrificabile, anziché definitivo.
Niente di tutto questo richiede un modello di base più intelligente; richiede di trattare l’affidabilità come un problema ingegneristico con propri strumenti fondamentali, così come i sistemi distribuiti hanno trattato i guasti di rete come una questione di primaria importanza, anziché come un inconveniente da nascondere in una demo.
Da questo cambio di prospettiva derivano altri due cambiamenti. Primo, le architetture basate su un singolo agente continueranno a cedere terreno a sistemi che dividono un compito lungo tra più agenti specializzati — uno pianifica, uno esegue, uno verifica il lavoro di chi esegue rispetto al piano — perché un coordinatore che deve soltanto verificare l’output di un agente subordinato affronta un problema più piccolo e più facile da verificare rispetto a quello di un singolo agente che prova sia ad agire sia a controllare il proprio operato lungo venti passaggi.
Secondo, l’unità di misura del progresso passerà da «il modello sa rispondere a questa domanda?» a «quante risorse — in chiamate agli strumenti, token o tempo effettivo — servono per arrivare a una risposta verificata?». Quando riprovare costa poco e la verifica è automatica, la questione economicamente rilevante è l’efficienza, non se il successo sia possibile.
La previsione onesta è che gli agenti generalisti pienamente autonomi — la promessa di AutoGPT del 2023 — siano più lontani di quanto suggerisca il marketing, mentre gli agenti specializzati, verificabili, che compiono molti passaggi ma il cui lavoro si può controllare — assistenti alla programmazione, pipeline di dati strutturati, flussi di lavoro con un chiaro segnale di successo o fallimento — siano più vicini di quanto pensino gli scettici e vengano già distribuiti. Il livello dei protocolli aperto da MCP continuerà a consolidarsi, così che collegare un nuovo strumento non richieda più un lavoro ingegneristico su misura.
I punteggi dei benchmark continueranno a salire nei compiti con criteri di valutazione chiari e a restare indietro in quelli che richiedono giudizio in condizioni di ambiguità. E i sistemi vincenti non saranno i primi a rivendicare la piena autonomia: saranno quelli che renderanno i singoli errori di un agente poco costosi, visibili e recuperabili. Perché, con tassi di errore realistici per passaggio, è l’unico modo in cui un piano di venti passaggi possa arrivare alla fine nello stesso modo per due volte.