Orizzonti futuri
L’IA e il futuro del lavoro: la questione dei 300 milioni di posti
I 300 milioni di Goldman Sachs, il saldo positivo di 78 milioni del WEF e l’1,1% di Acemoglu rispondono a domande più circoscritte di quelle che vengono loro poste. Che cosa hanno misurato davvero gli studi randomizzati e i dati sulle buste
Gabriele Masetti ·
Il numero che ha fatto nascere mille titoli
Nel marzo 2023, gli economisti di Goldman Sachs Joseph Briggs e Devesh Kodnani pubblicarono un rapporto, «The Potentially Large Effects of Artificial Intelligence on Economic Growth», che fornì al dibattito sull’IA e il lavoro la sua statistica più citata: l’IA generativa potrebbe esporre a un certo grado di automazione l’equivalente di 300 milioni di posti di lavoro a tempo pieno nel mondo. La cifra si diffuse rapidamente e, nei resoconti successivi, finì spesso per diventare un’affermazione che il rapporto non aveva mai fatto: che 300 milioni di persone avrebbero perso il lavoro.
L’analisi alla base era più circoscritta e prudente di quanto suggerissero i titoli. Briggs e Kodnani stimavano che circa il 18% del lavoro nel mondo potesse essere informatizzato con le attuali capacità dell’IA generativa, che circa due terzi delle professioni negli Stati Uniti fossero esposti a un certo grado di automazione e che, tra queste professioni, una quota compresa fra un quarto e la metà del carico di lavoro fosse potenzialmente sostituibile.
L’esposizione variava molto a seconda della professione: era del 46% per il lavoro d’ufficio e il supporto amministrativo, del 44% per le professioni legali e del 37% per architettura e ingegneria, mentre restava sotto il 10% nelle costruzioni, nell’installazione e manutenzione e nei lavori di cura degli edifici e degli spazi esterni. Un punto cruciale: «esposto» significava che alcune mansioni all’interno di un lavoro potevano essere automatizzate o potenziate, non che il posto stesso sarebbe scomparso.
Lo stesso rapporto prevedeva che un’adozione diffusa potesse far crescere il PIL mondiale di circa il 7%, ovvero quasi 7.000 miliardi di dollari, nell’arco di dieci anni. Era una prospettiva di aumento della produttività presentata accanto a quella della sostituzione dei lavoratori, nello stesso documento, ma in gran parte ignorata da chi citava soltanto la cifra dei 300 milioni.
Anche la distribuzione geografica dell’esposizione era molto disomogenea, benché pure questo dettaglio finisse raramente nei titoli. Il modello di Goldman collocava Hong Kong, Israele, Giappone, Svezia e Stati Uniti tra i paesi più esposti all’automazione trainata dall’IA, rispecchiando economie con un’elevata concentrazione di professioni impiegatizie caratterizzate da mansioni di routine. I lavoratori della Cina continentale, della Nigeria, del Vietnam, del Kenya e dell’India si trovavano invece all’estremo opposto, soprattutto perché i loro mercati del lavoro sono più orientati verso professioni — agricoltura, servizi informali, mestieri manuali — che l’IA generativa, a differenza della robotica, non è ancora in grado di trasformare.
La cifra di 300 milioni, dunque, non è una previsione di dove l’automazione avrà le conseguenze più pesanti per le persone, ma di dove le mansioni lavorative coincidono maggiormente con ciò che i modelli linguistici sanno fare oggi.
Che cosa dice davvero il World Economic Forum per il 2025
L’altra cifra che circola di continuo proviene dal Future of Jobs Report del World Economic Forum. È facile sbagliare, perché il WEF ha pubblicato stime che si sovrappongono, riferite però ad anni diversi, e i resoconti sugli effetti dell’IA sul lavoro le hanno talvolta confuse. L’edizione del 2020, con un orizzonte al 2025, prevedeva la perdita di 85 milioni di posti di lavoro a fronte della creazione di 97 milioni di nuovi posti. Queste due cifre risalgono a sei anni fa e si riferiscono a un orizzonte di previsione del tutto diverso.
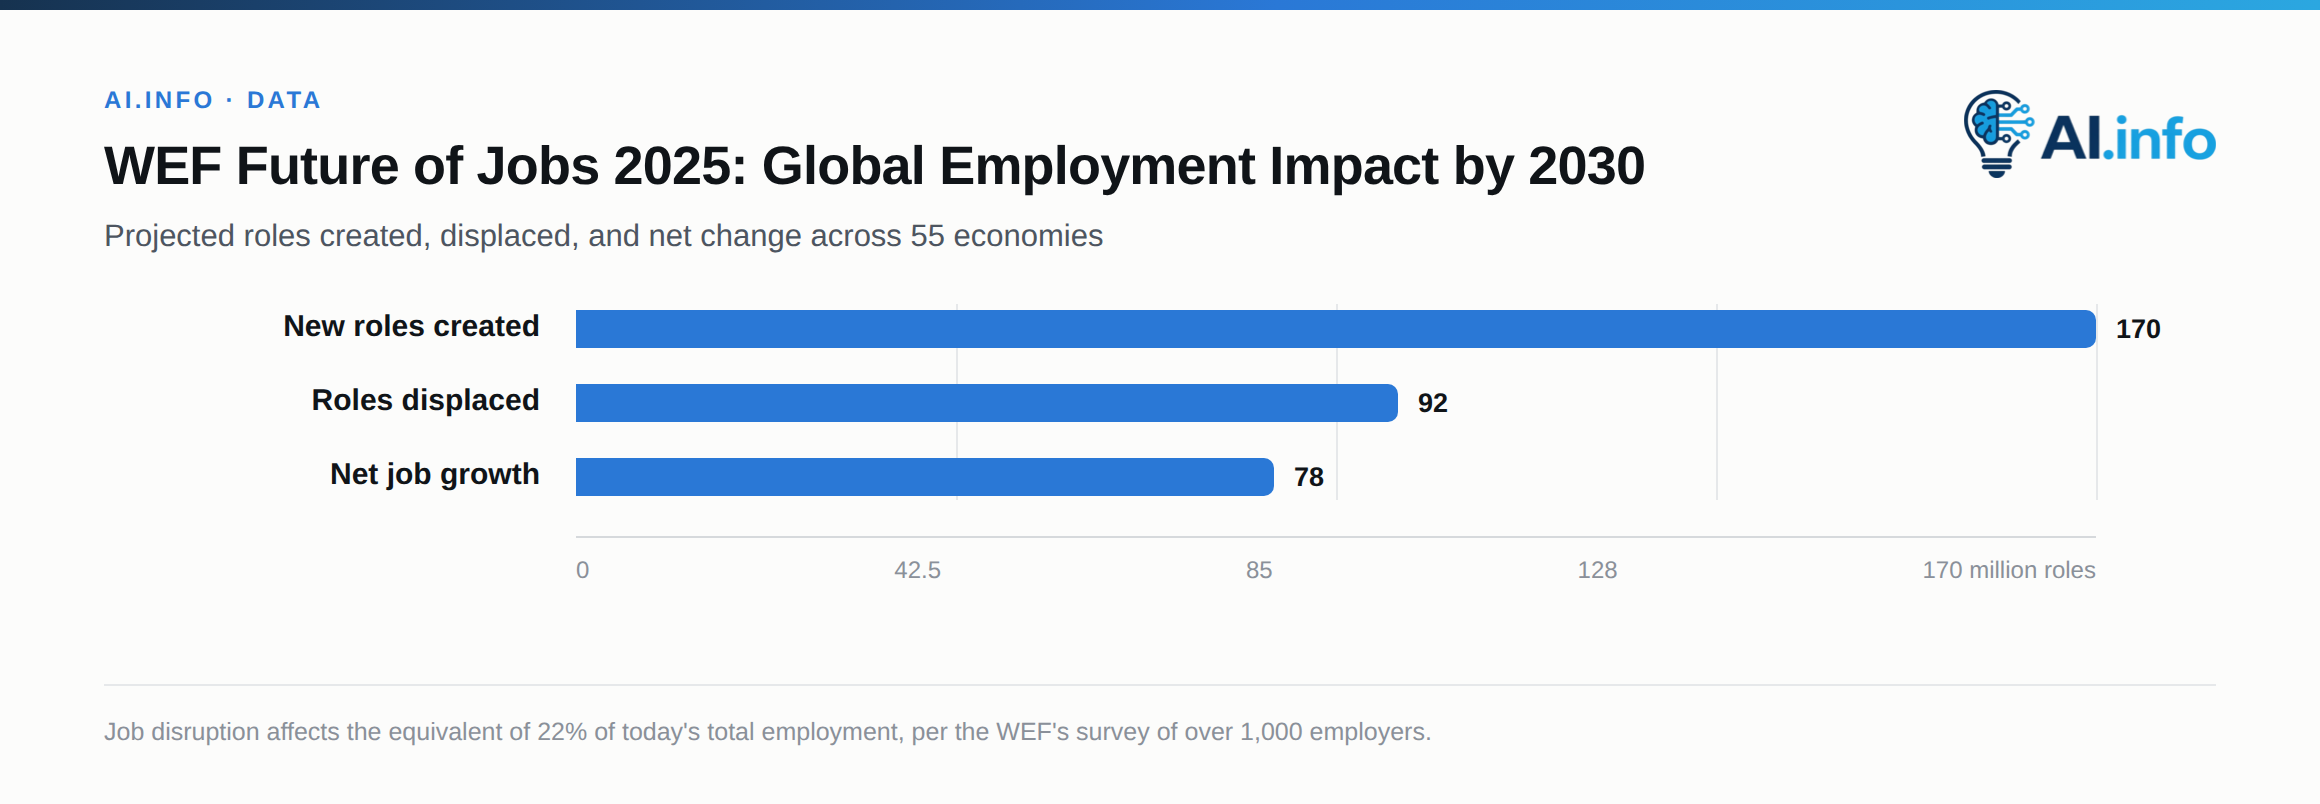
Il rapporto che continua a fare da riferimento è il Future of Jobs Report 2025, pubblicato dal WEF nel gennaio 2025 e — dato che la serie esce ogni due anni — ancora l’edizione di riferimento diciotto mesi dopo. Si basa su un’indagine condotta presso oltre 1.000 datori di lavoro, che rappresentano più di 14 milioni di lavoratori in 55 economie. Il suo orizzonte è il 2030, non il 2025, e le cifre sono 170 milioni di nuovi posti creati a fronte di 92 milioni di posti persi, per un saldo positivo di 78 milioni di posti di lavoro. I cambiamenti occupazionali riguarderebbero l’equivalente del 22% dell’occupazione totale attuale.
Le professioni in più rapida crescita si concentrano tra gli specialisti di tecnologia, dati e IA, ma comprendono anche lavori meno evidentemente legati all’IA, come gli addetti alle consegne, chi svolge lavori di cura, gli insegnanti e i lavoratori agricoli: un riflesso delle tendenze demografiche e della transizione verde che si sommano all’automazione. Il rapporto segnala anche un problema di competenze distinto dalla questione del numero di posti: i datori di lavoro si aspettano che il 39% delle competenze attuali dei lavoratori venga trasformato o diventi obsoleto entro cinque anni. È probabilmente la cifra più importante dell’intero documento, perché riguarda anche chi conserva il lavoro, non soltanto chi lo perde.
La replica dello scettico: Acemoglu e la macroeconomia dell’IA
A queste previsioni sulla produzione e sull’occupazione si contrappone una netta obiezione accademica: lo studio "The Simple Macroeconomics of AI" dell’economista del MIT e premio Nobel Daron Acemoglu, diffuso dall’NBER e dal dipartimento di economia del MIT nel 2024 e successivamente pubblicato su Economic Policy. Acemoglu parte da stime dell’esposizione delle singole attività simili, nell’impostazione, a quelle di Goldman, ma valuta con maggiore prudenza quali attività esposte sia effettivamente conveniente automatizzare, tenendo conto dell’accuratezza attuale, dei costi di integrazione e della necessità di supervisione umana.
La sua conclusione: solo il 5% circa delle attività sarà probabilmente automatizzabile in modo economicamente conveniente nel prossimo decennio. Questo si tradurrebbe in un incremento «non trascurabile, ma modesto» del PIL statunitense, pari a circa l’1,1%-1,6% cumulato nell’arco di dieci anni, insieme a un aumento della produttività totale dei fattori che stima non superiore allo 0,7% circa nello stesso periodo: ben al di sotto degli incrementi annui di diversi punti percentuali impliciti nelle proiezioni più ottimistiche del settore.
Acemoglu va oltre, sostenendo che anche queste stime modeste potrebbero essere ottimistiche, perché le prime evidenze sugli aumenti di produttività provengono da attività ben definite e facili da apprendere, mentre gran parte del lavoro esposto che rimane richiede valutazioni dipendenti dal contesto, che i modelli attuali gestiscono in modo molto meno affidabile. Goldman Sachs ha pubblicato una replica diretta a difesa del proprio approccio più ottimistico. Più che una controversia risolta, il confronto mette in luce una questione ancora aperta nel modo in cui gli economisti modellano la diffusione dell’IA: quanto rapidamente migliorerà l’accuratezza, quanto in fretta le aziende riorganizzeranno i flussi di lavoro attorno a un nuovo strumento e quanta parte dell’«esposizione» si tradurrà mai in «adozione».
L’approccio di Acemoglu non nega che, col tempo, l’IA automatizzerà moltissime attività; sostiene che nelle previsioni che fanno notizia l’espressione «col tempo» porta molto peso e che il divario tra ciò che un modello sa fare in una dimostrazione e ciò che un’azienda si fiderà di lasciargli fare senza supervisione, su larga scala e alle prese con tutta la complessità delle attività aziendali reali, si colma molto più lentamente di quanto suggeriscano le percentuali di esposizione. È proprio questo divario che gli esperimenti sul campo descritti di seguito sono stati progettati per misurare direttamente, anziché dedurlo dalle classificazioni professionali.
Che cosa mostrano davvero gli studi randomizzati
Mentre i macroeconomisti discutono sulle proiezioni aggregate, gli esperimenti sul campo hanno misurato che cosa succede alla produttività quando lavoratori in carne e ossa usano strumenti di IA per svolgere compiti reali. Gli studi non sono più pochi e i loro risultati non vanno tutti nella stessa direzione: il singolo risultato più netto è negativo.
Il più citato è «Navigating the Jagged Technological Frontier», uno studio controllato randomizzato condotto da ricercatori della Harvard Business School, del MIT, di Warwick e del Boston Consulting Group (Dell’Acqua e coautori) su 758 consulenti di BCG, pubblicato nel settembre 2023. I consulenti che avevano accesso a GPT-4 hanno completato il 12,2% di compiti in più, il 25,1% più velocemente, e prodotto lavori giudicati di qualità superiore di oltre il 40% rispetto a un gruppo di controllo, ma solo per i compiti che rientravano in quella che gli autori hanno chiamato la «frontiera frastagliata» del modello.
Per un compito progettato esplicitamente per collocarsi al di fuori delle capacità affidabili di GPT-4, i consulenti assistiti dall’IA avevano una probabilità inferiore di 19 punti percentuali di fornire una risposta corretta. Spesso, però, non se ne rendevano conto: non sapevano distinguere da quale lato della frontiera si trovassero. Anche i guadagni di produttività variavano in base alle competenze: le prestazioni dei consulenti sotto la media sono migliorate di circa il 43%, quelle dei migliori di circa il 17%. L’IA riduceva quindi il divario tra chi otteneva risultati migliori e peggiori, anziché potenziare tutti nella stessa misura.
| Studio | Contesto | Risultato sulla produttività |
|---|---|---|
| Consulenti BCG (Dell’Acqua et al., 2023) | Consulenza, GPT-4 | +12,2% di compiti, 25,1% più velocemente, qualità superiore di >40% |
| Studio randomizzato controllato su GitHub Copilot (Peng et al., 2023) | Ingegneria del software, singolo compito | ~55,8% più velocemente |
| Studio randomizzato controllato su più aziende (Microsoft/Accenture/Fortune 100) | Ingegneria del software, flussi di lavoro reali | Aumento della produzione di ~26% |
| Assistenza clienti (Brynjolfsson, Li, Raymond) | 5.179 operatori, azienda Fortune 500 | +14% in media; +34% per gli operatori inesperti |
| Studio randomizzato controllato di METR (Becker, Rush, Barnes, Rein, 2025) | 16 sviluppatori open source esperti, 246 compiti | 19% PIÙ LENTI con l’IA, pur credendo di essere più veloci del 20% |
Un andamento parallelo emerge nell’ingegneria del software. Un esperimento controllato del 2023 su GitHub Copilot (Peng, Kalliamvakou, Cihon e Demirer, arXiv:2302.06590) ha rilevato che gli sviluppatori con accesso a Copilot completavano un compito di programmazione definito circa il 55% più velocemente rispetto a un gruppo di controllo, con un ampio intervallo di confidenza che rifletteva la variabilità legata al compito specifico.
Un altro studio, più ampio, composto da tre sperimentazioni randomizzate condotte presso Microsoft, Accenture e un’azienda manifatturiera Fortune 100 anonima, ha coinvolto migliaia di sviluppatori ed è stato guidato da ricercatori di Microsoft, MIT, Princeton e Wharton. Anziché misurare le prestazioni su un singolo benchmark, ha esaminato indicatori dei flussi di lavoro reali — pull request, commit e build — e ha riscontrato un aumento della produzione più contenuto, ma comunque sostanziale, di circa il 26%, con benefici sproporzionati per gli sviluppatori meno esperti e assunti più di recente.
Poi i risultati sul software hanno smesso di andare tutti nella stessa direzione. Nel luglio 2025 METR, un’organizzazione di ricerca senza scopo di lucro, ha pubblicato uno studio controllato randomizzato in cui 16 sviluppatori open source esperti hanno completato 246 compiti in repository consolidati sui quali lavoravano da cinque anni in media. Per ciascun compito veniva stabilito casualmente se consentire o vietare gli strumenti di IA disponibili alla frontiera tecnologica tra febbraio e giugno 2025. Prima di iniziare, gli sviluppatori prevedevano che l’IA avrebbe ridotto del 24% il tempo necessario per completare i compiti. In seguito, hanno stimato che lo avesse ridotto del 20%. Secondo le misurazioni, consentire l’uso dell’IA ha aumentato il tempo necessario del 19%.
Il campione è di 16 persone e gli autori precisano chiaramente di non sostenere che l’IA non renda più veloce la maggior parte degli sviluppatori. Anche considerando il risultato nella sua portata più ristretta, lo scarto che emerge resta il dato più utile nella letteratura: 39 punti tra l’accelerazione che gli sviluppatori credevano di ottenere e il rallentamento registrato dal cronometro. Chi usa questi strumenti non è uno strumento di misura affidabile per valutarli: vale la pena ricordarlo ogni volta che un’indagine sull’adozione riporta guadagni stimati dagli stessi utenti.
I dati sull’assistenza clienti mostrano nel modo più chiaro la stessa distribuzione dei benefici. Erik Brynjolfsson, Danielle Li e Lindsey Raymond hanno studiato l’introduzione scaglionata di un assistente di IA generativa presso 5.179 operatori dell’assistenza clienti di un’azienda di software Fortune 500 (NBER Working Paper 31161, poi pubblicato sul Quarterly Journal of Economics).
La produttività media, misurata in problemi risolti per ora, è aumentata del 14%. Ma quella media nascondeva un guadagno del 34% per gli operatori inesperti e meno qualificati, a fronte di un guadagno sostanzialmente non misurabile per i più esperti e qualificati, la cui qualità delle conversazioni è persino calata leggermente con l’assistenza dell’IA. Lo strumento sembrava codificare e diffondere gli schemi di conversazione dei migliori operatori dell’azienda, permettendo ai nuovi arrivati con circa due mesi di servizio di raggiungere le prestazioni degli operatori senza accesso allo strumento che avevano sei mesi o più di esperienza.
Il quadro dietro i numeri
Letti insieme, questi esperimenti raccontano qualcosa di più preciso e più utile di «l’IA ti ruba il lavoro» o «l’IA conta ben poco». Descrivono un effetto di livellamento: gli strumenti di IA generativa riducono il divario di rendimento tra lavoratori inesperti ed esperti nei compiti che l’IA è in grado di svolgere in modo affidabile, mentre apportano poco o possono persino avere un effetto negativo quando un compito esce da quella zona di affidabilità. È un quadro della distribuzione degli effetti molto diverso dalle percentuali di esposizione per professione indicate nei rapporti di Goldman Sachs e del WEF: quelle percentuali dicono quali lavori comprendono compiti automatizzabili, ma non chi, all’interno di quei lavori, ci guadagna o ci perde.
Questa lettura spiega anche perché la cifra di 300 milioni di Goldman Sachs e la modesta stima di Acemoglu, pari all’1,1-1,6% del PIL, non siano in realtà così contraddittorie come sembrano se accostate. L’esposizione indica il limite massimo di ciò che potrebbe essere automatizzato, prima o poi, in condizioni ideali; la produttività effettiva dipende dai costi di integrazione, dalla tolleranza agli errori e da quanta parte di un dato compito ricade davvero, oggi, entro la «frontiera frastagliata».
Entrambe le cose possono essere vere: una quota molto ampia di compiti interessati dall’IA generativa e un effetto macroeconomico relativamente modesto nel breve periodo. Questo perché l’esposizione dei singoli compiti si traduce in produzione su scala economica solo alla velocità con cui le imprese riprogettano i flussi di lavoro, riqualificano il personale e si fidano abbastanza dei risultati dello strumento da eliminare il controllo umano.
I dati sui lavoratori all’inizio della carriera arrivati dopo gli esperimenti
Tutti gli esperimenti randomizzati citati sopra misurano la produzione per lavoratore. Nessuno dice quanti lavoratori assuma un’impresa e, nel 2026, anche su questa seconda questione erano disponibili dati.
Erik Brynjolfsson, Bharat Chandar e Ruyu Chen del Digital Economy Lab di Stanford hanno usato i dati delle buste paga di ADP, relativi a milioni di lavoratori americani fino a giugno 2026, per cercare tracce dell’IA nel numero degli occupati, anziché nella produttività. Il loro studio, rivisto nell’agosto 2026 e intitolato «Canaries in the Coal Mine», rileva che l’occupazione dei 22-25enni nelle professioni più esposte all’IA è circa il 19% al di sotto del livello suggerito dal confronto con i coetanei meno esposti, mentre i lavoratori con esperienza nelle stesse professioni non presentano un divario equivalente.
Tre caratteristiche rendono difficile liquidare quel dato. Il divario si è ampliato costantemente dall’agosto 2025, anziché manifestarsi come un episodio isolato; deriva da una riduzione delle assunzioni, non da un aumento delle uscite dal lavoro, ed è per questo che non emerge come una storia di licenziamenti; inoltre, si concentra nei ruoli in cui l’IA sostituisce il lavoro umano, mentre l’occupazione resta stabile o cresce dove l’IA lo integra.
Gli autori definiscono questi risultati primi indicatori descrittivi, segnali d’allarme più che stime causali, e gli stessi dati non mostrano una sostituzione diffusa dei lavoratori nell’intera economia. Entrambi gli aspetti contano: l’occupazione complessiva non sta crollando, ma la porta d’ingresso si è ristretta. Questo dà una nuova prospettiva all’effetto di livellamento rilevato dagli esperimenti. Uno strumento che permette a un nuovo arrivato con due mesi di esperienza di eguagliare un collega con sei mesi di esperienza accelera la formazione quando è il lavoratore a usarlo; quando a usarlo è il datore di lavoro, diventa un motivo per assumere meno nuovi arrivati.
Perché la riqualificazione è il vero collo di bottiglia
È in questo ritardo nell’integrazione che la cifra del 39% del WEF assume tutto il suo peso. Se si prevede che quasi due quinti delle competenze attualmente rilevanti per il lavoro saranno trasformate o rese obsolete entro il 2030, il vincolo decisivo non è tecnologico. È la velocità con cui i sistemi di formazione, gli investimenti dei datori di lavoro e i singoli lavoratori riescono a spostare le persone dalle competenze che l’IA sta sostituendo a quelle che lo stesso cambiamento sta creando.
Gli studi sull’assistenza clienti e sulla consulenza suggeriscono entrambi che l’assistenza dell’IA possa fungere essa stessa da meccanismo di formazione accelerato e integrato nel lavoro, accorciando la curva di apprendimento di un nuovo arrivato fino a portarlo al livello di un collega esperto. È anche il meccanismo per il quale datori di lavoro, università e governi dispongono delle strategie meno sviluppate.
Se si prevede che 92 milioni di ruoli esistenti saranno sostituiti entro il 2030, mentre ne nasceranno 170 milioni di nuovi, i lavoratori più a rischio non sono semplicemente quelli delle professioni più esposte. Sono quelli i cui datori di lavoro non dispongono delle strutture formative necessarie per portarli verso mansioni potenziate dall’IA prima che i loro vecchi compiti vengano automatizzati.
Ma un tutor informale non sostituisce un investimento deliberato, e raggiunge soltanto i lavoratori che sono stati assunti. Gli esperimenti randomizzati hanno misurato il potenziamento del lavoro, non la sua sostituzione. I dati delle buste paga che da allora hanno colmato in parte questa lacuna indicano soprattutto una riduzione delle assunzioni di giovani lavoratori, anziché un aumento delle uscite dal lavoro. Nessuna delle due fonti segue un individuo nel corso di una transizione: è proprio ciò che nessuno sta misurando bene e che tanto la cifra di 300 milioni quanto quella di 78 milioni netti finiscono per nascondere.
La lettura onesta dei dati, dunque, non è che la cifra di 300 milioni di posti di lavoro fosse sbagliata o che lo scetticismo di Acemoglu la confuti: è che entrambe le cifre rispondono a domande più circoscritte di quelle che vengono loro rivolte. L’esposizione dei compiti non equivale alla perdita di posti di lavoro. Una stima modesta dell’effetto macroeconomico sul PIL non dimostra che nei singoli luoghi di lavoro non stia cambiando nulla.
Gli esperimenti randomizzati, che misurano cosa accade quando determinati lavoratori usano questi strumenti per determinati compiti, indicano una redistribuzione di chi ottiene buoni risultati in un lavoro, più che una sostituzione di chi lo svolge. I dati delle buste paga aggiungono la parte che gli esperimenti non potevano vedere: a un’estremità del mercato del lavoro, tra i lavoratori dai 22 ai 25 anni nelle professioni esposte all’IA, quella redistribuzione si è già tradotta in una decisione sulle assunzioni. A quattro anni dall’inizio dell’era dell’IA generativa, la questione più urgente per le politiche pubbliche non è se rallentarne l’adozione per proteggere i posti di lavoro nel complesso, perché non è lì che i dati collocano il danno, ma cosa prenderà il posto della formazione sul lavoro che un ruolo iniziale offriva quando la porta d’ingresso si restringe.