Etica e governance
La lingua lasciata indietro: come l’IA sta trascurando settemila lingue e che cosa servirebbe per rimediare
I limiti dell’IA nella maggior parte delle lingue del mondo: il divario misurato dal benchmark MEGA, il lavoro della comunità Masakhane sull’elaborazione del linguaggio naturale, la sovranità dei dati maori di Te Hiku Media, BharatGen in In
AI.info Team ·
Una mappa dell’esclusione
Quando si parla della rivoluzione dell’IA, si tende a farlo dando per scontato un certo tipo di persona: qualcuno che usa l’inglese come lingua principale, dispone di un accesso affidabile a Internet ad alta velocità, interagisce con la tecnologia attraverso interfacce testuali ed è, in un certo senso, già connesso all’economia globale dell’informazione. Per questa persona — circa un miliardo di persone su un pianeta di otto miliardi — la rivoluzione dell’IA è reale, immediata e trasformativa.
Per gli altri sette miliardi, il quadro è più complicato. E per una parte molto ampia di quei sette miliardi — chi parla le circa 7.000 lingue oggi esistenti sulla Terra — la rivoluzione dell’IA non sta arrivando affatto, oppure arriva in forme che li escludono attivamente.
Di queste 7.000 lingue, meno di 100 sono rappresentate in misura significativa nei dati di addestramento dei moderni modelli linguistici di grandi dimensioni basati sul testo. Il riconoscimento vocale è un’eccezione parziale, e recente: Omnilingual ASR di Meta, pubblicato nel novembre 2025, trascrive più di 1.600 lingue. Per la lettura e la scrittura, l’accesso resta molto più limitato. Per le oltre 6.900 lingue rimanenti — tra cui tutte le lingue indigene delle Americhe, tutte le lingue aborigene dell’Australia, la maggior parte delle lingue africane, decine di lingue dell’Oceania e centinaia di lingue minoritarie dell’Asia meridionale e sud-orientale — i sistemi di IA o falliscono del tutto o funzionano così male da risultare praticamente inutili. Non funzionano solo un po’ peggio. Funzionano catastroficamente peggio.
Questo fallimento non è principalmente un problema tecnico, nel senso di una sfida difficile e ancora irrisolta alla frontiera della ricerca. I metodi per costruire modelli linguistici di alta qualità per le lingue con poche risorse esistono; i ricercatori sanno, a grandi linee, che cosa servirebbe. È un problema di priorità, risorse e potere: la questione è quali lingue siano ritenute degne di investimento, e da chi.
La risposta che l’attuale industria dell’IA ha dato attraverso le sue decisioni sull’allocazione delle risorse è che la maggior parte delle lingue non ne vale la pena. Le conseguenze di questa risposta, che si dispiegheranno nell’arco di decenni, saranno profonde.
Che cosa mostrano davvero i dati
Una delle valutazioni sistematiche più rigorose delle prestazioni dei modelli linguistici in lingue diverse proviene dal benchmark MEGA (Multilingual Evaluation of Generative AI), pubblicato da un gruppo di ricercatori che comprende Kabir Ahuja, Harshita Diddee, Rishav Hada, Millicent Ochieng, Prachi Jain, Kalika Bali e altri: una collaborazione guidata da Microsoft Research India, con coautori della University of Washington, di Carnegie Mellon e di Johns Hopkins.
MEGA ha valutato i modelli linguistici più avanzati dell’epoca — tra cui GPT-4, GPT-3.5, mT5, BLOOMZ e altri — su una serie di compiti di elaborazione del linguaggio naturale (risposta a domande, inferenza in linguaggio naturale, ragionamento basato sul senso comune, traduzione automatica) in 70 lingue. Le differenze nelle prestazioni erano nette.
Nelle lingue con abbondanti risorse — inglese, francese, tedesco, spagnolo, cinese, giapponese — GPT-4 raggiungeva, nella maggior parte dei compiti, un’accuratezza pari o vicina a quella umana. Nelle lingue con risorse intermedie — hindi, swahili, turco, persiano — le prestazioni erano sostanzialmente inferiori, ma ancora funzionali. Nelle lingue con poche risorse — tra cui creolo haitiano, birmano, oriya e decine di lingue africane — le prestazioni crollavano: in alcuni casi l’accuratezza si avvicinava a quella del caso, in altri scendeva sotto quella di modelli multilingue più piccoli e specializzati, addestrati appositamente per quelle lingue.
I numeri precisi variano a seconda del compito e del modello, ma i risultati tipici della valutazione MEGA mostravano che l’accuratezza di GPT-4 nel ragionamento basato sul senso comune scendeva dal 90% circa per l’inglese al 70–75% per l’hindi, al 60–65% per lo swahili e sotto il 50% per molte lingue con poche risorse: prestazioni che sarebbero considerate inaccettabilmente scarse se ottenute in compiti in inglese.
Queste cifre sono una fotografia dell’epoca di GPT-4, e da allora i modelli più avanzati si sono succeduti più volte. Il divario che descrivono, però, dipende dalla quantità di testo disponibile in ciascuna lingua, e questo non è cambiato: la graduatoria delle lingue per quantità di dati di addestramento disponibili nel 2026 è molto simile a quella del 2023.
Due fattori spiegano questo divario nelle prestazioni. Il primo è il volume dei dati di addestramento: la quantità di testo disponibile per l’addestramento varia enormemente da una lingua all’altra. Per l’inglese esistono centinaia di miliardi di parole di testi web di alta qualità; per molte lingue minoritarie esistono meno di un milione di parole in formato digitale. Il secondo è la qualità dei dati: anche quando esistono dati testuali in una lingua, potrebbero non essere adatti all’addestramento — potrebbero mancare di un’ortografia coerente, mescolare lingue all’interno delle frasi o consistere principalmente in testi dei social media con usi linguistici non standard.
Chi subisce le conseguenze
Per capire la portata di questo fallimento, vale la pena precisare chi sono le persone coinvolte.
Le circa 1.500 lingue dell’Africa subsahariana sono parlate da oltre un miliardo di persone. La maggior parte è del tutto assente dai principali sistemi di IA oppure è rappresentata soltanto nei dati di addestramento di qualità più bassa. Una persona che gestisce un’attività a Lagos e parla yoruba, se vuole usare strumenti di IA per redigere documenti, rispondere alle domande dei clienti o cercare informazioni, deve farlo in inglese — partendo svantaggiata rispetto a chi è madrelingua inglese — oppure affidarsi a un’assistenza dell’IA che è effettivamente inaffidabile.
| Regione | Lingue | Parlanti/note |
|---|---|---|
| Africa subsahariana | ~1.500 | Oltre un miliardo di persone |
| Papua Nuova Guinea | ~800 | Tra le più alte densità linguistiche al mondo |
| Australia (lingue aborigene) | ~300 | La maggior parte è gravemente a rischio di estinzione |
| Dati di addestramento degli LLM testuali | Meno di 100 | Rappresentate in misura significativa; i modelli vocali ora arrivano a 1.600+ |
Le circa 800 lingue della Papua Nuova Guinea — una delle più alte densità linguistiche al mondo — sono quasi del tutto assenti. Le circa 300 lingue aborigene dell’Australia, la maggior parte delle quali è gravemente a rischio di estinzione, non hanno praticamente alcuna rappresentazione nei sistemi commerciali di IA. Le lingue indigene delle Americhe — dal navajo e dal cherokee al quechua e al guaraní — sono in gran parte assenti, nonostante abbiano milioni di parlanti.
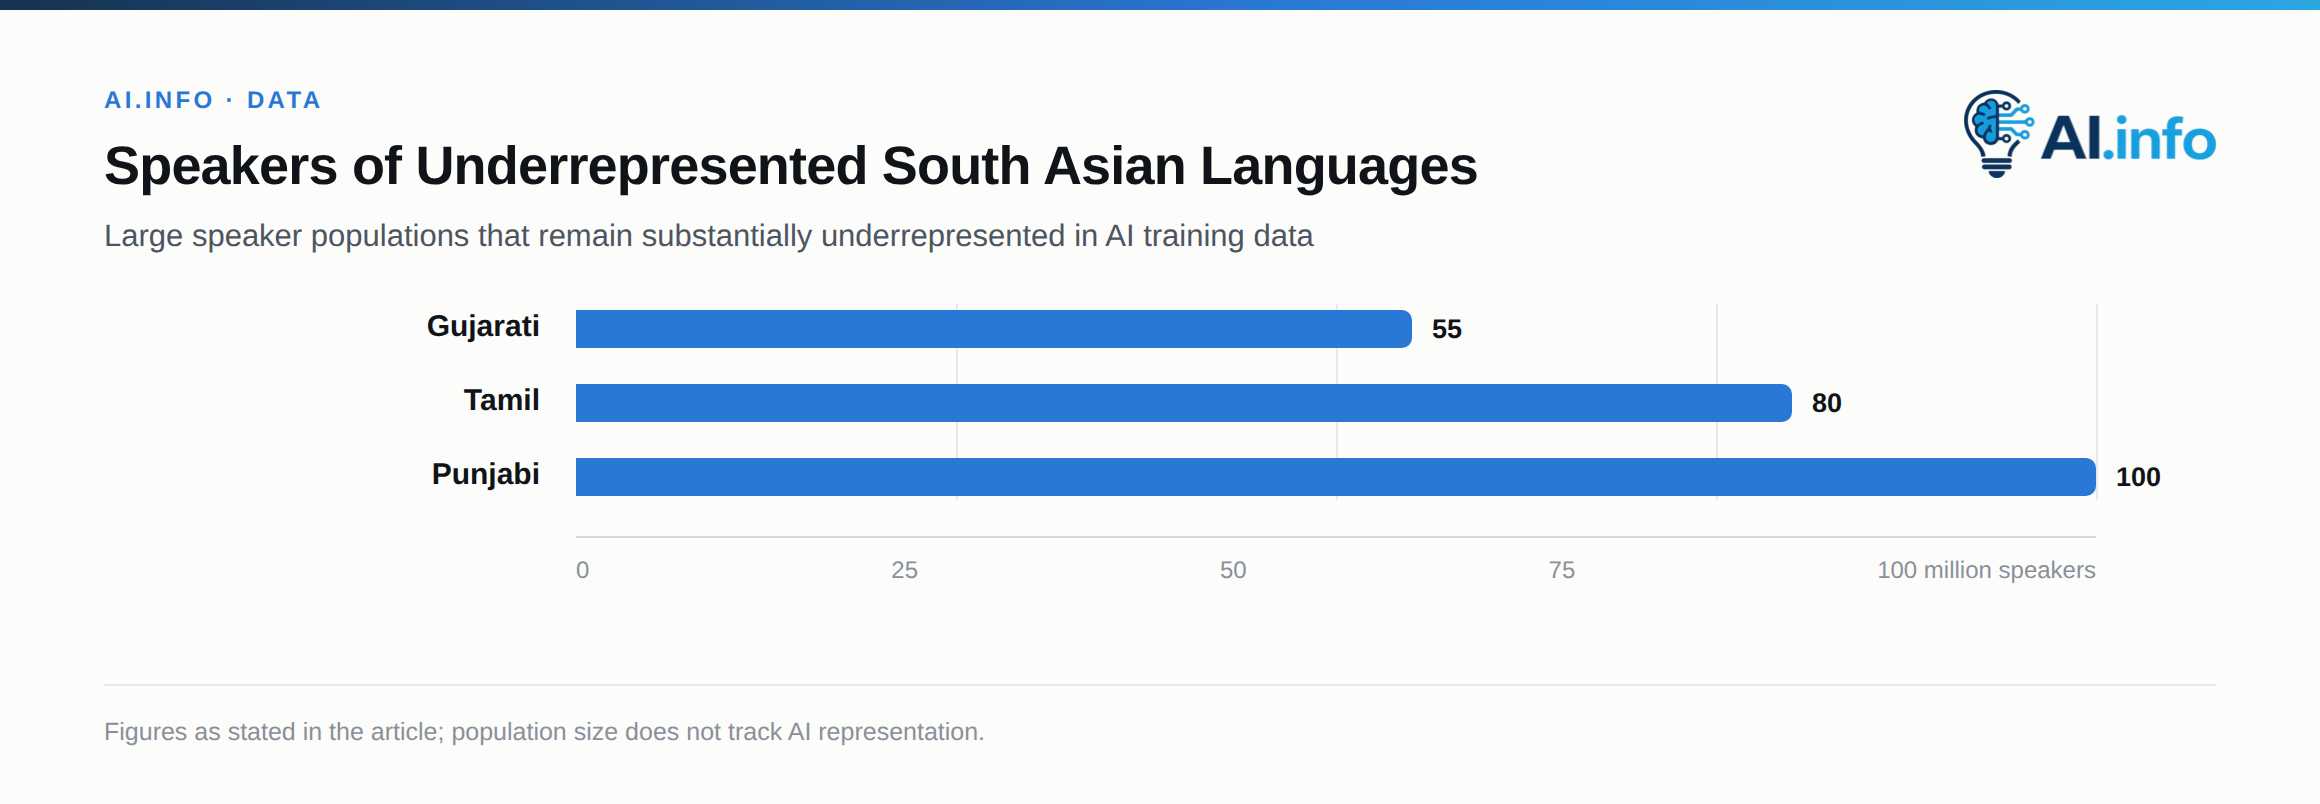
Nell’Asia meridionale e sudorientale, il quadro è variegato ma preoccupante. Lingue come il tamil (80 milioni di parlanti), il gujarati (55 milioni) e il punjabi (100 milioni) sono nettamente sottorappresentate rispetto al numero di persone che le parlano. Il rapporto del 2025 della AIEP Initiative sui servizi di consulenza basati sull’IA per i piccoli agricoltori — applicazioni dal potenziale impatto trasformativo nel mondo reale — annovera la copertura linguistica tra i limiti che frenano questi sistemi: il riconoscimento vocale e la traduzione automatica per lingue con poche risorse, insieme ai sistemi di scrittura non standard, compromettono la qualità dall’inizio alla fine.
L’effetto non è neutro. Le popolazioni le cui lingue sono ben rappresentate nei dati di addestramento dell’IA hanno accesso a strumenti potenti per la produttività, l’istruzione, le informazioni sanitarie, i servizi finanziari e i rapporti con la pubblica amministrazione. Le popolazioni le cui lingue sono assenti ne restano escluse — non per una discriminazione attiva, ma per la disuguaglianza prodotta dalle decisioni sull’allocazione delle risorse prese da un piccolo numero di aziende tecnologiche prevalentemente anglofone.
Masakhane: il movimento africano per l’elaborazione del linguaggio naturale
La più importante risposta nata dal basso a questa esclusione è arrivata dalla comunità africana di ricerca sull’IA. Masakhane — un nome che in zulu significa «costruiamo insieme» — è stata fondata nel 2019 da Jade Abbott e Laura Martinus ed è cresciuta grazie a Salomey Osei e a una rete di ricercatori e professionisti africani della tecnologia, stanchi di aspettare che le aziende tecnologiche globali includessero le lingue africane nei loro sistemi.
Masakhane segue un modello insolito nell’apprendimento automatico: prima ancora di essere un gruppo di ricerca tecnica, è fondamentalmente un’organizzazione che costruisce una comunità. Parte dal presupposto che non si possano realizzare sistemi di elaborazione del linguaggio naturale di alta qualità per le lingue africane senza la partecipazione attiva di persone madrelingua e ricercatori locali che ne comprendano il contesto linguistico e culturale. I ricercatori stranieri, per quanto animati dalle migliori intenzioni, commetteranno errori sistematici nella raccolta dei dati, nell’annotazione e nella valutazione se non conoscono a fondo le comunità alle cui lingue lavorano.
I risultati concreti sono stati notevoli. Masakhane ha prodotto dataset di benchmark per decine di lingue africane, tra cui il benchmark di traduzione automatica MAFAND-MT (21 lingue africane) e il benchmark per il riconoscimento delle entità nominate MasakhaNER (10 lingue africane). Questi dataset hanno reso possibile un’ondata di ricerche sull’elaborazione del linguaggio naturale per le lingue africane, dimostrando che è possibile costruire modelli di alta qualità per lingue che l’industria globale dell’IA aveva fino ad allora ignorato.
| Risorsa di Masakhane | Tipo | Lingue coperte |
|---|---|---|
| MAFAND-MT | Benchmark di traduzione automatica | 21 lingue africane |
| MasakhaNER | Benchmark per il riconoscimento delle entità nominate | 10 lingue africane |
| AfriBERTa | Modello multilingue preaddestrato | 11 lingue africane |
L’organizzazione ha anche prodotto modelli addestrati — in particolare AfriBERTa, un modello multilingue sul modello di BERT preaddestrato su 11 lingue africane, e modelli specifici per lo yoruba, lo swahili, l’amarico e altre lingue — che superano modelli multilingue come mBERT e BLOOM nei benchmark per le lingue africane, pur essendo stati addestrati con una frazione delle risorse di calcolo.
L’approccio di Masakhane dimostra una cosa importante: la raccolta di dati e lo sviluppo di modelli guidati dalle comunità e radicati nei loro contesti culturali possono produrre risultati che iniziative centralizzate su larga scala, pur dotate di risorse enormi, non sono riuscite a ottenere. L’ostacolo principale non è tecnico, e nemmeno finanziario: è la mancanza di ricercatori con le conoscenze linguistiche e culturali necessarie per svolgere correttamente il lavoro.
Te Hiku Media e la rivoluzione della sovranità dei dati maori
Se Masakhane rappresenta l’approccio collettivo e comunitario all’IA per le lingue, l’iniziativa Te Hiku Media in Nuova Zelanda rappresenta qualcosa di altrettanto importante: un modello di sovranità dei dati indigeni che mette in discussione l’idea secondo cui i dati usati per addestrare l’IA siano un bene comune, liberamente disponibile a chiunque voglia utilizzarli.
Te Hiku Media è un’organizzazione mediatica di proprietà maori che dal 2018 sviluppa strumenti di IA per la lingua maori (Te Reo Maori), in particolare un sistema di riconoscimento vocale chiamato Papa Reo (che significa «nido della lingua»). Il sistema è stato realizzato grazie ad anni di raccolta di dati nelle comunità — conversazioni registrate, interviste e tradizioni orali donate da parlanti maori — ed è stato addestrato a riconoscere i diversi dialetti regionali e modi di parlare di una lingua repressa per generazioni dalle politiche educative coloniali.
A distinguere l’approccio di Te Hiku Media non è soltanto il risultato tecnico, ma anche il modello di governance che lo accompagna. I dati usati per addestrare Papa Reo non sono disponibili al pubblico. Sono di proprietà di Te Hiku Media e concessi in licenza all’organizzazione secondo accordi negoziati con le comunità maori di cui rappresentano la parlata. A grandi aziende tecnologiche, tra cui Google e Microsoft, è stato negato l’accesso ai dati perché il patrimonio linguistico delle comunità non può essere sfruttato commercialmente senza il loro consenso e senza una condivisione dei benefici.
Questa posizione — secondo cui le comunità hanno diritti sovrani sui dati linguistici che rappresentano il loro patrimonio culturale — è espressa nei CARE Principles for Indigenous Data Governance (beneficio collettivo, autorità di controllo, responsabilità, etica) e nell’Indigenized AI Manifesto, elaborato alla conferenza LT4All nel 2025. Questi modelli sostengono che le comunità indigene dovrebbero avere:
- La custodia dei dati raccolti presso le loro comunità o che le riguardano
- Il diritto di veto sugli usi di quei dati che ritengono dannosi o basati sullo sfruttamento
- Una condivisione dei benefici quando i loro dati vengono usati per creare valore commerciale
- Un sostegno allo sviluppo delle competenze necessarie a sviluppare capacità nel campo dell’IA all’interno delle loro comunità, non soltanto per le loro comunità
Le implicazioni per il settore dell’IA sono significative. Se il principio della sovranità dei dati fosse adottato su larga scala — come sta accadendo attraverso i nuovi modelli di governance dei dati indigeni in Canada, Australia, Nuova Zelanda e in alcune parti delle Americhe — cambierebbe radicalmente l’economia e l’etica dell’addestramento dei sistemi di IA multilingue. La raccolta dei dati dovrebbe essere partecipativa, consensuale e governata dalle comunità interessate, anziché essere condotta in modo estrattivo da grandi aziende che immettono i dati in modelli dai quali le comunità d’origine non traggono alcun beneficio.
BharatGen in India: sovranità nazionale attraverso modelli aperti
Mentre Masakhane e Te Hiku Media rappresentano approcci dal basso e comunitari, BharatGen rappresenta un terzo modello: la sovranità nazionale nell’IA attraverso investimenti statali in modelli open source multilingue.
Avviato nel 2024 dal Ministero della Scienza e della Tecnologia e guidato dall’IIT Bombay nell’ambito della National Mission on Interdisciplinary Cyber-Physical Systems del Dipartimento della Scienza e della Tecnologia, BharatGen punta a sviluppare modelli di base per tutte le 22 lingue ufficiali dell’India — dall’hindi (600 milioni di parlanti) al manipuri (1,8 milioni) — liberamente disponibili per ricercatori, imprese e servizi pubblici indiani.
Da allora si è spinto ben oltre il testo. BharatGen dichiara di aver ricevuto finanziamenti per ₹988,6 crore nell’ambito della IndiaAI Mission e ora annovera modelli testuali multilingue per oltre 22 lingue indiane, sistemi di riconoscimento vocale e una linea di sistemi di sintesi vocale chiamata Sooktam, oltre a modelli di visione per la comprensione di immagini e documenti. Tra le sue applicazioni già in uso figurano Krishi Sathi per l’agricoltura, e-VikrAI per il commercio e DocBodh per i documenti, sviluppate con IIT Bombay, IIT Kharagpur e Larsen & Toubro.
La motivazione è esplicitamente legata alla sovranità: l’India non vuole che le interazioni dei suoi cittadini con i servizi pubblici, i sistemi sanitari e le istituzioni finanziarie tramite l’IA passino attraverso modelli stranieri addestrati principalmente sull’inglese e su contenuti culturali occidentali. Un agricoltore dell’Odisha in cerca di consigli sulle colture, un dipendente pubblico del Tamil Nadu che usa l’IA per elaborare documenti, un paziente che riceve informazioni sanitarie in una clinica rurale del Gujarat: tutti dovrebbero poter accedere a sistemi di IA che funzionino in modo affidabile nella loro lingua e siano addestrati su dati che rispecchiano il contesto culturale e istituzionale indiano.
BharatGen si fonda su iniziative precedenti, tra cui il modello multilingue IndicBERT di AI4Bharat, il collettivo di ricerca dell’IIT Madras che ha prodotto la più completa raccolta di risorse per l’elaborazione del linguaggio naturale nelle lingue indiane disponibile finora. La combinazione di finanziamenti statali, infrastrutture di ricerca accademiche e una politica di rilascio open source rappresenta un modello che diverse altre nazioni multilingue — tra cui Brasile (portoghese e lingue indigene), Indonesia (Bahasa Indonesia e lingue regionali) e Nigeria (hausa, yoruba, igbo e altre lingue) — seguono con attenzione.
Approcci tecnici: che cosa funziona davvero
Al di là delle singole iniziative istituzionali, la comunità scientifica ha maturato un quadro più chiaro degli approcci tecnici più efficaci per sviluppare un’IA linguistica di alta qualità in contesti con scarse risorse.
Il transfer learning interlinguistico — addestrare un modello su una lingua e adattarlo a una lingua affine usando piccole quantità di dati nella lingua di destinazione — funziona bene per le famiglie linguistiche con sufficienti somiglianze strutturali. I modelli addestrati su spagnolo e portoghese si adattano bene ad altre lingue romanze; quelli addestrati sullo swahili si adattano a lingue bantu affini. Ma l’efficacia del metodo cala rapidamente per le lingue di famiglie diverse, e la maggior parte delle lingue più a rischio di estinzione nel mondo ha poche lingue strettamente affini che dispongano di abbondanti risorse.
Il pre-addestramento massicciamente multilingue — l’approccio di modelli come mBERT, XLM-R e BLOOM, addestrati simultaneamente su decine o centinaia di lingue — offre una base per molte lingue, ma spesso manifesta la maledizione del multilinguismo: aggiungere lingue peggiora le prestazioni su ciascuna di esse, perché la capacità del modello viene distribuita tra un numero maggiore di lingue. Il modello multilingue ottimale per una specifica lingua con scarse risorse è spesso un modello molto più piccolo, addestrato appositamente su quella lingua e sulle sue parenti strette, non un grande modello addestrato su tutto contemporaneamente.
La raccolta di dati da parte delle comunità — l’approccio di Masakhane, che coinvolge i parlanti madrelingua nella creazione e nell’annotazione dei dati — supera sistematicamente la raccolta automatizzata dei dati (che estrae dal web qualsiasi testo nella lingua di destinazione) per qualità dei dati, adeguatezza degli ambiti coperti e rappresentazione dei dialetti. Il costo per unità di dati è più alto, ma la qualità dei modelli ottenuti è nettamente migliore.
L’IA incentrata sul parlato merita particolare attenzione per le lingue che storicamente sono state orali anziché scritte. Per molte lingue indigene — e per molti parlanti, anche di lingue relativamente ben dotate di risorse, con competenze limitate nella lettura e nella scrittura — il parlato è la modalità naturale. Sviluppare sistemi di riconoscimento e sintesi vocale, anziché modelli linguistici basati sul testo, potrebbe essere l’applicazione dell’IA più importante sul piano pratico per queste comunità.
È anche l’ambito in cui si è verificata la più grande iniziativa singola degli ultimi anni, proveniente proprio dal tipo di azienda che questo saggio critica. Il 10 novembre 2025 Meta ha pubblicato Omnilingual ASR, una famiglia di modelli di riconoscimento vocale che copre più di 1.600 lingue, 500 delle quali, secondo l’azienda, non erano mai state trascritte prima dall’IA. I modelli vanno da 300 milioni a 7 miliardi di parametri, sono distribuiti con licenza Apache 2.0 e, secondo Meta, il sistema 7B-LLM-ASR registra tassi di errore sui caratteri inferiori a 10 per il 78% delle lingue coperte.
Due dettagli contano più del numero di lingue annunciato. La pubblicazione comprende l’Omnilingual ASR Corpus, parlato trascritto in 350 lingue scarsamente servite, distribuito con licenza CC-BY, che Meta descrive come il più grande dataset di parlato spontaneo per lingue con risorse estremamente scarse reso disponibile. E il sistema può essere esteso a una lingua mai incontrata prima partendo da una manciata di esempi audio-testo abbinati, senza eseguire un addestramento, senza competenze specialistiche e senza accesso a grandi risorse di calcolo: aggiungere una lingua diventa così alla portata di chi la parla, e non soltanto dell’azienda che ha distribuito il modello.
Nulla di tutto questo chiude il dibattito. Un modello di trascrizione non è un modello linguistico: non risponde alla domanda di un agricoltore né redige un contratto, e coprire 1.600 lingue non equivale a offrire qualità in ognuna di esse. Ma indebolisce l’affermazione secondo cui è l’ostacolo tecnico a tenere esclusa la maggior parte delle lingue. Quando una grande azienda ha deciso di investire nel problema, la copertura è arrivata con una sola pubblicazione.
Il problema strutturale: chi decide quali lingue contano?
Dietro tutte le specifiche difficoltà tecniche e istituzionali c’è un problema strutturale che le sole soluzioni tecniche non possono affrontare: le decisioni su quali lingue ricevono investimenti nell’IA sono prese in larghissima parte da un numero ristretto di grandi aziende tecnologiche, i cui incentivi commerciali orientano naturalmente l’attenzione verso mercati ricchi di risorse linguistiche ed economicamente redditizi.
La logica economica non è difficile da capire. Un modello linguistico che funziona per inglese, spagnolo, francese, mandarino, hindi, arabo e poche altre grandi lingue copre i mercati in cui le aziende tecnologiche generano la stragrande maggioranza dei loro ricavi. Il ritorno commerciale marginale dell’aggiunta di una lingua con pochi milioni di parlanti è modesto, soprattutto quando questi vivono prevalentemente in mercati a reddito più basso. L’investimento necessario per ottenere buoni risultati in quella lingua — ricercatori madrelingua, linguisti, annotatori, valutatori della qualità — non è trascurabile. Per la maggior parte delle lingue del mondo, i conti semplicemente non tornano.
Niente di tutto questo è esclusivo dell’IA. La logica economica delle tecnologie linguistiche — dizionari, correttori ortografici, traduzione automatica, riconoscimento vocale — ha sempre favorito le lingue maggioritarie. L’IA sta accelerando e amplificando questa dinamica, non la sta creando.
A essere diversi, nel caso dell’IA, sono la portata e l’ampiezza dell’impatto. Quando le tecnologie linguistiche si limitavano ai correttori ortografici e alla traduzione automatica di base, l’esclusione dei parlanti di lingue minoritarie era un inconveniente. Quando l’IA comincia a mediare l’accesso alle informazioni sanitarie, ai contenuti educativi, ai servizi pubblici, agli strumenti finanziari, all’assistenza legale e alle opportunità economiche, l’esclusione diventa una questione fondamentale di equità e di diritti umani.
Una strada da seguire: che cosa sarebbe davvero utile
Diversi interventi concreti potrebbero cambiare sensibilmente la traiettoria.
Primo, accesso alla capacità di calcolo: i costi della capacità di calcolo nel cloud rappresentano un ostacolo significativo per chi fa ricerca nelle comunità linguistiche con risorse limitate. Programmi che offrano accesso gratuito o sovvenzionato alla capacità di calcolo a chi studia le lingue in pericolo e minoritarie — sul modello di Google’s TPU Research Cloud, ma con un obiettivo specifico — affronterebbero direttamente un vincolo determinante.
Secondo, infrastruttura dei dati: dataset completi, ben documentati e distribuiti con licenze aperte per un ventaglio molto più ampio di lingue abbatterebbero drasticamente le barriere alla creazione di nuovi modelli. I dataset basati su CommonCrawl che alimentano i modelli per la lingua inglese non sono disponibili per la maggior parte delle lingue minoritarie; iniziative mirate di raccolta dei dati, con un’adeguata governance da parte delle comunità, potrebbero cambiare le cose. Meta’s Omnilingual ASR Corpus, che comprende 350 lingue poco servite ed è stato rilasciato con licenza CC-BY, risponde in parte proprio a questa esigenza — per una sola modalità, e soltanto quella.
Terzo, sviluppo delle competenze nelle comunità: la strada più sostenibile perché una comunità disponga di strumenti di IA nella propria lingua è formare al suo interno ricercatori e professionisti dell’IA. I programmi che finanziano studi post-laurea, soggiorni di ricerca e laboratori comunitari di IA in regioni con molte lingue poco servite sono investimenti in un percorso che richiede decenni, non soluzioni rapide.
Quarto, quadri di riferimento per la sovranità dei dati: adottare i CARE Principles e quadri analoghi per la governance dei dati dei popoli indigeni creerebbe una base di fiducia che renderebbe sostenibile il contributo di dati da parte delle comunità. Le comunità che sanno che i loro dati saranno usati secondo modalità da loro controllate sono più propense a contribuire; quelle che hanno visto i propri dati prelevati senza consenso né benefici sono — comprensibilmente — riluttanti.
Quinto, valutazione e responsabilità: il settore dell’IA non dispone di meccanismi solidi per misurare e rendere note le prestazioni dei suoi sistemi nelle diverse lingue. Rendere obbligatori i benchmark e la pubblicazione dei dati sulla copertura linguistica, accanto alle metriche di prestazione già pubblicate per le lingue con ampie risorse, introdurrebbe una forma di responsabilità dove oggi non esiste.
Che cosa c’è in gioco
Le lingue lasciate indietro non sono uno sfortunato effetto collaterale dei progressi dell’IA. Sono il segno di una scelta — non compiuta consapevolmente da un singolo soggetto, ma risultante da migliaia di piccole decisioni sull’allocazione delle risorse — su quali conoscenze, culture e modi di comunicare con il mondo valgano la pena di essere preservati e serviti.
Delle circa 7.000 lingue vive oggi, i linguisti stimano che la metà sarà estinta entro la fine di questo secolo, sostituita perlopiù dall’inglese, dal cinese mandarino, dallo spagnolo o dalle lingue maggioritarie regionali. La scomparsa di una lingua non è soltanto la perdita di un sistema di comunicazione. È la perdita di un’intera struttura cognitiva: un modo unico di classificare l’esperienza, codificare le conoscenze, esprimere l’identità e trasmettere la cultura da una generazione all’altra.
Un’IA che funziona soltanto in un ristretto numero di lingue maggioritarie accelera questa estinzione. Le comunità la cui partecipazione economica e sociale richiede sempre più spesso di usare sistemi mediati dall’IA hanno un forte incentivo a passare alle lingue supportate da quei sistemi, abbandonando quelle dei propri nonni.
Viceversa, un’IA che funziona bene in lingue diverse potrebbe diventare uno strumento di conservazione e rivitalizzazione linguistica, come Papa Reo sta già dimostrando per il Te Reo Maori. Su questo punto la tecnologia è neutrale. Le scelte di chi finanzia e costruisce i sistemi di IA non lo sono.