Etica e governance
Responsabilità algoritmica: chi risponde quando l’IA sbaglia?
Quando i sistemi di IA commettono errori che danneggiano le persone, chi ne risponde? Un’analisi dei regimi di responsabilità civile, della responsabilità delle aziende e delle norme giuridiche emergenti in materia di responsabilità dell’IA
Gabriele Masetti ·
La scusa che avrebbe dovuto sparire dieci anni fa
«La decisione l’ha presa l’algoritmo» non è una spiegazione. È un modo per occultare le responsabilità. Prende una scelta compiuta dall’azienda che ha costruito un sistema, dall’ente pubblico che lo ha acquistato e dai dirigenti che lo hanno adottato senza test adeguati, e sposta la colpa su un software che non può essere citato in giudizio, licenziato o mandato in prigione.
Dieci anni di errori documentati — nella giustizia penale, nella gestione delle prestazioni sociali, nelle assunzioni, nella sanità e nelle attività di polizia — mostrano esattamente dove si colloca la responsabilità: presso le istituzioni che hanno costruito, acquistato e adottato questi sistemi senza le garanzie che sapevano, o avrebbero dovuto sapere, essere necessarie. Le prove non consentono più di trattare i danni causati dagli algoritmi come eventi di cui nessuno ha colpa e la responsabilità è indistinta. Consentono di attribuirla come facciamo in ogni altro caso in cui le istituzioni umane causano danni: a chi aveva il controllo e a chi ne ha tratto profitto.
Il caso da cui partire: COMPAS e la dispersione delle responsabilità
Nel maggio 2016, i giornalisti di ProPublica Julia Angwin, Jeff Larson, Surya Mattu e Lauren Kirchner pubblicarono «Machine Bias», un’inchiesta su COMPAS, lo strumento di Northpointe per valutare il rischio di recidiva, usato dai tribunali di tutti gli Stati Uniti per contribuire alle decisioni sulla libertà su cauzione e sulla pena. La loro analisi di oltre 7.000 imputati nella contea di Broward, in Florida, rilevò che agli imputati neri che non avevano poi commesso nuovi reati veniva attribuito un rischio elevato con una frequenza quasi doppia rispetto agli imputati bianchi che non avevano commesso nuovi reati: un tasso di falsi positivi 1,9 volte superiore.
Northpointe contestò l’impostazione dell’analisi, sostenendo che lo strumento avesse lo stesso valore predittivo per tutti i gruppi razziali e che ProPublica avesse scelto la misura di equità sbagliata. Quel dibattito accademico — tra separazione e sufficienza, nella letteratura tecnica — era reale e irrisolto. Ma oscurava un fatto più semplice: uno strumento proprietario influenzava le decisioni sulla libertà delle persone nei tribunali di tutto il paese, e né gli imputati né, spesso, i giudici potevano esaminarne il funzionamento.
Northpointe considerava la formula per calcolare i punteggi un segreto commerciale. I tribunali ritenevano i risultati abbastanza autorevoli da agire sulla loro base. Alla domanda «chi risponde di questo punteggio?», la risposta sincera era: nessuno, per come era stato concepito il sistema.
| Caso | Entità del danno | Esito |
|---|---|---|
| COMPAS (ProPublica, 2016) | Tasso di falsi positivi 1,9 volte superiore (oltre 7.000 imputati analizzati) | Metodologia contestata |
| Prestazioni per l’infanzia nei Paesi Bassi (2005–2019) | 26.000–35.000 famiglie accusate ingiustamente | Governo dimessosi nel gennaio 2021 |
| MiDAS, Michigan (2013–2015) | Circa 40.000 persone accusate ingiustamente, tasso di errore fino al 93% | Accordo da 20 milioni di dollari (2022), circa 3.000 persone interessate |
Questo schema progettuale — ponderazioni proprietarie, dati in ingresso opachi, affidamento da parte delle istituzioni — è il filo conduttore di tutti i casi che seguono. La tecnologia cambia; il vuoto di responsabilità no.
I Paesi Bassi mostrano cosa accade quando uno Stato si nasconde dietro quel vuoto
Il caso più chiaro a favore dell’attribuzione della responsabilità alle istituzioni anziché all’«algoritmo» è lo scandalo olandese delle prestazioni per l’infanzia, o toeslagenaffaire. Dal 2013, l’autorità fiscale olandese, la Belastingdienst, ha usato un algoritmo di classificazione del rischio ad autoapprendimento per individuare possibili frodi nelle domande di prestazioni per l’infanzia. Il sistema considerava l’assenza della cittadinanza olandese un fattore di rischio, incorporando di fatto la profilazione etnica in una funzione ufficiale dello Stato.
Almeno 26.000 genitori — secondo alcune stime fino a 35.000 — furono ingiustamente bollati come truffatori e obbligati a restituire integralmente le prestazioni, spesso decine di migliaia di euro, senza una reale possibilità di ricorso. Alcune famiglie persero la casa, altre finirono in bancarotta e in oltre 1.600 casi i servizi di tutela dei minori allontanarono i figli. Lo scandalo fece cadere il governo: il terzo governo del primo ministro Mark Rutte si dimise il 15 gennaio 2021, due mesi prima delle elezioni generali.
È un caso esemplare perché la catena delle responsabilità non è poi così complicata, una volta respinta la scusa dell’algoritmo. Un ente pubblico scelse quali variabili fornire a un modello. Scelse di considerare i risultati del modello una base per provvedimenti di recupero aggressivi e irreversibili. Impiegò revisori umani per valutare le domande rispetto ai requisiti di legge e, quando gli addetti ai casi segnalavano problemi, l’inerzia istituzionale del sistema prevaleva sulle loro segnalazioni.
Non esisteva una funzione di verifica indipendente che individuasse le variabili sostitutive discriminatorie prima che decine di migliaia di famiglie subissero danni. Ognuna di quelle scelte fu compiuta da persone identificabili all’interno di un’istituzione identificabile. Non fu l’algoritmo a far dimettere il governo; fu la decisione del governo di adottare un sistema non sottoposto a verifiche, etnicamente discriminatorio e privo di possibilità di ricorso.
Nel settore privato vale la stessa logica — Amazon e Optum
Chi contesta l’attribuzione di una responsabilità rigorosa sostiene talvolta che alle aziende private vada lasciato più margine, perché la disciplina del mercato correggerebbe i loro errori più rapidamente della burocrazia pubblica. Due dei casi più citati nel settore privato smentiscono questa tesi.
Dal 2014 al 2017 Amazon sviluppò uno strumento interno per le assunzioni che assegnava ai curriculum dei candidati un punteggio da una a cinque stelle. Nell’ottobre 2018 Reuters riferì che Amazon aveva abbandonato il progetto dopo aver scoperto che il sistema aveva imparato da solo a penalizzare i curriculum contenenti la parola «femminile» — per esempio in «capitana del club di scacchi femminile» — e a declassare le laureate di due college riservati alle donne. Era stato addestrato su dieci anni di curriculum inviati a un’azienda in cui le assunzioni per ruoli tecnici erano in larga prevalenza maschili.
Gli ingegneri di Amazon cercarono di correggere i termini specifici che il modello aveva imparato a penalizzare, poi abbandonarono il progetto perché non potevano essere certi che il sistema non avrebbe trovato altri indicatori indiretti del genere, più sottili. Si tratta, in effetti, di un esito ragionevolmente responsabile: l’azienda individuò il problema al proprio interno, quando i selezionatori si limitavano ancora a consultare le raccomandazioni dello strumento senza mai affidarsi soltanto a quelle, e lo accantonò anziché metterlo in uso.
Il caso è istruttivo proprio perché mostra l’alternativa a una mancata assunzione di responsabilità: verifiche interne e disponibilità a rinunciare a una linea di prodotti. Il confronto con la persistente difesa di COMPAS da parte di Northpointe o con gli anni di smentite del Belastingdienst mostra che la differenza sta interamente nella volontà delle istituzioni, non in un’inevitabilità tecnica.
Il caso Optum, descritto da Ziad Obermeyer e coautori su Science nell’ottobre 2019, pone un problema più difficile: la discriminazione non dipendeva da un indicatore indiretto evidente come «club di scacchi femminile», ma da una scelta strutturale sottile, nascosta nella progettazione del modello. Un algoritmo di previsione del rischio, usato negli ospedali statunitensi per individuare i pazienti da inserire nei programmi di gestione delle cure per i soggetti ad alto rischio, usava la spesa sanitaria precedente come indicatore indiretto del bisogno di cure.
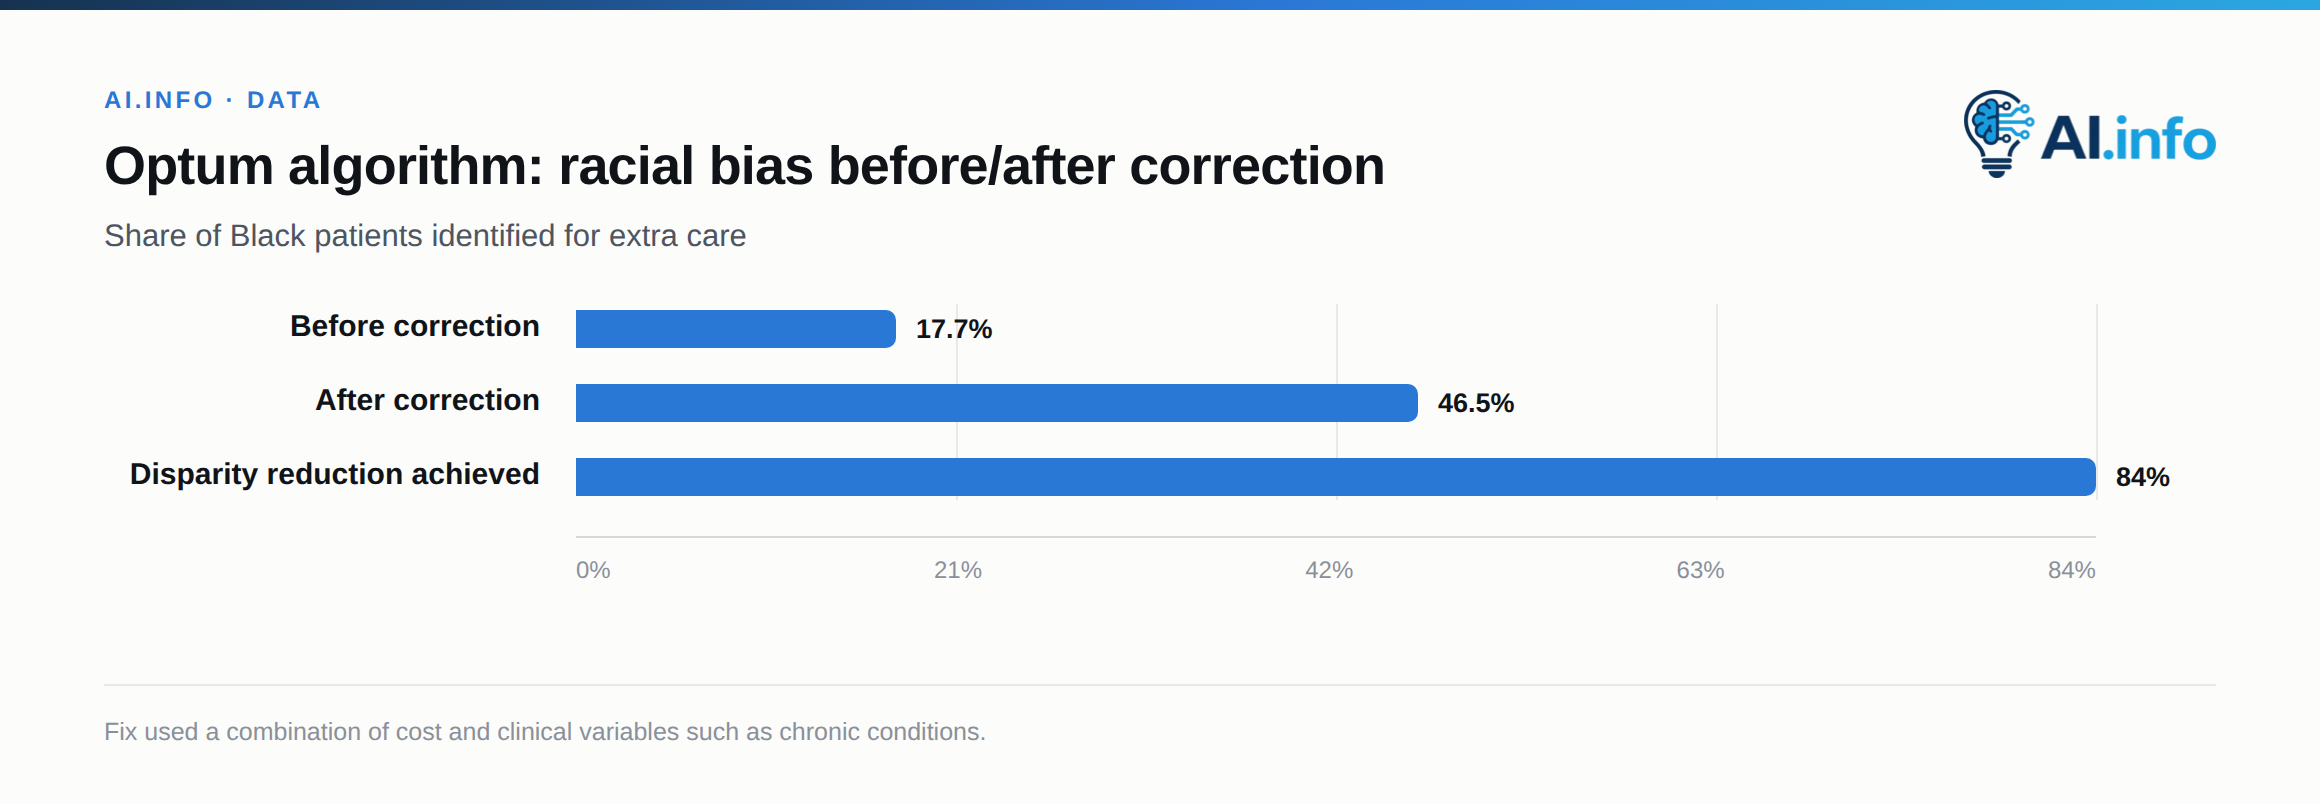
Poiché, in media, per curare pazienti neri con lo stesso livello di malattia sottostante dei pazienti bianchi si spende meno — per effetto di un accesso diseguale alle cure, non di bisogni diversi — l’algoritmo attribuiva sistematicamente ai pazienti neri uno stato di salute migliore rispetto a quello di pazienti bianchi altrettanto malati. Secondo la stima dei ricercatori, questo errore nell’indicatore indiretto riduceva di oltre la metà il numero di pazienti neri individuati per ricevere cure aggiuntive: correggerlo avrebbe portato la quota di pazienti neri segnalati per un’assistenza supplementare dal 17,7 per cento al 46,5 per cento.
Riaddestrare il modello su una combinazione di costi e variabili cliniche, come le patologie croniche, ha ridotto la disparità razziale dell’84 per cento. La soluzione non era né insolita né costosa. Prima dell’intervento del gruppo di Obermeyer, mancava un obbligo istituzionale di verificare gli esiti dello strumento in base alla razza, prima o durante il suo impiego. Gli ospedali e gli assicuratori che lo usavano avevano accettato una scelta progettuale del fornitore — usare il costo come indicatore indiretto del bisogno — senza verificare in modo indipendente se fosse sicura. È un fallimento della governance, non della matematica.
Quando il falso positivo è una persona in manette
Il riconoscimento facciale trasforma lo stesso fallimento della governance in un danno fisico. Lo studio «Gender Shades» di Joy Buolamwini e Timnit Gebru, pubblicato nel 2018, ha esaminato i sistemi commerciali di classificazione del genere di IBM, Microsoft e Face++ e ha rilevato tassi di errore inferiori all’1 per cento per gli uomini dalla pelle più chiara, ma fino al 34,7 per cento per le donne dalla pelle più scura: un divario di oltre 40 volte, nascosto in strumenti presentati come accurati per un’ampia varietà di persone. Quel solo dato ha cambiato il modo in cui le autorità di regolamentazione e il pubblico comprendevano i rischi del riconoscimento facciale: i dati di accuratezza complessiva nascondevano un sistema che funzionava molto peggio proprio per la popolazione più esposta a un’attività di polizia sproporzionata.
Le conseguenze dell’aver ignorato quel risultato si manifestarono due anni dopo. Nel gennaio 2020 la polizia di Detroit arrestò ingiustamente Robert Williams davanti alla moglie e alle figlie, dopo che una ricerca con riconoscimento facciale aveva associato un’immagine sfocata di videosorveglianza relativa a un taccheggio alla foto sulla sua patente scaduta. Williams trascorse circa trenta ore in custodia per un reato con cui non aveva alcun legame.
Fu il primo caso confermato pubblicamente in cui una falsa corrispondenza del riconoscimento facciale portò a un arresto ingiusto. La successiva causa intentata dall’ACLU sfociò, nel 2024, in uno storico accordo che vieta al Dipartimento di polizia di Detroit di arrestare chiunque sulla sola base di un risultato del riconoscimento facciale o di una ricognizione fotografica effettuata subito dopo tale risultato. L’accordo stesso è la prova più chiara disponibile che il fallimento fu procedurale, non computazionale: gli agenti trattarono una pista investigativa probabilistica come se fosse un’identificazione certa. Nulla, nella tecnologia, imponeva un uso improprio del genere. Le politiche e la formazione del dipartimento lo consentivano, e la responsabilità ricadeva quindi sul dipartimento.
Il MiDAS del Michigan: l’automazione come moltiplicatore della negligenza istituzionale
L’Integrated Data Automated System del Michigan, impiegato per individuare le frodi ai danni dell’assicurazione contro la disoccupazione, ha accusato ingiustamente di frode circa 40.000 persone tra il 2013 e il 2015. Secondo quanto riportato, il tasso di errore nelle sue valutazioni delle frodi arrivava fino al 93%. Il sistema classificava come frode discrepanze banali nei dati e imponeva ai richiedenti di rispondere entro dieci giorni, pena sanzioni quadruplicate, pignoramento dei salari e sequestro dei rimborsi fiscali. Prima di queste misure punitive non c’era, di fatto, alcuna verifica umana.
Nel 2022 il Michigan ha infine raggiunto un accordo da 20 milioni di dollari nella causa Bauserman v. Unemployment Insurance Agency, che riguardava circa 3.000 persone accusate ingiustamente. MiDAS è l’espressione più nitida del problema della responsabilità: un’agenzia statale ha automatizzato un procedimento punitivo, eliminato il controllo umano che avrebbe individuato segnalazioni di frode palesemente errate e lasciato funzionare il sistema senza verifiche per due anni, durante i quali ha pignorato i salari di decine di migliaia di persone che non avevano fatto nulla di male.
La tecnologia non era sofisticata. Il problema era che nessuno nella catena di comando è stato chiamato a rispondere di ciò che il sistema faceva finché, sette anni dopo, un’azione collettiva non ha imposto la questione.
A chi spetta davvero la responsabilità
A un esame attento, tutti i casi descritti sopra presentano lo stesso schema: un’istituzione ha scelto di adottare un sistema, ha scelto di non sottoporlo a verifiche adeguate per la popolazione su cui avrebbe inciso e ha scelto di considerare i suoi risultati abbastanza autorevoli da giustificare azioni punitive o capaci di cambiare una vita: un arresto, una riscossione di debiti legata alla deportazione, il recupero di prestazioni erogate, il diniego di cure mediche, l’esclusione da un lavoro.
In ognuno di questi casi, al momento dell’adozione erano possibili esiti sensibilmente migliori: gli stessi ingegneri di Amazon avevano individuato internamente la distorsione del sistema; la soluzione di Obermeyer costava poco e funzionava; la politica adottata in seguito dalla stessa Detroit mostra che le corrispondenze del riconoscimento facciale potevano essere usate come piste investigative, non come prove. Il danno non era inevitabile. È stato il prodotto della scelta delle istituzioni di privilegiare la rapidità, il risparmio o l’apparenza di obiettività rispetto alla verifica.
Il quadro delle responsabilità che emerge da questi elementi non è complicato, anche se attuarlo è politicamente difficile. Primo, la responsabilità deve ricadere sull’istituzione che adotta il sistema, non soltanto sul fornitore: l’ospedale che ha acquistato lo strumento di Optum, la Belastingdienst, il Detroit Police Department, non solo gli ingegneri che hanno scritto il codice e certamente non il software stesso.
Secondo, ai fornitori non dovrebbe essere consentito invocare la tutela del segreto commerciale per impedire verifiche indipendenti dei sistemi usati nei tribunali, nelle decisioni sulle prestazioni, nelle assunzioni o nelle attività di polizia. La possibilità per Northpointe di non rivelare il proprio metodo di attribuzione dei punteggi proprio agli imputati che valutava è il più evidente problema strutturale nel caso COMPAS: è una scelta normativa, non una necessità tecnica.
Terzo, la presenza di un «essere umano nel processo» non basta a garantire la responsabilità se ci si aspetta sistematicamente che quella persona si rimetta al sistema. La tendenza a fidarsi dell’automazione, evidente sia nel caso MiDAS sia nell’arresto di Williams, fa sì che un revisore umano che si limiti ad avallare le decisioni offra una copertura legale senza aggiungere alcuna sicurezza effettiva. Quarto, le verifiche degli esiti disaggregate per appartenenza razziale, genere e altre caratteristiche protette dovrebbero essere una condizione preliminare all’adozione in qualsiasi ambito ad alto impatto, non una risposta avviata solo dopo che giornalisti o ricercatori accademici hanno sollevato la questione, come è accaduto con ProPublica, Buolamwini e Gebru e il gruppo di Obermeyer.
L’Europa ha introdotto per legge una versione del quarto requisito, per poi rinviarne l’applicazione. Gli obblighi di trasparenza previsti dall’articolo 50 dell’AI Act si applicano dal 2 agosto 2026, ma quelli relativi ai sistemi autonomi ad alto rischio dell’allegato III — la categoria che comprende assunzioni, prestazioni, valutazione del merito creditizio e attività di contrasto — sono stati rinviati al 2 dicembre 2027, e quelli relativi ai sistemi integrati in prodotti regolamentati al 2 agosto 2028, dopo che l’accordo omnibus ha sostituito un meccanismo di attivazione condizionato con date fisse. Gli obblighi di gestione del rischio, documentazione e supervisione umana sono rimasti intatti; sono cambiate soltanto le scadenze.
Nessuno di questi quattro requisiti è nuovo: sono molto simili alle norme sulla responsabilità professionale, sulla responsabilità per danno da prodotto e sui diritti civili già applicate ad altri sistemi decisionali ad alto impatto. L’unico ostacolo tra lo status quo e quel quadro è la persistente disponibilità a lasciare che «ha deciso l’algoritmo» funga da scudo legale e morale. Non dovrebbe essere così. Le persone che hanno costruito, acquistato e adottato questi sistemi hanno fatto delle scelte. Devono risponderne.