Approfondimenti tecnici
Modelli visione-linguaggio: come l’IA ha imparato a vedere e a parlare di ciò che vede
Dal tasso di errore del 15,3% di AlexNet su ImageNet nel 2012 all’addestramento contrastivo di CLIP su 400 milioni di coppie nel 2021: ecco come visione e linguaggio sono confluiti in un unico modello, dove questo continua ad avere allucina
AI.info Team ·
Il tasso di errore del 15,3% che mise fine alla vecchia visione artificiale
Per anni, il riconoscimento delle immagini era stato terreno di scontro tra rilevatori di caratteristiche progettati a mano — filtri per i contorni, descrittori SIFT, istogrammi dei colori — abbinati a classificatori che non riuscivano mai davvero a generalizzare. La svolta arrivò all’ImageNet Large Scale Visual Recognition Challenge del 2012, quando Alex Krizhevsky, Ilya Sutskever e Geoffrey Hinton presentarono una rete neurale convoluzionale poi chiamata AlexNet. Un insieme di sette CNN ottenne un tasso di errore top-5 del 15,3% sul set di test ImageNet da 1.000 categorie; il secondo miglior risultato, ottenuto con metodi tradizionali, si fermò al 26,2%. AlexNet aveva otto livelli — cinque convoluzionali e tre completamente connessi — e girava su due GPU GTX 580 perché la memoria di una sola scheda non bastava a contenerlo.
| Benchmark | Modello / metodo | Risultato |
|---|---|---|
| ImageNet 2012, errore top-5 | AlexNet (insieme di sette CNN) | 15,3% |
| ImageNet 2012, errore top-5 | Miglior risultato con caratteristiche progettate a mano | 26,2% |
| ImageNet, top-1 zero-shot | CLIP ViT-L/14 @ 336px | 76,2% |
| ImageNet, top-1 zero-shot | Metodi zero-shot precedenti a CLIP | 11,5% |
| ImageNet-Sketch, top-1 | CLIP | 60,2% |
| ImageNet-Sketch, top-1 | ResNet-50 (con addestramento supervisionato) | 25,2% |
| MMMU (2023) | GPT-4V | 55,7% |
| MMMU (2023) | Miglior esperto umano (set di validazione) | 88,6% |
È per quel divario di oltre dieci punti percentuali che il 2012 è considerato uno spartiacque per la visione artificiale moderna. Dimostrò che, con sufficienti dati etichettati e capacità di calcolo, una rete capace di apprendere autonomamente le caratteristiche dai pixel grezzi batteva quelle progettate a mano in decenni di lavoro. Da allora, ogni vincitore di ImageNet è stato una qualche variante di rete neurale profonda e, a metà degli anni 2010, le CNN erano diventate la scelta predefinita per qualunque compito di visione artificiale.
Le CNN addestrate in questo modo avevano però un limite strutturale: potevano riconoscere soltanto l’insieme fisso di categorie su cui erano state addestrate. Un modello addestrato sulle 1.000 classi di ImageNet poteva dirti «Labrador retriever», ma non aveva modo di descrivere una scena, rispondere a una domanda su di essa o gestire una categoria che nessuno si era preso la briga di etichettare. Nel 2019, modelli come ViLBERT stavano imparando rappresentazioni congiunte di immagini e linguaggio.
CLIP e i 400 milioni di coppie che cambiarono la domanda
Nel gennaio 2021, OpenAI pubblicò «Learning Transferable Visual Models From Natural Language Supervision», lo studio che presentò CLIP (Contrastive Language-Image Pre-training). Invece di addestrarlo su un insieme fisso di etichette, i ricercatori addestrarono congiuntamente un codificatore di immagini e uno di testo su circa 400 milioni di coppie (immagine, testo) raccolte da internet pubblico, con un obiettivo contrastivo: avvicinare le rappresentazioni vettoriali di un’immagine e della relativa didascalia, e allontanare quelle delle coppie non corrispondenti. Nessuno dovette assegnare a mano un nome di categoria a una sola di quelle 400 milioni di immagini: l’etichetta era la didascalia.
Il risultato cambiò il significato di «riconoscimento». Il miglior modello CLIP, una variante di ViT-L/14 utilizzata a una risoluzione di 336 pixel, eguagliò l’accuratezza top-1 del 76,2% di una ResNet-50 addestrata con supervisione completa su ImageNet, senza mai essere stato addestrato sulle etichette di ImageNet: nella fase di inferenza si limitava a confrontare le rappresentazioni vettoriali delle immagini con prompt testuali come «una foto di un cane». Prima di CLIP, i metodi di trasferimento zero-shot arrivavano al massimo a circa l’11,5% sullo stesso benchmark: un salto di circa 6,6 volte.
CLIP generalizzava anche dove storicamente i classificatori fallivano: raggiungeva il 60,2% su ImageNet-Sketch contro il 25,2% di una ResNet e superava il miglior modello ImageNet pubblico in 20 degli altri 26 benchmark di trasferimento esaminati. La conseguenza pratica contava più del numero in classifica: quando un codificatore di immagini e uno di testo condividono lo stesso spazio di coordinate, si dispone dell’elemento di raccordo necessario per un modello che possa guardare un’immagine e produrre una descrizione in linguaggio naturale. È il codificatore visivo di CLIP, non la famiglia ResNet, a comparire nella maggior parte dei modelli visione-linguaggio sviluppati da allora.
Dentro un VLM moderno: patch, proiettori e parole da 16x16 pixel
L’architettura che CLIP ha reso praticabile si basa sul Vision Transformer, presentato da Alexey Dosovitskiy e colleghi di Google Research nello studio dell’ottobre 2020 «An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale», poi pubblicato a ICLR 2021. ViT elimina quasi del tutto la convoluzione: suddivide un’immagine in patch di dimensioni fisse — 16x16 pixel nella configurazione di riferimento dello studio —, appiattisce ogni patch, la proietta linearmente in una rappresentazione vettoriale e passa la sequenza risultante di rappresentazioni delle patch a un codificatore transformer standard, proprio come un modello linguistico elabora una sequenza di token di parole. Dal punto di vista funzionale, l’immagine di un cane diventa una frase composta da patch di immagine anziché da parole.
È questo formato condiviso dei token a rendere possibile la costruzione dei VLM odierni. La formula ormai standard ha tre componenti: un codificatore visivo, spesso un ViT nello stile di CLIP o SigLIP, trasforma un’immagine in un insieme di rappresentazioni vettoriali delle patch; un proiettore — talvolta un singolo livello lineare, talvolta una piccola MLP o un «resampler» basato su attenzione incrociata — mappa quelle rappresentazioni nello spazio della dimensionalità attesa dal modello linguistico; infine, un LLM preaddestrato elabora i token delle immagini così proiettati, intervallati da token testuali, e genera una risposta in modo autoregressivo, come se l’immagine fosse soltanto altro testo.
LLaVA, pubblicato da Haotian Liu e coautori il 17 aprile 2023 («Visual Instruction Tuning», uno studio presentato oralmente a NeurIPS 2023), dimostrò che questa formula poteva essere realizzata a basso costo: un codificatore CLIP i cui parametri restavano fissi, un semplice proiettore lineare e Vicuna come modello linguistico, sottoposto a fine-tuning su dati di istruzioni generati da GPT-4. Ogni successivo VLM aperto — Qwen-VL, i successori dello stesso LLaVA, PaliGemma, i modelli visivi di Llama — è una variante di quella stessa struttura in tre parti; a cambiare sono soprattutto la scelta del codificatore, la progettazione del proiettore, la gestione della risoluzione e quante componenti vengano addestrate anziché mantenute fisse.
L’evoluzione: da GPT-4V a Qwen3.5
Dal 2023 in poi, i modelli proprietari e quelli aperti hanno proceduto quasi di pari passo. OpenAI ha annunciato GPT-4 with Vision nel settembre 2023 — la scheda del sistema è datata 25 settembre 2023 — dando a ChatGPT la capacità di rispondere a domande sulle immagini caricate; l’accesso tramite API è seguito il 6 novembre 2023. Il team Qwen di Alibaba aveva pubblicato Qwen-VL su arXiv il 24 agosto 2023: uno dei primi concorrenti aperti, costruito sul suo LLM Qwen. Google ha risposto il 6 dicembre 2023 con Gemini 1.0, presentato come nativamente multimodale fin dal pretraining, anziché come un modello testuale a cui fosse stato aggiunto in seguito un modulo per la visione. È stato svelato nelle versioni Ultra, Pro e Nano, mentre l’accesso alle API di Gemini Pro è arrivato il 13 dicembre 2023.
È nel 2024 che l’ecosistema aperto ha raggiunto lo stesso ritmo. Il 14 maggio 2024 Google ha rilasciato PaliGemma, che abbina un encoder visivo SigLIP-So400m a un’architettura Gemma-2B — abbastanza piccolo da funzionare su una singola GPU di fascia consumer — e nel dicembre 2024 lo ha seguito con il più grande PaliGemma 2, nelle varianti 3B, 10B e 28B. Anthropic ha introdotto per la prima volta la possibilità di fornire immagini in input a Claude con la famiglia Claude 3 (Opus, Sonnet, Haiku) il 4 marzo 2024, rendendo disponibile la visione a ogni livello fin dal lancio, anziché riservarla al modello di punta.
Alibaba ha rilasciato Qwen2-VL il 30 agosto 2024 e Meta ha pubblicato i modelli di Llama 3.2 dotati di capacità visive — nelle versioni da 11B e 90B parametri, capaci di elaborare immagini fino a 1120x1120 pixel — il 25 settembre 2024. Il ritmo ha continuato ad accelerare nel 2025: Qwen2.5-VL è arrivato il 28 gennaio 2025 e le varianti più grandi di Qwen3-VL (235B-A22B, nelle versioni Instruct e Thinking) il 23 settembre 2025. Poi la visione ha smesso del tutto di essere indicata nel nome come una variante. Alibaba ha rilasciato Qwen3.5 il 16 febbraio 2026, inaugurando la serie con Qwen3.5-397B-A17B, un modello a pesi aperti con architettura mixture-of-experts sparsa, che attiva 17 miliardi dei suoi 397 miliardi di parametri per token ed è descritto come nativamente visivo-linguistico, anziché come un’edizione VL di un modello testuale. In circa tre anni, una tecnica inventata in due laboratori ha smesso di essere una funzionalità ed è diventata la configurazione predefinita del modello.
Quello che ancora non sanno fare: punti ciechi, conteggi e grafici
I risultati più citati nei benchmark sembrano solidi e continuano a migliorare. MMMU (Massive Multi-discipline Multimodal Understanding), presentato su arXiv nel novembre 2023 con 11,5K domande di livello universitario in sei discipline, collocava GPT-4V al 55,7% al lancio, contro un’accuratezza dell’88,6% nella validazione per il miglior esperto umano: un divario ampio. A metà del 2026, la classifica racconta una storia diversa: secondo i risultati riportati, i modelli di frontiera raggiungono percentuali nella fascia alta degli ottanta, avvicinandosi a quel risultato degli esperti umani o superandolo di poco.
Su DocVQA, un benchmark di domande e risposte visive sui documenti, i modelli di frontiera superavano il 95% entro il 2026 e la classifica è descritta come prossima alla saturazione nella comprensione di documenti di una sola pagina: sui set standard, Qwen2.5-VL-72B risultava a 0,964 e GPT-4o a 0,928.
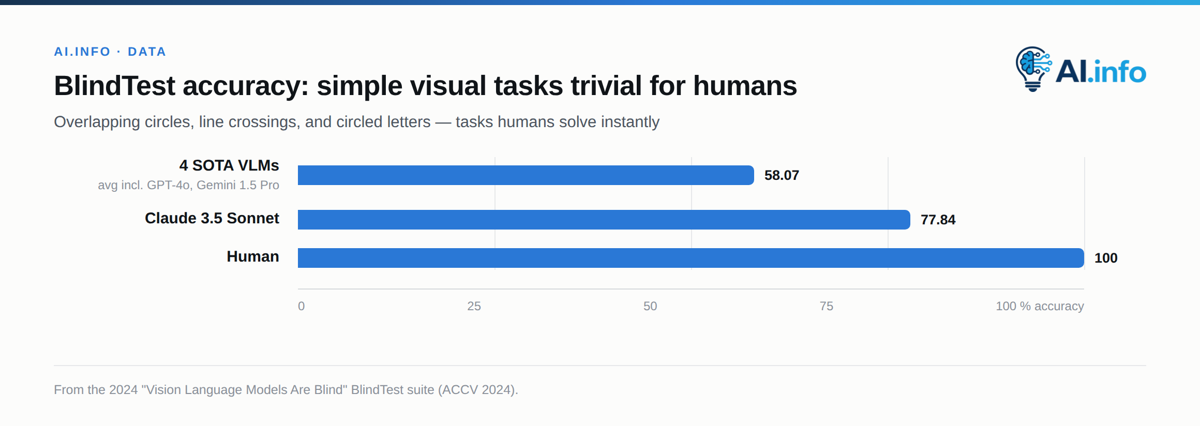
Questi numeri misurano il riconoscimento e la lettura, non il ragionamento visivo preciso che gli esseri umani svolgono senza pensarci. Un articolo del luglio 2024 intitolato «Vision Language Models Are Blind» (Rahmanzadehgervi, Bolton e coautori, presentato ad ACCV 2024) ha costruito BlindTest, una serie di sette compiti banali per gli esseri umani: stabilire se due cerchi si sovrappongono, quante volte si incrociano due linee, quale lettera di una parola è cerchiata, quanti cerchi compaiono in un logo simile a quello olimpico.
Quattro VLM che all’epoca erano allo stato dell’arte, tra cui GPT-4o e Gemini 1.5 Pro, hanno ottenuto in media un’accuratezza di appena il 58,07% in questi compiti; Claude 3.5 Sonnet ha fatto meglio di tutti, con il 77,84%, ancora ben lontano dal 100% che un essere umano raggiunge quasi istantaneamente. Il tipo di errore è ricorrente: le prestazioni di questi modelli peggiorano proprio quando le forme geometriche elementari si sovrappongono o sono vicine, segno che ragionano su una rappresentazione compressa e approssimativa dell’immagine, anziché tenere traccia della geometria esatta dei pixel.
I numeri dell’articolo restano quelli; i modelli sottoposti al test, no. GPT-4o, Gemini 1.5 Pro e Claude 3.5 Sonnet appartengono ormai a diverse generazioni fa e non è stata pubblicata una ripetizione comparabile di BlindTest sui modelli di frontiera attuali. Il 58,07% va letto come una misura dei sistemi del 2024, non come un giudizio sui modelli disponibili oggi.
Un problema collegato e più noto è il conteggio degli oggetti, che diversi benchmark sulle allucinazioni — comprendenti categorie come errori relativi ad attributi, relazioni, confronti e OCR — trattano come una categoria di errore distinta dal riconoscimento generale: i modelli indicano con sicurezza un numero sbagliato di uno o due elementi, oppure inventano oggetti o testi che non sono presenti nell’immagine. Succede più spesso nelle scene affollate e nelle immagini a bassa risoluzione di grafici o documenti.
La conseguenza pratica per chiunque impieghi questi sistemi è che punteggi medi elevati nei benchmark convivono con errori specifici e difficili da prevedere proprio nei compiti — conteggi precisi, occlusioni, dettagli della disposizione degli elementi in un grafico — che a un revisore umano sembrano più facili.
Be My AI, le bozze dei referti radiologici e l’estrazione dai documenti
L’applicazione più concreta del lavoro sull’accessibilità dei VLM è la collaborazione tra Be My Eyes e OpenAI. Le aziende l’hanno annunciata nel marzo 2023, sviluppando «Virtual Volunteer» — poi ribattezzato Be My AI — a partire dalle capacità visive di GPT-4, affinché le persone cieche o ipovedenti potessero puntare la fotocamera del telefono su una scena o un documento e ottenere subito una descrizione vocale, anziché aspettare un volontario.
Dopo l’annuncio iniziale, la funzione è passata alla fase di test beta su iOS nell’agosto dello stesso anno. È stata poi distribuita a centinaia di migliaia di utenti iOS e Android, a partire da iOS nel settembre 2023 e da Android il 4 dicembre; nel novembre di quell’anno è arrivata anche un’integrazione con i contact center. È una delle poche applicazioni dei VLM in cui «vedere» è l’intero prodotto, non una funzione aggiunta a qualcos’altro.
In medicina, l’impiego è ancora più vicino alla ricerca che alla pratica clinica. È stato dimostrato che GPT-4V e modelli comparabili sono in grado di redigere bozze di referti radiologici dall’aspetto plausibile a partire da radiografie del torace. La ricerca del 2024–2025 ha inoltre prodotto sistemi visivo-linguistici specifici per la medicina, finalizzati alla generazione di referti e all’interpretabilità. Tra questi ci sono approcci basati sulla catena di pensiero che cercano di ancorare una diagnosi a regioni precise dell’immagine, invece di produrre descrizioni per libera associazione.
Quel confine normativo si è spostato alla fine del 2025, anche se non nel campo della diagnostica per immagini. UpDoc V1.0, autorizzato ai sensi della procedura 510(k) K253281 il 23 dicembre 2025 e annunciato il 25 giugno 2026, è descritto dal suo produttore come il primo software come dispositivo medico basato su un modello linguistico di grandi dimensioni rivolto ai pazienti. Ha un ambito volutamente ristretto: la titolazione dell’insulina per gli adulti con diabete di tipo 2, con un insieme definito di azioni e la provenienza registrata a ogni passaggio.
Leggere le immagini diagnostiche è un problema diverso. Gli strumenti autorizzati dalla FDA per la diagnostica per immagini restano reti più circoscritte, progettate per compiti specifici come il rilevamento di noduli o fratture. L’agenzia ha dichiarato soltanto che esplorerà modi per identificare e contrassegnare, nel suo elenco pubblico, i dispositivi basati su foundation model; a settembre 2026 non vi era ancora comparso alcun contrassegno del genere. Il lavoro sui VLM in radiologia rientra nella ricerca e nell’assistenza alla stesura delle bozze, non nella diagnosi autonoma.
L’IA applicata ai documenti è l’ambito in cui l’impiego suscita meno controversie: l’estrazione sul modello di DocVQA, cioè la lettura di tabelle, moduli e testi scansionati, è ormai una capacità comune tanto ai modelli di punta quanto ai modelli aperti dell’attuale generazione. Il motivo è proprio che si tratta di un problema di riconoscimento del testo, per il quale il transformer sottostante e i dati di addestramento affini a quelli dell’OCR sono particolarmente adatti, anziché di un problema di ragionamento spaziale, in cui questi modelli sono più deboli.
Dai pixel ai comandi motori: RT-2, OpenVLA e π0 di Physical Intelligence
La stessa architettura che permette a un modello di descrivere un’immagine può essere riutilizzata per controllare un robot, se si riaddestra il livello di output a emettere comandi motori invece di parole. RT-2 (Robotic Transformer 2) di Google DeepMind, annunciato il 28 luglio 2023, è stato tra i primi a dimostrarlo: realizzato adattando modelli visivo-linguistici esistenti (PaLM-E e PaLI-X), anziché addestrandone uno da zero, RT-2 produceva azioni robotiche sotto forma di token testuali. È stato addestrato congiuntamente su dati visivo-linguistici su scala Internet e su dimostrazioni fisiche raccolte da 13 robot nell’arco di 17 mesi.
Riusciva a generalizzare a istruzioni e oggetti mai comparsi nei dati di addestramento specifici per i robot — per esempio collocare un oggetto su un numero stampato o prendere il più piccolo tra diversi oggetti — perché il VLM sottostante aveva già appreso quei concetti dal preaddestramento su scala web.
Nel 2024 è arrivata la risposta open source, OpenVLA: un modello da 7 miliardi di parametri basato sul framework VLM Prismatic-7B, che combina un encoder visivo ottenuto dalla fusione di DINOv2 e SigLIP con un’architettura di base Llama 2. Addestrato su 970.000 dimostrazioni robotiche nel mondo reale, è stato pubblicato con tutti i pesi, così che anche i laboratori privi di flotte di robot delle dimensioni di quelle di Google potessero eseguirne il fine-tuning. Oggi rappresenta l’implementazione aperta di riferimento, più che lo stato dell’arte attuale.
Physical Intelligence, startup di robotica di San Francisco costituita nel 2024, ha presentato π0 il 31 ottobre 2024 come un «modello visione-linguaggio-azione basato sul flow matching». È partita da un VLM preaddestrato e vi ha aggiunto una testa per le azioni basata sul flow matching, addestrando il sistema su sette configurazioni robotiche distinte e 68 compiti. Lo ha poi mostrato alle prese con compiti che nessun precedente sistema robotico basato sull’apprendimento era riuscito a portare a termine dall’inizio alla fine, tra cui piegare il bucato preso da un cesto e assemblare una scatola di cartone. Dallo stesso laboratorio sono arrivati tre successori: π0.5 il 22 aprile 2025, π*0.6 il 17 novembre 2025 e π0.7 il 16 aprile 2026, ciascuno presentato per la capacità di generalizzare a compiti mai mostrati al robot.
Il 12 marzo 2025 Google DeepMind ha esteso questa linea a una famiglia orientata alla produzione, lanciando Gemini Robotics e Gemini Robotics-ER (ragionamento incarnato), basati su Gemini 2.0 e sviluppati in collaborazione con Apptronik per hardware umanoide. Gemini Robotics 2 è arrivato il 30 luglio 2026, affiancato da ER 2 e da una variante eseguibile sul dispositivo, spostando il problema del controllo da un paio di braccia a un intero corpo umanoide. La gamma va «dai piedi alla punta delle dita», secondo l’espressione di DeepMind, come mostrato su Apollo 2 di Apptronik. Lo schema alla base di tutti e tre i progetti è identico: prendere un modello che ha già imparato ad associare pixel e linguaggio su scala Internet e trattare l’azione fisica come un’ulteriore modalità che si può insegnare allo stesso transformer a produrre.