Approfondimenti tecnici
Il problema dei benchmark: come misuriamo l’intelligenza dell’IA e perché i test continuano a mostrare i loro limiti
Ogni benchmark di IA finisce per saturarsi, essere aggirato o mostrare pubblicamente i suoi limiti. Da GLUE e MMLU ad ARC-AGI, FrontierMath e Humanity’s Last Exam, ecco che cosa è successo, con date e numeri, fino al caso di un modello che
AI.info Team ·
Il ciclo di vita per cui nessuno li aveva progettati
Ogni benchmark di IA segue ormai lo stesso percorso, che i suoi autori lo vogliano o no. Un gruppo propone un test in cui i modelli esistenti ottengono pessimi risultati. I laboratori puntano a migliorare il punteggio. I risultati salgono finché il test non riesce più a distinguere i modelli buoni da quelli eccellenti. Qualcuno costruisce un sostituto più difficile e il ciclo ricomincia. Questa sequenza si è ripetuta almeno quattro volte in otto anni — da GLUE a SuperGLUE, poi a MMLU e infine a GPQA/ARC-AGI/FrontierMath/Humanity’s Last Exam — e il tempo fra la proposta di un test e la sua saturazione continua a ridursi.
Non è la storia di un singolo test progettato male: è ciò che accade quando le capacità dei modelli di frontiera migliorano più in fretta di quanto si riesca ad aggiornare il metro di misura.
La conseguenza è che «lo stato dell’arte nel benchmark X» ha una data di scadenza, e questa data è sempre più spesso nota a tutti. I creatori di GPQA hanno previsto fin dall’inizio un confronto calibrato fra esperti e non esperti, aspettandosi che il test arrivasse a saturazione. Il creatore di ARC-AGI ha fondato un’intera organizzazione che assegna premi partendo dal presupposto che ogni test statico, prima o poi, venga aggirato o davvero risolto, e si è impegnato in anticipo a realizzarne una seconda versione prima ancora che la prima completasse il suo percorso. Considerare i benchmark verità di riferimento durature, anziché strumenti con una vita utile, è l’errore alla radice di gran parte dei problemi che seguono.
Da GLUE a MMLU: un decennio di soglie sempre più alte
GLUE è stato lanciato nel 2018 per verificare la comprensione del linguaggio a livello di frase attraverso nove compiti. Quell’anno GPT ha ottenuto 72,8 punti e BERT 80,5. All’inizio di luglio 2019, XLNet di Yang et al. aveva portato il punteggio più alto della classifica a 88,4, superando di poco il riferimento umano di 87,1. SuperGLUE è arrivato nel maggio 2019 perché GLUE era diventato troppo facile: al lancio mostrava ancora un divario di circa 20 punti tra il modello migliore e le prestazioni umane, ed era proprio questo lo scopo.
Non è durato: T5 ha raggiunto 88,9, a meno di un punto dal punteggio umano, e il 6 gennaio 2021 un ensemble di DeBERTa di Microsoft aveva superato il riferimento umano di 89,8.
| Benchmark | Punteggio al lancio | Punteggio successivo / a saturazione |
|---|---|---|
| GLUE (2018) | GPT 72,8 / BERT 80,5 | XLNet 88,4, oltre il riferimento umano di 87,1 |
| MMLU (2020) | GPT-3 175B: 43,9% | Modelli di frontiera oltre l’88% entro il 2026 |
| ARC-AGI-1 | 33% | 55,5% (ARC Prize 2024) |
| FrontierMath (2024) | Meno del 2% (tutti e 6 i modelli al lancio) | 87-88% (meno di due anni dopo) |
| ARC-AGI-2 (2025) | 24,03%, il vincitore della competizione del 2025 | ~95% nelle rilevazioni senza limiti, settembre 2026 |
| ARC-AGI-3 (2026) | 0,51% al lancio | 62,7% o 99,9%, a seconda dell’infrastruttura di valutazione |
MMLU, reso disponibile il 7 settembre 2020 da Dan Hendrycks e coautori (e pubblicato a ICLR 2021), ha segnato il successivo cambio di riferimento. Comprende 57 materie — dalla matematica elementare al diritto alla virologia — distribuite su 15.908 domande a scelta multipla. Al lancio, la maggior parte dei modelli otteneva punteggi vicini al 25% che si raggiungerebbe rispondendo a caso; GPT-3 175B è arrivato al 43,9% in una valutazione few-shot.
Entro il 2026 ogni modello di frontiera supera all’incirca l’88% su MMLU, e diverse rilevazioni lo descrivono come di fatto saturo: un «controllo di base» utile soprattutto a confermare che un modello non abbia problemi, non a classificare i sistemi di frontiera.
GSM8K (8.500 problemi di matematica formulati a parole per la scuola primaria, 2021) e HumanEval (164 problemi di programmazione scritti a mano, introdotto insieme a Codex) sono entrambi passati, nel giro di pochi anni, dall’essere test capaci di distinguere i modelli a esercizi in cui i punteggi sono vicini al massimo. È per questo che la valutazione delle capacità matematiche e di programmazione si è spostata su GPQA, FrontierMath e SWE-bench.
La fuga di dati che nessuno può escludere del tutto
La saturazione ha un parente meno presentabile: la contaminazione. Si verifica quando le domande di un test, o loro parafrasi molto simili, finiscono nei dati di addestramento di un modello, gonfiando i punteggi senza rispecchiare reali progressi nelle capacità. Il problema è abbastanza vecchio da comparire negli articoli fondativi del settore. L’articolo originale su GPT-3 di Brown et al. (2020) rivelava nella propria appendice che un bug nella procedura di filtraggio aveva lasciato entrare dati dei benchmark nell’addestramento. Rilevava inoltre che C4, un corpus comunemente usato per il preaddestramento, conteneva già le porzioni di test di diversi benchmark, prelevate in blocco da GitHub.
Il rapporto tecnico di OpenAI su GPT-4 è andato oltre: descrive come il gruppo abbia inserito parti dei set di addestramento di MATH e GSM8K nei dati usati per addestrare GPT-4, allo scopo di migliorarne le prestazioni matematiche, effettuando al tempo stesso un controllo delle sottostringhe in comune per verificare che i set di test tenuti da parte non fossero duplicati.
Da allora, verifiche indipendenti hanno continuato a riscontrare contaminazione misurabile: per Mistral-7B-v0.1 su HellaSwag e GSM8K, per Llama-3-70B su ARC e per le famiglie Phi e Mistral su GSM8K. In quest’ultimo caso, le prestazioni su una raccolta di quesiti in stile GSM8K scritti appositamente (GSM1K) erano inferiori a quelle sul test originale fino all’8%: un divario compatibile con la memorizzazione, anziché con il ragionamento. Nulla di questo significa che un determinato laboratorio bari intenzionalmente: la contaminazione può entrare attraverso dati di preaddestramento raccolti dal web anni prima che qualcuno esegua una valutazione. Significa però che, ormai, chi presta attenzione a questi aspetti considera un punteggio ottenuto in un benchmark senza una verifica della contaminazione come un’affermazione da verificare, non come un fatto.
Costruire benchmark che resistono
La risposta è stata progettare test capaci di resistere sia alla saturazione sia alla contaminazione. GPQA, pubblicato il 20 novembre 2023 da David Rein e coautori (della NYU, con collaboratori di Anthropic), comprende 448 domande a scelta multipla scritte da esperti di livello dottorale in biologia, fisica e chimica, concepite per essere «a prova di Google». Il suo sottoinsieme più difficile, GPQA Diamond (198 domande), comprende solo i quesiti su cui entrambi gli esperti incaricati dell’annotazione erano d’accordo e a cui la maggior parte dei non esperti competenti continuava a rispondere in modo errato, pur avendo accesso illimitato al web e oltre 30 minuti per domanda. I dottori di ricerca nelle rispettive discipline raggiungono un’accuratezza di circa il 65%; GPT-4, al lancio, arrivava al 39%.
SWE-bench, e il sottoinsieme SWE-bench Verified curato da OpenAI e pubblicato il 13 agosto 2024, hanno seguito una strada diversa: anziché scrivere nuove domande, attingono a problemi reali segnalati su GitHub e chiedono a un modello di generare una patch che superi l’effettiva suite di test del progetto. Le 500 attività di Verified sono state selezionate dopo che 93 sviluppatori Python professionisti avevano esaminato 1.699 campioni candidati per verificarne la risolvibilità.
Ha funzionato come strumento per distinguere i modelli per appena un anno: secondo i dati della stessa OpenAI, il risultato migliore è passato dal 74,9% all’80,9% in circa sei mesi. Poi, nel 2025, OpenAI ha pubblicato un audit da cui è emerso che, dei 138 problemi che il suo modello o3 non riusciva a risolvere con regolarità in 64 tentativi, il 59,4% aveva test progettati male.
OpenAI ha quindi smesso di pubblicare i punteggi di SWE-bench Verified e ha indirizzato il settore verso SWE-bench Pro: un raro caso in cui è lo stesso promotore di un benchmark a ritirarlo pubblicamente.
FrontierMath, lanciato da Epoch AI nel novembre 2024, ha fissato l’asticella così in alto che tutti e sei i modelli valutati al lancio hanno risolto meno del 2% dei suoi problemi matematici di livello di ricerca. Meno di due anni dopo, i punteggi migliori avevano superato l’87–88%, un aumento di oltre quaranta volte: abbastanza rapido da indurre Epoch a rivedere il benchmark il 12 giugno 2026, dopo aver trovato errori nel 42% della serie originale di problemi, ridotta così a 338. Da allora Epoch ha ampliato la famiglia di benchmark, invece di limitarsi a sfoltirla: FrontierMath comprende ora i Tiers da 1 a 4, oltre a una raccolta Open Problems di questioni di ricerca irrisolte con soluzioni verificabili per via computazionale, e FrontierMath Erdős, problemi aperti formulati o studiati da Paul Erdős, formalizzati in Lean.
ARC-AGI e il premio che non viene assegnato
Il benchmark ARC-AGI di François Chollet affronta la questione da un’altra angolazione: rompicapi astratti basati su griglie, facili per gli esseri umani senza preparazione e storicamente durissimi per le reti neurali, progettati per mettere alla prova il ragionamento fluido anziché le conoscenze memorizzate. Chollet ha fondato insieme a Mike Knoop l’ARC Prize Foundation per organizzare una competizione annuale in cui parte del montepremi resta in sospeso finché non viene superata una soglia effettiva.
ARC Prize 2024 ha prodotto il più grande salto in un solo anno registrato dal benchmark dal 2020: il miglior risultato sul set originale ARC-AGI-1 è passato dal 33% al 55,5%. È per questo che, nel marzo 2025, ARC-AGI-2 lo ha sostituito: è stato progettato per resistere alle tecniche di sintesi di programmi e di ricerca a forza bruta che avevano avuto successo con la prima versione.
Secondo ARC Prize, ogni compito di ARC-AGI-2 è stato risolto da almeno due delle oltre 400 persone sottoposte al test a San Diego all’inizio del 2025. ARC Prize 2025 ha attirato 1.455 squadre e 15.154 proposte su Kaggle; la squadra vincitrice NVARC si è classificata prima con il 24,03%, usando un modello addestrato al momento del test e costruito con componenti di Tiny Recursive Model: ben lontano dalla soglia per il premio, nonostante la vittoria nella competizione.
ARC Prize 2026 ha riorganizzato i premi in denaro, non la soglia. La sezione ARC-AGI-2 mette in palio 700.000 dollari: 275.000 dollari in premi per i progressi compiuti, 275.000 dollari per la migliore descrizione resa open source e un bonus di 150.000 dollari per la prima proposta ammissibile che superi l’85% sul set di valutazione privato. ARC Prize intende trasferire quest’ultimo premio al 2027 se nessuno ci riuscirà. Una sezione separata, ARC-AGI-3, mette in palio 850.000 dollari, di cui 700.000 riservati al primo agente che ottenga il 100%.
Nei leaderboard separati, senza limiti di costo, i laboratori di frontiera hanno fatto progressi molto più rapidi. Quando questo articolo è stato pubblicato per la prima volta, i migliori risultati pubblicati per ARC-AGI-2 erano il 37,6% di Claude Opus 4.5 con ragionamento esteso, a un costo di circa 2,20 dollari per compito, e il 54% di Gemini 3 Pro di Google con un meccanismo di raffinamento iterativo, a circa 30 dollari. A metà settembre 2026, i tracker pubblici LLM-Stats e BenchLM attribuivano entrambi a GPT-6 Astra di OpenAI il 95% e a GPT-5.5 l’85%; BenchLM riportava anche il 90,4% per Claude Opus 5.
Stando a questi numeri, un benchmark pubblicato nel marzo 2025 per resistere ai metodi che avevano superato il suo predecessore era già esaurito nel giro di diciotto mesi. Il divario tra il 24% di una proposta alla competizione, soggetta a un limite di costo e resa open source, e il 95% di un modello di frontiera senza vincoli è di per sé il risultato: la capacità grezza e la capacità meritevole di un premio sono ormai due grandezze distinte, e solo una è sottoposta a un audit indipendente.
Humanity’s Last Exam e i limiti di rendere difficili le domande
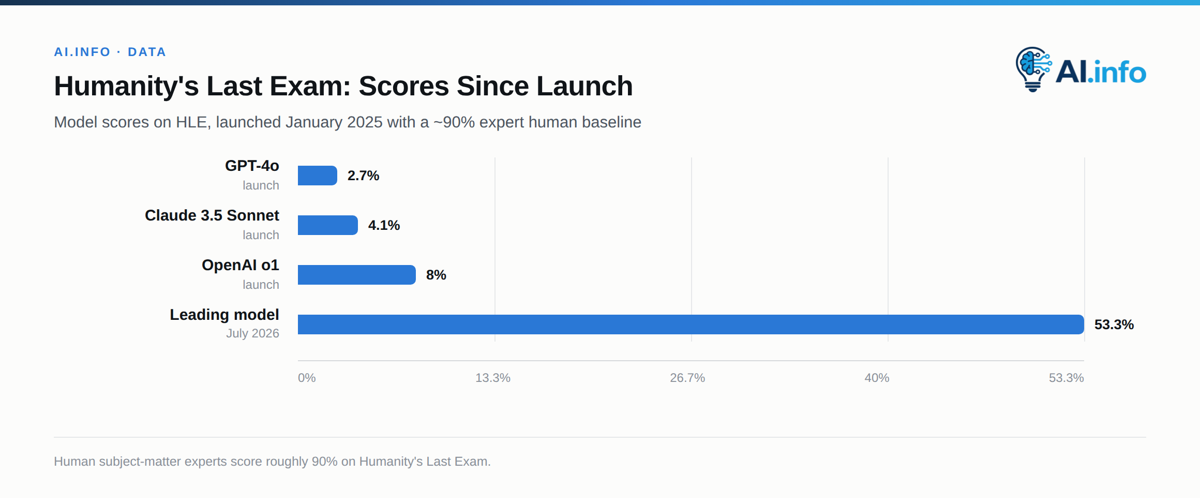
Humanity’s Last Exam, realizzato congiuntamente dal Center for AI Safety e da Scale AI sotto la direzione di Dan Hendrycks, direttore di CAIS — a quanto riferito, dopo che Elon Musk aveva osservato che MMLU era diventato troppo facile —, è stato lanciato nel gennaio 2025 con 2.500 domande di livello universitario avanzato. Le domande coprivano la matematica (il 41% del totale), le scienze fisiche e biologiche, le discipline umanistiche, l’informatica e l’ingegneria; circa il 14% era multimodale. L’esame è stato formalmente pubblicato su Nature nel gennaio 2026. Al lancio, GPT-4o ha ottenuto il 2,7%, Claude 3.5 Sonnet il 4,1% e o1 di OpenAI l’8%, a fronte di un valore di riferimento approssimativo del 90% per gli esperti umani nei rispettivi campi.
La difficoltà dell’esame comportava un costo che i suoi creatori non avevano messo in conto. Poiché le domande erano state scelte proprio perché i modelli di frontiera sbagliavano a rispondervi, e i revisori dedicavano non più di cinque minuti a verificare la motivazione di ciascuna risposta, il controllo di qualità era limitato. Nel luglio 2025, il laboratorio di ricerca FutureHouse ha esaminato 321 domande di biologia e chimica contenenti solo testo, usando un agente per la ricerca nella letteratura e una revisione umana. Ha riscontrato che circa il 29% (± 3,7%, intervallo di confidenza al 95%) presentava risposte direttamente in contrasto con la letteratura sottoposta a revisione paritaria.
Una successiva verifica condotta dallo stesso team di HLE ha rilevato problemi in circa il 18% di un sottoinsieme delle domande. FutureHouse ha pubblicato un sottoinsieme corretto, «HLE Bio/Chem Gold», e il team di HLE ha introdotto «HLE-Rolling», una versione aggiornata continuamente per recepire gli errori segnalati anziché lasciare immutato un insieme di domande difettoso.
I punteggi, comunque, sono saliti molto dal lancio. Nel monitoraggio di Artificial Analysis del luglio 2026, il modello in testa ha ottenuto il 53,3%; due mesi dopo, sia LLM-Stats sia BenchLM attribuivano al primo modello il 65%, con i tre successivi a meno di mezzo punto percentuale di distanza. Un test in cui, al lancio, i punteggi erano del 2,7% e del 4,1% ora distingue i migliori modelli per differenze nell’ordine degli arrotondamenti, pur contenendo ancora una quota significativa di risposte errate secondo la verifica condotta dal suo stesso team. Rendere un test più difficile non lo rende automaticamente più corretto.
Quando sono gli esseri umani a valutare le risposte: l’anno difficile di LMArena
I benchmark statici non sono gli unici sotto pressione. LMArena (in precedenza LMSYS Chatbot Arena) classifica i modelli attraverso voti umani raccolti su larga scala in confronti a coppie e convertiti in un punteggio sul modello Elo. Nell’aprile 2025 ha attraversato una crisi di credibilità. Meta ha presentato all’Arena un modello chiamato «Llama-4-Maverick-03-26-Experimental» — una variante ottimizzata per la chat, non il modello che stava per rendere pubblico — che si è piazzato al 2º posto della classifica, subito dietro Gemini 2.5 Pro.
Quando la versione effettivamente resa pubblica, Llama-4-Maverick-17B-128E-Instruct, è stata testata separatamente l’11 aprile, si è piazzata al 32º posto, trenta posizioni sotto la variante sperimentale che l’aveva rappresentata. I ricercatori che hanno confrontato le risposte hanno constatato che la versione sperimentale era notevolmente più prolissa e ricca di emoji, uno stile che sembra averle procurato voti di preferenza indipendentemente dalla qualità di fondo. LMArena ha riconosciuto che «lo stile e il tono delle risposte del modello» avevano dato alla versione ottimizzata un vantaggio che la comunicazione iniziale non aveva chiarito.
Poche settimane dopo, un team composto da ricercatori di Cohere Labs, AI2, Princeton, Stanford, Waterloo e della University of Washington ha pubblicato «The Leaderboard Illusion», un’analisi di 68 pagine su circa due milioni di confronti nell’Arena tra 243 modelli di 42 fornitori. L’analisi ha rilevato che pochi grandi laboratori proprietari — l’articolo cita Meta, Google e OpenAI — avevano accesso a test privati prima del rilascio non dichiarati, alla possibilità di ritirare selettivamente i punteggi e a frequenze di campionamento sproporzionatamente elevate rispetto ai concorrenti con modelli a pesi aperti. Nelle simulazioni, scegliere la migliore tra 20 varianti private aumentava il punteggio massimo atteso di circa 50 punti Arena rispetto alla presentazione di un unico modello pubblico.
LMArena ha pubblicato una risposta contestando alcuni aspetti dell’impostazione dell’analisi. La lezione di entrambi gli episodi è la stessa che emerge dal problema della contaminazione nei benchmark statici: l’affidabilità di una classifica dipende da quella del processo con cui vengono presentati i modelli, indipendentemente da quante persone votino.
Oltre il punteggio: la durata dei compiti e i prossimi passi
La prospettiva più utile emersa negli ultimi due anni non proponeva affatto un quiz più difficile. METR, l’organizzazione senza scopo di lucro che si occupa della valutazione dell’IA, ha pubblicato «Measuring AI Ability to Complete Long Tasks» nel marzo 2025. Lo studio definisce l’«orizzonte temporale al 50%» di un modello come la durata di un compito — misurata in base al tempo necessario a un professionista umano esperto — che il modello riesce a completare autonomamente con un’affidabilità del 50%, usando una serie di compiti di sviluppo software e ricerca che richiedono da un secondo a sedici ore di lavoro umano equivalente.
Seguendo l’evoluzione dei modelli di frontiera fino al 2019, METR ha rilevato che questo orizzonte raddoppiava all’incirca ogni sette mesi; studi successivi hanno indicato tempi di raddoppio compresi tra due e sei mesi nei campi dello sviluppo software e del ragionamento. La domanda non è più «che punteggio ha ottenuto il modello», ma «quanto può durare un compito che affido a questo sistema prima di lasciarlo lavorare da solo»: una misura più vicina a ciò che richiede davvero l’impiego dell’IA in un flusso di lavoro reale.
LiveBench, oggetto di un articolo ICLR Spotlight del 2025, sostituisce ogni mese circa un sesto delle proprie domande, ricavate da nuovi articoli su arXiv, notizie e altri materiali pubblicati dopo la data limite dei dati di addestramento. Così l’intero insieme si rinnova ogni sei mesi e non può essere memorizzato in anticipo. Inoltre, ogni risposta viene valutata rispetto a una risposta corretta oggettivamente verificabile, anziché da un modello linguistico usato come giudice.
Set di test riservati e tenuti da parte, valutazioni specifiche per settore condotte all’interno delle singole aziende e benchmark aggiornati continuamente e in tempo reale convergono sul principio già adottato da GPQA e ARC-AGI: un test che non si può aggirare una volta per poi riutilizzare quel vantaggio all’infinito è preferibile a uno che produce un numero chiaro, stabile e confrontabile.
Sei mesi di ARC-AGI-3 e il punteggio che dipende dall’harness
ARC-AGI-3, il benchmark interattivo per agenti in stile videogioco lanciato da Chollet il 25 marzo 2026, ha condotto quell’esperimento più rapidamente di quanto chiunque si aspettasse. Al lancio, i modelli di frontiera hanno ottenuto lo 0,51%, su ambienti che gli esseri umani risolvono completamente. Il 1° maggio 2026, ARC Prize ha riportato un punteggio dello 0,43% per GPT-5.5 e dello 0,18% per Claude Opus 4.7 sull’insieme semiprivato. Dopo cinque settimane, il muro era ancora lì.
Il 3 settembre 2026, ARC Prize ha pubblicato la propria valutazione di GPT-6 Astra di OpenAI, e il muro era caduto. Astra ha ottenuto il 62,7% su ARC-AGI-3 Semi-Private, a un costo di 26.000 dollari. Eseguito attraverso quello che ARC Prize chiama un harness Provider Adapter, lo stesso modello sulle stesse prove ha ottenuto il 99,9% per 19.000 dollari. ARC Prize ha inoltre rilevato che Astra ha impiegato meno azioni rispetto al riferimento umano nel 96,0% dei livelli.
I due punteggi vanno letti insieme: l’argomento di questo saggio sta nello scarto tra loro. Un modello, un benchmark, un valutatore, una pubblicazione e 37 punti percentuali che dipendono interamente dall’infrastruttura attraverso cui viene eseguito il modello. ARC Prize ha usato cautela, scrivendo: «Pur ritenendo che Astra rappresenti un progresso significativo verso la generalizzazione, non affermiamo che sia un’AGI».
Le candidature per ARC Prize 2026 devono essere presentate entro il 2 novembre e i risultati saranno annunciati il 4 dicembre; a metà settembre, il bonus di 150.000 dollari per chi supera l’85% sull’insieme privato di ARC-AGI-2 non era stato assegnato. Ciò che separa un 95% su un tracker da quel premio ancora non assegnato non è la capacità. Sono l’accesso a internet, il rilascio open source, i limiti di costo e una verifica: le condizioni in cui un numero significa qualcosa. Il settore ha passato otto anni a costruire test più difficili. Il problema più difficile si è rivelato trovare un accordo su come eseguirli.