Approfondimenti tecnici
Generazione aumentata tramite recupero: architettura e buone pratiche
Una guida completa alla progettazione e all’ottimizzazione dei sistemi RAG. Tratta le strategie di chunking, la scelta degli embedding, gli algoritmi di recupero, il reranking e la messa in produzione.
AI.info Team ·
Perché esiste il RAG e dove fallisce
Un modello con capacità di ragionamento perfette ma senza alcun accesso ai tuoi dati è inutile per la maggior parte delle domande aziendali. La generazione aumentata tramite recupero serve a colmare questa lacuna: invece di riaddestrare o sottoporre a fine-tuning un modello ogni volta che cambia la tua base di conoscenza, recuperi i passaggi pertinenti al momento della richiesta e li fornisci al modello come contesto.
L’idea risale al paper presentato da Lewis et al. a NeurIPS nel 2020, «Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks», che combinava un sistema di recupero di passaggi basato su rappresentazioni dense con un generatore sequence-to-sequence e mostrava risultati migliori dei modelli puramente parametrici nelle domande e risposte su argomenti aperti. Sei anni dopo, l’idea di fondo è rimasta la stessa, ma la progettazione dei sistemi che la circondano è diventata una disciplina a sé, con modalità di errore distinte in ogni fase: acquisizione, chunking, creazione degli embedding, indicizzazione, recupero, reranking e generazione.
La maggior parte dei team che afferma «il nostro sistema RAG non funziona» in realtà non ha diagnosticato nulla: il problema potrebbe trovarsi in una qualsiasi di queste sette fasi, e ciascuna richiede una soluzione diversa. Questo articolo percorre la pipeline fase per fase, illustrando le tecniche e i numeri specifici che distinguono una demo da un sistema in produzione.
Il livello di acquisizione e chunking
Il chunking determina quale unità di testo viene trasformata in embedding e recuperata. Se si sbaglia qui, nessun accorgimento nelle fasi successive può recuperare le informazioni perse.
Il chunking a dimensione fissa (per esempio, 512 token con una sovrapposizione del 10-15%) è l’impostazione predefinita di RecursiveCharacterTextSplitter di LangChain e SentenceSplitter di LlamaIndex. È economico e prevedibile, ma spezza indiscriminatamente frasi, tabelle e sezioni logiche. Se si suddivide un 10-Q finanziario secondo confini fissi, si può facilmente separare una tabella dei ricavi dalle intestazioni delle colonne.
Il chunking semantico raggruppa le frasi in base alla somiglianza dei loro embedding, creando una separazione quando la divergenza tra frasi adiacenti supera una soglia. Rispetta meglio i confini tra argomenti, ma richiede un passaggio di creazione degli embedding solo per decidere dove tagliare e può produrre chunk di dimensioni molto disomogenee.
Il chunking basato sulla struttura usa gli elementi strutturali del documento — intestazioni Markdown, tag HTML, blocchi del layout PDF — per delimitare i chunk. Per i corpora strutturati (siti di documentazione, contratti, documenti depositati presso la SEC) è di solito l’opzione con il maggiore impatto, perché preserva le unità semantiche definite dall’autore.
Il problema più profondo, comune a tutti e tre gli approcci, è che un chunk isolato perde il contesto del documento da cui proviene. Un chunk che dice soltanto «I ricavi sono cresciuti del 12% nel segmento» è inutile se non si sa di quale azienda, trimestre e segmento si tratti. Due tecniche affrontano direttamente questo problema:
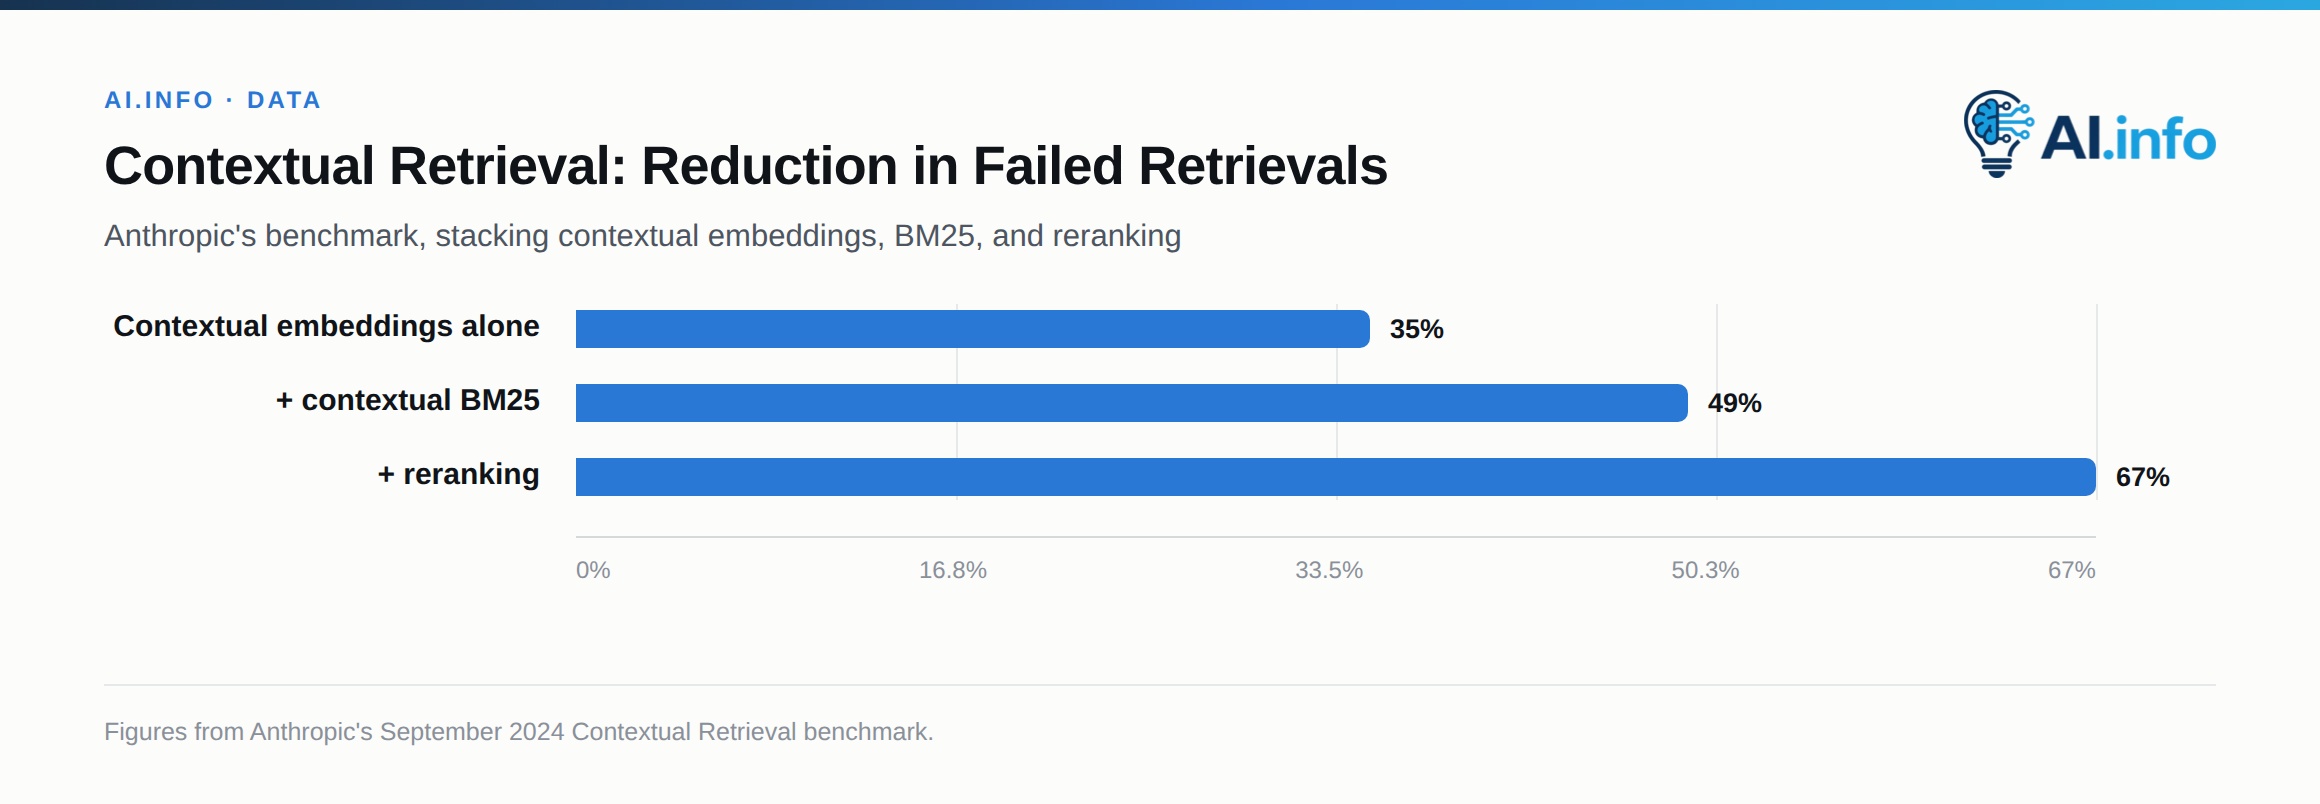
- Contextual Retrieval, pubblicato da Anthropic nel settembre 2024, antepone a ogni chunk, prima di crearne l’embedding, un breve riepilogo generato da un LLM — per esempio, «Questo chunk proviene dal 10-Q di Acme Corp relativo al terzo trimestre del 2024 e tratta i ricavi del segmento cloud» — e indicizza il chunk arricchito sia nell’archivio vettoriale sia in un indice BM25. Nei benchmark di Anthropic, i soli embedding contestuali hanno ridotto del 35% i recuperi falliti; la riduzione è salita al 49% con l’aggiunta di BM25 contestuale e al 67% aggiungendo anche una fase di reranking. Poiché il prompt usato per generare il contesto è quasi identico per tutti i chunk dello stesso documento, il prompt caching è una soluzione naturale che mantiene basso il costo aggiuntivo.
- Late chunking, introdotto dai ricercatori di Jina AI (Günther et al., arXiv:2409.04701, settembre 2024), inverte l’ordine abituale: prima crea gli embedding dell’intero documento con un modello di embedding a contesto lungo, poi aggrega gli embedding a livello di token entro i confini di ciascun chunk. Poiché gli embedding dei token sono stati calcolati con un meccanismo di attenzione sull’intero documento, l’embedding risultante di ogni chunk contiene informazioni sul resto del documento, senza chiamate aggiuntive a un LLM. Serve un modello di embedding con una finestra di contesto lunga: Jina lo ha introdotto per la prima volta in
jina-embeddings-v3.
Entrambi gli approcci rispondono alla stessa causa di fondo: gli embedding dei singoli chunk sono accurati a livello locale, ma non vedono il contesto complessivo.
Modelli di embedding: scegliere l’encoder
Il modello di embedding determina che cosa significhi «simile» nel proprio spazio vettoriale, e il settore è progredito così in fretta che un modello scelto nel 2024 probabilmente non è più la scelta migliore nel 2026. Nella classifica MTEB (Massive Text Embedding Benchmark), text-embedding-3-large di OpenAI — il cavallo di battaglia di una quota enorme dei sistemi RAG in produzione dal suo lancio nel gennaio 2024 — è ancora il modello più recente di OpenAI a settembre 2026, mentre text-embedding-ada-002 è contrassegnato come legacy. Nella maggior parte dei benchmark di retrieval è stato superato da modelli più recenti: voyage-3-large di Voyage AI, i modelli Gemini Embedding di Google e modelli a pesi aperti come la serie Qwen3-Embedding di Alibaba e la linea v5 di Jina, le cui varianti omni, da maggio 2026, incorporano testo, immagini, audio, video e PDF in un unico spazio condiviso.
Qwen3-Embedding-8B era in testa alla classifica multilingue MTEB a metà del 2025 con un punteggio di 70,58, ed è distribuito con una licenza aperta: un aspetto importante se i requisiti di residenza dei dati impongono di ospitarlo sui propri server. Le prime posizioni di quella classifica cambiano ogni pochi mesi e oggi comprende più di mille modelli: qualsiasi posizione specifica — compresa quella appena citata — va quindi letta come una fotografia datata, non come una raccomandazione valida nel tempo.
La decisione pratica non è «quale modello è in cima alla classifica»: MTEB aggrega risultati relativi a compiti che potrebbero non assomigliare al vostro carico di lavoro di retrieval. Le domande da porsi sono queste:
- La distribuzione dei dati di addestramento del modello assomiglia a quella del vostro ambito (giuridico, codice, biomedico, multilingue)?
- Qual è la lunghezza massima dell’input? Supera la dimensione dei vostri chunk con un margine sufficiente?
- La dimensionalità dei vettori, e quindi la memoria occupata dall’indice, è accettabile per le dimensioni del vostro corpus? I modelli addestrati con la tecnica Matryoshka, come
text-embedding-3-large, consentono di ridurre il numero di dimensioni con un degrado graduale delle prestazioni: una leva concreta per contenere i costi. - Potete sostenere la latenza delle API e il costo per token ai vostri volumi di acquisizione, oppure vi serve un encoder ospitato sui vostri server?
Ricalcolate gli embedding del vostro set di valutazione ogni volta che prendete in considerazione un cambio di modello: i cambiamenti del modello di embedding non sono necessariamente retrocompatibili, e mescolare nello stesso indice vettori prodotti da modelli incompatibili compromette la ricerca dei vicini più prossimi senza dare segnali evidenti.
Archiviare e cercare i vettori
Una volta ottenuti gli embedding, serve un indice che restituisca rapidamente i vicini più prossimi approssimati. Dominano due famiglie di indici:
- HNSW (Hierarchical Navigable Small World graphs) costruisce un grafo a più livelli in cui ogni vettore è collegato ai suoi vicini più prossimi; la ricerca parte da un livello superiore poco denso e scende verso livelli più densi, esaminando in genere solo poche centinaia di nodi per trovare corrispondenze quasi ottimali tra milioni di vettori. È la scelta predefinita in pgvector, Weaviate e Qdrant e offre una recall elevata (spesso superiore al 95%) con una latenza ridotta, a costo di un maggiore uso di memoria e di tempi di costruzione dell’indice più lunghi rispetto alle alternative.
- IVF (inverted file index) con product quantization (PQ), la combinazione resa popolare da FAISS, raggruppa i vettori in celle di Voronoi durante la costruzione dell’indice e limita la ricerca alla cella o alle celle più vicine; nel frattempo, PQ comprime ogni vettore in un piccolo codice per ridurre l’uso di memoria. Le indicazioni della stessa Meta suggeriscono, per l’uso in produzione, un rapporto tra cluster e vettori di circa 1:1.000, con codici PQ da 8-16 byte. Si sacrifica parte della recall in cambio di una riduzione drastica della memoria necessaria, un fattore importante quando si indicizzano centinaia di milioni di vettori.
Quanto alla scelta dell’infrastruttura, pgvector trasforma Postgres in un archivio vettoriale: una soluzione interessante se usate già Postgres e volete riunire ricerca vettoriale, filtri sui metadati e scritture transazionali in un unico sistema, invece di sincronizzare due database. Le versioni recenti di pgvector hanno ridotto notevolmente il divario di prestazioni rispetto ai database vettoriali dedicati: la costruzione degli indici HNSW è diventata molto più rapida con la versione 0.6.0, che ha introdotto la costruzione parallela. FAISS è una libreria, non un servizio: la integrate nel vostro codice di retrieval e gestite voi stessi la persistenza, una soluzione adatta ai team che vogliono il pieno controllo dei parametri di indicizzazione. I database vettoriali gestiti (Pinecone, Weaviate, Qdrant, Milvus) scambiano questo controllo con una maggiore semplicità operativa: si occupano loro di replica, scalabilità orizzontale e filtri.
Un indice FAISS minimale per qualche centinaio di migliaia di chunk si presenta così:
import faiss
import numpy as np

dim = 1024  # matches your embedding model's output dimension
quantizer = faiss.IndexFlatIP(dim)
index = faiss.IndexIVFPQ(quantizer, dim, 1024, 16, 8)  # 1024 clusters, 16-byte codes
index.train(training_vectors)   # a representative sample, e.g. 50-100k vectors
index.add(all_vectors)
index.nprobe = 16  # cells searched at query time; trade recall for speed
distances, ids = index.search(query_vector, k=20)
Ricerca ibrida: non abbandonate la corrispondenza per parole chiave
Il retrieval basato esclusivamente su vettori densi offre sistematicamente prestazioni inferiori nelle query che richiedono corrispondenze esatte: codici SKU dei prodotti, codici di errore, citazioni giuridiche, nomi propri rari. Un encoder denso addestrato a cogliere la somiglianza semantica non ha un forte incentivo a distinguere «fattura n. 48213» da «fattura n. 48214»: sono quasi identiche sul piano semantico, ma a voi serve proprio quella esatta. Per questo i sistemi RAG in produzione affiancano quasi sempre al retriever denso un retriever lessicale (BM25, o SPLADE, il suo parente basato su rappresentazioni sparse apprese) e fondono le due liste ordinate per rilevanza.
Reciprocal Rank Fusion (RRF) è il metodo di fusione standard proprio perché aggira il problema della normalizzazione dei punteggi: quelli di BM25 non hanno un limite superiore e dipendono dal corpus, mentre le similarità coseno sono comprese tra -1 e 1, e non esiste un modo fondato per combinarli direttamente. RRF ignora l’entità dei punteggi e combina i documenti soltanto in base alla posizione in classifica, usando la formula:
RRF_score(d) = Σ 1 / (k + rank_i(d))
sommata per ciascun retriever i, con k di norma impostato intorno a 60. Nei benchmark pubblicati, il retrieval ibrido con RRF può ottenere risultati inferiori al retrieval denso in termini di NDCG, ed è supportato nativamente da Elasticsearch, OpenSearch, Weaviate e Qdrant.
Reranking: il filtro del secondo passaggio
Il recupero dei documenti e il reranking risolvono problemi diversi. Un bi-encoder (l’architettura alla base della maggior parte dei modelli di embedding) codifica le query e i documenti indipendentemente: è questo che lo rende abbastanza veloce da cercare tra milioni di vettori, ma tale indipendenza fa anche perdere le informazioni sulle interazioni tra query e documento. Un cross-encoder reranker riceve la query e un documento candidato insieme, come un unico input, e produce un punteggio di pertinenza per ciascuna coppia. Riesce così a cogliere interazioni che sfuggono a un bi-encoder, ma è troppo lento per essere applicato a un intero corpus.
Lo schema standard è questo: prima si recupera un ampio insieme di candidati (50-100 porzioni di testo) con il meno costoso passaggio bi-encoder o ibrido, poi si applica il reranking per ridurre la selezione alle 5-10 porzioni che entrano effettivamente nel prompt. All’inizio di ottobre 2026, il modello gestito di punta di Cohere era rerank-v4.0-pro, un modello multilingue ottimizzato per la qualità su documenti in inglese, in altre lingue e in formato JSON semistrutturato, affiancato da rerank-v4.0-fast, pensato per una bassa latenza e un’elevata capacità di elaborazione; rerank-v3.5 e i modelli v3.0 per l’inglese e multilingui sono ancora disponibili. Il modello open source bge-reranker-v2-m3 di BAAI (Apache 2.0, 100+ lingue) assegna ancora un punteggio a una selezione ristretta in 50-100 ms su una GPU. Il 27 luglio 2026 Jina è passata a jina-reranker-v3.5 — 0,6 miliardi di parametri, un contesto di 131K token, assegnazione dei punteggi all’intera lista — mantenendo disponibile accanto a esso il modello v3 pubblicato nell’ottobre 2025.
Nel benchmark di Anthropic sul recupero contestuale, il reranking è stata la fase che ha prodotto il maggiore miglioramento marginale: aggiunto agli embedding contestuali e a BM25, ha portato la riduzione dei recuperi non riusciti dal 49% al 67%.
| Reranker | Tipo | Note |
|---|---|---|
| Cohere rerank-v4.0-pro / -fast | Cross-encoder gestito | Pro per la qualità, fast per la capacità di elaborazione; multilingue, gestisce JSON |
| BAAI bge-reranker-v2-m3 | Open source, Apache 2.0 | 50-100 ms su GPU, 100+ lingue |
| Jina jina-reranker-v3.5 | Aperto, assegnazione dei punteggi all’intera lista | Contesto di 131K token, 0,6B parametri (luglio 2026) |
Oltre la RAG ingenua: architetture a grafo e autocorrettive
La RAG standard risponde alle domande quando il fatto pertinente si trova in una o due porzioni di testo recuperabili. Fallisce invece sulle domande che richiedono di sintetizzare informazioni distribuite in un intero corpus: per «quali sono i temi principali di questa raccolta di documenti» non esiste un singolo passaggio che contenga la risposta.
GraphRAG, di Microsoft Research (Edge et al., «From Local to Global: A Graph RAG Approach to Query-Focused Summarization», arXiv:2404.16130, aprile 2024), affronta il problema costruendo un grafo della conoscenza sul corpus: estrae entità e relazioni con un LLM, raggruppa il grafo in comunità gerarchiche usando l’algoritmo Leiden e genera in anticipo sintesi delle comunità. Al momento della query, a una richiesta di «ricerca globale» si risponde sintetizzando le informazioni delle comunità pertinenti, anziché cercando tra le porzioni di testo grezze.
Microsoft ha segnalato risposte generate più complete e diversificate rispetto alla RAG ingenua, al prezzo di un processo di indicizzazione molto più costoso e complesso: l’estrazione del grafo dall’intero corpus non è un’operazione da ripetere con leggerezza.
Altre due architetture affrontano direttamente la qualità del recupero, anziché la sintesi a livello di corpus:
- Self-RAG (Asai et al., 2023, arXiv:2310.11511) sottopone un modello linguistico a fine-tuning affinché emetta speciali token di riflessione che determinano, nel corso della generazione, se una data query richieda il recupero di documenti e se un passaggio candidato sostenga davvero l’affermazione generata. Il recupero e l’autocritica diventano così un comportamento appreso e integrato, anziché una fase fissa del processo.
- Corrective RAG (CRAG) (arXiv:2401.15884, 2024) aggiunge un sistema leggero di valutazione del recupero che assegna un punteggio alla pertinenza dei documenti recuperati e, quando il grado di confidenza è basso, attiva azioni correttive: per esempio, ricorrere alla ricerca sul web oppure scomporre e ricomporre i passaggi recuperati per eliminare i contenuti non pertinenti prima della generazione.
Vale la pena adottare entrambe in modo selettivo: aggiungono latenza e complessità e sono più adatte agli ambiti in cui gli errori di recupero hanno un costo elevato (legale, medico, finanziario), anziché a un’applicazione universale.
Valutazione: misurare l’intero processo, non solo la risposta
L’errore più comune nella valutazione della RAG è controllare soltanto se la risposta finale sembri corretta. Questo confonde due possibili cause di errore indipendenti: il recupero ha trovato i passaggi giusti e la generazione li ha usati fedelmente? RAGAS, un framework open source di valutazione in Python, è costruito proprio attorno a questa distinzione e usa un LLM come giudice per assegnare punteggi secondo diversi criteri:
- Fedeltà — la quota di affermazioni nella risposta generata effettivamente sostenute dal contesto recuperato (individua le allucinazioni anche quando il recupero è stato corretto).
- Pertinenza della risposta — quanto direttamente la risposta generata affronta la query originale (individua i casi in cui il modello si concentra su contenuti recuperati ma solo marginalmente pertinenti).
- Precisione del contesto — se le porzioni di testo pertinenti compaiono ai primi posti tra quelle recuperate.
- Copertura del contesto — se il recupero ha trovato tutte le informazioni necessarie per rispondere in modo completo, misurata rispetto a una risposta di riferimento.
Misurare separatamente queste quattro metriche trasforma un vago «il sistema RAG non sembra funzionare bene» in una diagnosi su cui si può intervenire: una bassa copertura del contesto indica che occorre correggere la suddivisione del testo o il sistema di recupero; un’alta copertura del contesto accompagnata da una bassa fedeltà indica invece che la fase di generazione ignora o contraddice il contesto che ha recuperato, un problema di prompt, non di recupero.
Modalità di errore da mettere in conto
Anche una pipeline ben costruita tende a peggiorare in modi prevedibili:
- Informazioni perse nel mezzo. Liu et al. (Stanford, arXiv:2307.03172, 2023) hanno mostrato che, nei compiti con un contesto lungo, l’accuratezza degli LLM è massima quando il passaggio pertinente si trova all’inizio o alla fine della finestra di contesto, e cala in misura rilevabile quando è sepolto nel mezzo, indipendentemente dalle dimensioni della finestra. L’ordine dei risultati recuperati conta quindi anche dopo aver trovato i chunk giusti: mettete i passaggi di cui avete maggiore certezza all’inizio e alla fine, non tutti nel mezzo di un blocco di dieci chunk.
- Disallineamento tra recupero e generazione. Il sistema di recupero propone chunk tecnicamente pertinenti ma insufficienti (una tabella senza la sua didascalia, una clausola senza la sezione delle definizioni da cui dipende), e il modello colma la lacuna inventando informazioni oppure dà una risposta non abbastanza precisa.
- Troncamento ai confini dei chunk. Un chunk che termina a metà frase o a metà tabella perde proprio l’informazione cercata dalla query: un argomento forte a favore di una suddivisione che tenga conto della struttura, o del late chunking, anziché di una suddivisione ingenua in blocchi di dimensioni fisse.
- Indici non aggiornati. I database vettoriali non sanno che un documento di origine è cambiato, a meno che la pipeline di acquisizione non ne ricalcoli esplicitamente gli embedding e non lo reindicizzi. Gli aggiornamenti mancati che passano inosservati sono tra le cause più comuni degli episodi in cui, nei sistemi in produzione, «il bot comunica agli utenti una policy non aggiornata».
RAG e contesti lunghi: uno non sostituisce l’altro
Ora che le finestre di contesto sono arrivate a contenere centinaia di migliaia di token, torna spesso una domanda: il RAG serve ancora? Perché recuperare i contenuti, se si può inserire l’intero corpus nel prompt? Ci sono due ragioni per non farlo. La prima è l’effetto delle informazioni perse nel mezzo: una finestra di contesto più ampia non garantisce che il modello usi davvero tutto ciò che contiene. Il recupero è un modo per selezionare ciò a cui prestare attenzione, non soltanto un espediente per aggirare i limiti di una finestra piccola.
La seconda è che costi e latenza crescono con il numero di token elaborati, indipendentemente dal limite di contesto. Recuperare 10 chunk pertinenti da un corpus di un milione di documenti è più economico e veloce che rielaborare l’intero corpus per ogni query, ed è un approccio che funziona anche oltre la quantità di testo che può entrare in qualunque finestra di contesto. In pratica, i due approcci si completano: un contesto lungo permette di suddividere i documenti in modo meno aggressivo e di recuperare meno passaggi, ma non elimina la necessità di trovare prima la parte pertinente di un corpus ampio.
Costruire una pipeline che regga in produzione
I team che riescono a far funzionare il RAG in modo affidabile finiscono per adottare alcune abitudini: valutano separatamente recupero e generazione invece di limitarsi a esaminare le risposte finali, combinano BM25 e recupero denso invece di puntare tutto sugli embedding, riordinano i risultati prima della generazione invece di fidarsi della sola similarità vettoriale e considerano la suddivisione in chunk una scelta progettuale fondamentale, legata alla struttura dei documenti, anziché un’impostazione predefinita a cui pensare per ultima.
Niente di tutto questo è insolito: si tratta di applicare con rigore tecniche ormai ben documentate e sempre più spesso valutate con benchmark. La differenza tra una demo RAG e un sistema RAG che regge un anno di query di utenti reali sta quasi interamente nel rigore con cui ciascuna di queste fasi viene messa alla prova rispetto alle modalità di errore descritte sopra, non nella scoperta di qualche trucco sconosciuto.