Approfondimenti tecnici
La guerra degli ottimizzatori: come Muon sta sostituendo Adam nell’addestramento dell’IA di frontiera
Kimi K2 è stato addestrato su 15,5 bilioni di token con MuonClip, senza alcun picco della loss. Un anno dopo, Kimi K3, DeepSeek-V4 e GLM-5 ortogonalizzano tutti i propri aggiornamenti, mentre Muon ha un nuovo sfidante: Aurora.
AI.info Team ·
L’ottimizzatore che nessuno metteva in discussione, fino a oggi
Per circa un decennio, scegliere un ottimizzatore per addestrare una grande rete neurale non è stata davvero una scelta. Adam, pubblicato da Diederik Kingma e Jimmy Ba nel 2014, e il suo parente AdamW, che corregge il decadimento dei pesi, sono diventati lo standard a tal punto che la maggior parte degli articoli scientifici non si preoccupava nemmeno di giustificarne l’uso. Ogni modello GPT, ogni versione di Llama e ogni modello cinese a pesi aperti fino al 2024 ha addestrato i propri strati densi con una variante di AdamW.
Quegli undici anni di dominio incontrastato si sono conclusi nell’estate del 2025, quando Moonshot AI ha rilasciato Kimi K2, un modello mixture-of-experts da un bilione di parametri preaddestrato interamente con un nuovo ottimizzatore chiamato MuonClip. Il rapporto tecnico di Kimi K2 afferma chiaramente che il modello «è stato preaddestrato su 15,5 bilioni di token senza alcun picco della loss»: una stabilità che i modelli addestrati con AdamW su scala comparabile non hanno mai eguagliato.
Quattordici mesi dopo, ottimizzatori della famiglia Muon addestrano GLM-5 di Zhipu AI, Kimi K3 di Moonshot, DeepSeek-V4 e i modelli Trinity di Arcee AI. Il confronto tra Adam e Muon non è più una curiosità accademica: è una questione concreta nel preaddestramento dei modelli di frontiera, e Muon è il primo nuovo ottimizzatore per l’addestramento dell’IA, dai tempi dello stesso Adam, a raggiungere una reale scala di produzione.
Per capire perché, bisogna distinguere due domande che nei confronti informali vengono spesso confuse: Muon addestra più velocemente di AdamW per token, e addestra con maggiore stabilità alla scala a cui operano oggi i modelli mixture-of-experts? I dati riportati qui sotto rispondono a entrambe, con numeri riconducibili ai benchmark originali di Keller Jordan, ai rapporti tecnici di Moonshot e ai laboratori che hanno seguito quella strada.
Che cos’è Muon? Momentum ortogonalizzato con Newton-Schulz
Muon — MomentUm Orthogonalized by Newton-Schulz — è stato presentato dal ricercatore indipendente Keller Jordan in un post pubblicato l’8 dicembre 2024, inizialmente come ottimizzatore per le matrici bidimensionali dei pesi degli strati nascosti di una rete neurale (gli embedding e lo strato finale di classificazione restano affidati ad AdamW). L’algoritmo applica prima il normale SGD con momentum, poi sostituisce la matrice di aggiornamento risultante con la matrice semi-ortogonale più vicina, prima di applicare l’aggiornamento ai parametri.
Jordan motiva questo passaggio in termini precisi: «gli aggiornamenti prodotti sia da SGD con momentum sia da Adam per i parametri 2D delle reti neurali basate su transformer hanno tipicamente un numero di condizionamento molto elevato». In parole semplici, poche direzioni dell’aggiornamento prevalgono, mentre molte altre direzioni utili vengono quasi ignorate; ortogonalizzare l’aggiornamento ne appiattisce lo spettro, così che ogni direzione riceva una spinta di entità comparabile, anziché lasciare che poche direzioni singolari dominanti soffochino le altre.
Calcolare un’ortogonalizzazione esatta richiederebbe una decomposizione completa ai valori singolari per ogni matrice, a ogni passo: un’operazione troppo lenta per l’addestramento su GPU. Muon ne usa invece un’approssimazione tramite un’iterazione di Newton-Schulz, una ricorrenza matriciale che converge verso la componente ortogonale di una matrice usando soltanto moltiplicazioni tra matrici, eseguite in modo efficiente a bassa precisione bfloat16 sui tensor core delle GPU. L’implementazione di Jordan usa una variante quintica, cioè di quinto ordine, di Newton-Schulz con coefficienti fissi (a, b, c) = (3,4445, −4,7750, 2,0315), applicata in genere cinque volte per aggiornamento.
Il costo aggiuntivo è modesto: secondo Jordan, l’ortogonalizzazione incide per circa lo 0,5–0,7% dei FLOP totali di addestramento nelle esecuzioni su scala NanoGPT e Llama-405B. Nel benchmark di velocità NanoGPT, Muon ha ridotto di 1,35 volte il tempo effettivo necessario a raggiungere una loss di validazione prestabilita rispetto al precedente record basato su AdamW, e ha anche stabilito il record di velocità tuttora imbattuto su CIFAR-10.
In un confronto da 1,5 miliardi di parametri riportato internamente, Muon ha raggiunto su HellaSwag prestazioni pari a quelle di GPT-2 XL in 10 ore su 8 GPU H100, contro le 13,3 ore impiegate da AdamW sullo stesso hardware.
| Benchmark | Muon | AdamW |
|---|---|---|
| Record di velocità NanoGPT (tempo effettivo fino a una loss prestabilita) | 1,35 volte più veloce | riferimento |
| Esecuzione da 1,5 miliardi di parametri, 8×H100 | 10 ore | 13,3 ore |
| Throughput di Kimi K2, GB300 NVL72, MXFP8 (il dato di Muon include i FLOP dell’ottimizzatore) | 1.080 TFLOPs/s/GPU | 1.051 TFLOPs/s/GPU |
| Efficienza computazionale secondo le leggi di scala di Moonshot | ~2 volte | riferimento |
Perché Adam(W) ha dominato per un decennio e dove incontra difficoltà su larga scala
La longevità di AdamW dipendeva da un compromesso davvero valido: tassi di apprendimento adattivi per ciascun parametro, ottenuti tramite stime aggiornate del primo e del secondo momento, decadimento dei pesi disaccoppiato e un patrimonio di conoscenze ingegneristiche — warmup del tasso di apprendimento, gradient clipping, schemi WSD — accumulato in un decennio di addestramenti in produzione. Nulla di tutto questo, però, rendeva AdamW economico.
È noto che i suoi momenti adattivi sono soggetti a instabilità che si aggravano man mano che i modelli e i budget di token superano la soglia del bilione di parametri e dei molti bilioni di token a cui operano gli attuali modelli mixture-of-experts di frontiera. È proprio in questo regime che, in diversi addestramenti preliminari resi pubblici, sono stati segnalati picchi della loss che hanno richiesto rollback manuali e interventi sul tasso di apprendimento.
L’articolo di Moonshot AI del febbraio 2025, «Muon is Scalable for LLM Training», ha affrontato direttamente questo problema di scalabilità: dopo aver aggiunto il decadimento dei pesi alla regola di aggiornamento di Muon e aver regolato l’entità dell’aggiornamento per ciascun parametro in modo da mantenere una scala quadratica media coerente tra parametri matriciali e non matriciali, gli esperimenti del team sulle leggi di scala hanno rilevato che Muon raggiunge un’efficienza computazionale circa «2 volte superiore rispetto ad AdamW» a parità di risorse computazionali impiegate nell’addestramento.
L’articolo presentava anche Moonlight, un modello mixture-of-experts da 3 miliardi/16 miliardi di parametri addestrato con Muon e preaddestrato su 5,7 bilioni di token, come prova di fattibilità dell’impiego di Muon oltre i piccoli esperimenti di ricerca: cinque mesi prima che Kimi K2 portasse la stessa idea alla scala di un bilione di parametri.
Che cos’è MuonClip? La soluzione di Kimi K2 ai punteggi di attenzione che esplodono
Portare Muon alle dimensioni di Kimi K2 ha messo in luce un problema che non era emerso negli addestramenti più piccoli: i logit dell’attenzione tra query e key crescevano senza limite. Poiché gli aggiornamenti ortogonalizzati di Muon modificano le matrici dei pesi con maggiore intensità e in modo più uniforme nelle varie direzioni rispetto ai passi adattivi di Adam, le matrici di proiezione delle query e delle key nelle teste di attenzione potevano spostarsi in un regime in cui il prodotto scalare tra i vettori query e key — il logit grezzo dell’attenzione — esplodeva prima della softmax, producendo NaN o picchi catastrofici della loss.
Il rapporto tecnico di Kimi K2 presenta direttamente la soluzione: «Proponiamo l’ottimizzatore MuonClip, che migliora Muon con una nuova tecnica QK-clip per affrontare l’instabilità dell’addestramento, mantenendo l’elevata efficienza nell’uso dei token di Muon».
QK-Clip interviene a posteriori: anziché imporre un limite ai punteggi di attenzione stessi, riscala i pesi che li hanno prodotti. Per ogni testa di attenzione h, l’algoritmo tiene traccia del massimo logit di attenzione raggiunto durante il passo, S_max^h. Se il valore supera una soglia fissa τ (impostata a 100 per l’intero addestramento di Kimi K2), i pesi delle proiezioni query e key di quella testa vengono riscalati di un fattore γ_h = min(1, τ / S_max^h), applicato come √γ_h a ciascuno tra W_q^h e W_k^h, così che il loro prodotto venga complessivamente ridotto del fattore γ_h.
È fondamentale che questo avvenga come passaggio successivo sui pesi, dopo il normale aggiornamento di Muon: non modifica i calcoli del passaggio in avanti o all’indietro nel passo in cui è stato rilevato il picco, ma vincola soltanto i pesi usati nel passo successivo.
Nell’addestramento di Kimi K2, il limite è intervenuto attivamente per circa il primo 30% dei passi, mantenendo i logit massimi entro la soglia di 100. Poi i punteggi di attenzione si sono assestati spontaneamente su valori stabili intorno a 30 e il limite non è più intervenuto per il resto dell’addestramento su 15,5 bilioni di token.
Nessun picco della loss su 15,5 bilioni di token: perché questo numero conta
«Nessun picco della loss» può sembrare una nota tecnica di poco conto, ma alla scala di un bilione di parametri è quasi tutto ciò che conta. Un picco della loss durante il preaddestramento costringe in genere il team a fermare l’addestramento, tornare a un checkpoint precedente, saltare o riordinare il batch di dati responsabile e, talvolta, abbassare il tasso di apprendimento. Ogni ciclo di recupero consuma ore-GPU che erano già state impiegate nei passi interessati dal picco, e un’instabilità ripetuta può imporre di ricominciare da capo un’intera fase dell’addestramento.
Le analisi retrospettive pubbliche di diversi grandi addestramenti aperti hanno documentato proprio questa sequenza di picchi e recuperi. Completare un addestramento su una scala di bilioni di token senza interventi del genere significa che ciascuno dei 15,5 bilioni di token elaborati da Kimi K2 ha contribuito al modello finale, al primo tentativo, con un programma di addestramento fissato una sola volta all’inizio (tasso di apprendimento costante di 2e-4 per i primi 10 bilioni di token dopo un warmup di 500 passi, seguito da un decadimento cosinusoidale fino a 2e-5 nei restanti 5,5 bilioni) e mai rivisto durante l’addestramento.
È una dichiarazione di riproducibilità oltre che di stabilità: una procedura fissa che un team può ripetere, adattare a nuovo hardware o affidare a un altro laboratorio senza aspettarsi ogni volta un risultato diverso e più soggetto a picchi.
Perché addestrare Kimi K2 costa poco?
Moonshot non ha pubblicato un budget di addestramento sottoposto a revisione contabile per Kimi K2, e i vertici dell’azienda hanno contestato pubblicamente le stime di costo non ufficiali circolate per la successiva variante K2 Thinking, affermando che la cifra «non è un dato ufficiale», perché è difficile separare i costi della ricerca e della sperimentazione da quelli dell’addestramento finale.
Non è stato pubblicato neppure un conteggio indipendente delle ore-GPU del modello di base. Il dato pubblico più vicino riguarda DeepSeek-V3, un modello sparso con un numero simile di parametri attivi (37 miliardi su 671 miliardi): circa 2,8 milioni di ore-GPU H800 per 14,8 bilioni di token, ovvero circa 5,6 milioni di dollari a 2 dollari l’ora, una piccola frazione di quanto dichiarato dai laboratori occidentali all’avanguardia per modelli di scala simile.
Tre fattori concorrono all’efficienza di Kimi K2: secondo lo studio sulle leggi di scala condotto da Moonshot, l’efficienza computazionale di Muon è circa doppia rispetto a quella di AdamW con un addestramento ottimale in termini di calcolo; un’architettura sparsa mixture-of-experts attiva, per ogni token, solo 32,6 miliardi degli 1,04 bilioni di parametri totali del modello; e, come emerge dall’argomento sulla stabilità esposto sopra, l’intero addestramento su 15,5 bilioni di token è stato completato senza i cicli di riavvio e recupero che fanno lievitare, senza dare nell’occhio, il costo computazionale effettivo degli addestramenti meno stabili.
Nessuno dei tre fattori sarebbe di grande aiuto senza gli altri due: un ottimizzatore efficiente nell’uso dei dati serve a poco se diventa instabile su larga scala, e un’architettura sparsa serve a poco se l’ottimizzatore non riesce ad addestrarla in modo affidabile.
L’ottimizzatore Muon contro Adam: chi altro lo ha adottato
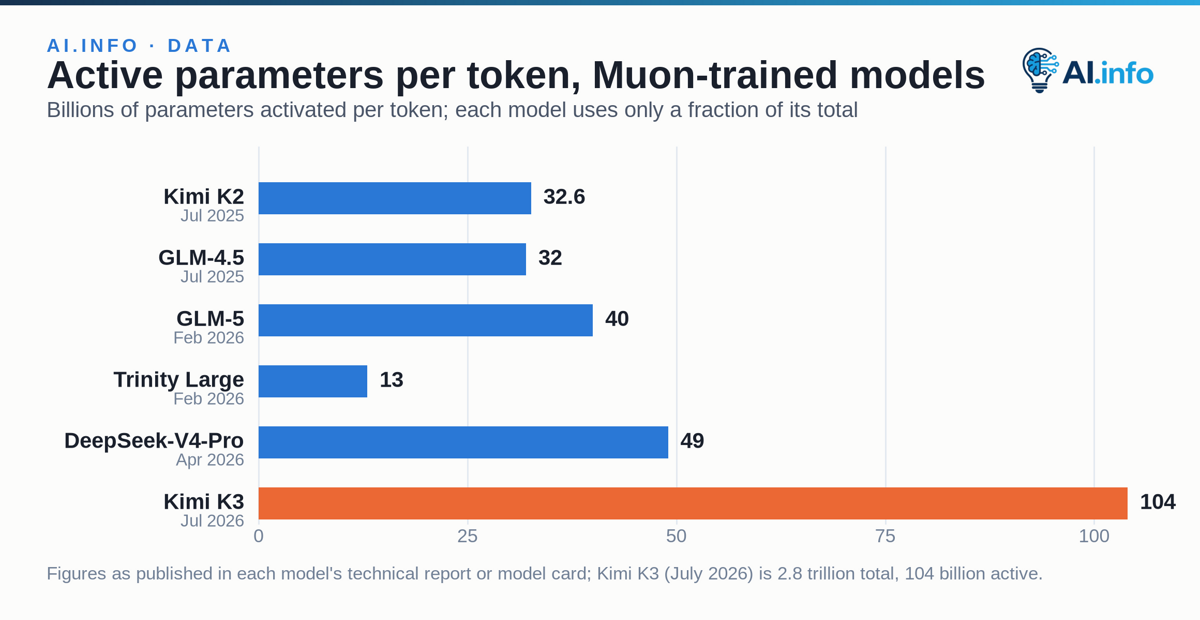
Kimi K2 non è stato l’ultimo a usarlo. GLM-4.5 di Zhipu AI, pubblicato nello stesso mese di Kimi K2, nel luglio 2025, con 355 miliardi di parametri totali e 32 miliardi di parametri attivi, è stato addestrato usando Muon standard per i suoi strati nascosti. Il successivo GLM-5 di Zhipu, pubblicato l’11 febbraio 2026 con 744 miliardi di parametri totali e 40 miliardi di parametri attivi distribuiti su 80 strati e 256 esperti, si è spinto oltre con una variante che il rapporto tecnico chiama Muon Split: le matrici di proiezione vengono suddivise in blocchi più piccoli, uno per testa, prima dell’ortogonalizzazione. Il team ha ritenuto necessario questo passaggio per rendere Muon compatibile con l’attenzione multi-latente di GLM-5 senza una perdita di prestazioni.
DeepSeek ha compiuto lo stesso passaggio con i propri modelli di punta. Il rapporto su DeepSeek-V4, pubblicato su arXiv il 26 aprile 2026, riguarda due modelli — V4-Pro con 1,6 bilioni di parametri totali e 49 miliardi di parametri attivati, V4-Flash con 284 miliardi e 13 miliardi — addestrati su più di 32 bilioni di token usando, nelle parole dell’abstract, «l’ottimizzatore Muon per una convergenza più rapida e una maggiore stabilità dell’addestramento».
Fuori dalla Cina, Trinity Large di Arcee AI — un MoE sparso con circa 400 miliardi di parametri totali e 13 miliardi attivi, addestrato su 2.048 GPU Nvidia B300 e pubblicato in anteprima nel gennaio 2026 — ha usato Muon per gli strati nascosti e AdamW per gli embedding e le proiezioni di output. È la stessa ripartizione raccomandata dalla ricetta originale di Jordan e ne fa uno dei primi modelli addestrati negli Stati Uniti ad adottare questo approccio su larga scala. Il 1° aprile 2026 Arcee ha pubblicato una variante di ragionamento, Trinity-Large-Thinking, con licenza Apache 2.0.
Da allora NVIDIA ha integrato il supporto nativo a Muon in Megatron-Core e NeMo Megatron Bridge. Nei suoi benchmark su GB300 NVL72, l’addestramento con Muon ha raggiunto circa 1.080 TFLOPs/s/GPU includendo il lavoro dell’ottimizzatore, contro 1.051 per AdamW in una configurazione della scala di Kimi K2; il throughput del solo modello era di 1.029 TFLOPs/s/GPU, una lieve perdita di prestazioni nell’addestramento.
| Modello | Pubblicato | Parametri totali | Parametri attivi |
|---|---|---|---|
| Kimi K2 | lug 2025 | 1,04 bilioni | 32,6 miliardi |
| GLM-4.5 | lug 2025 | 355 miliardi | 32 miliardi |
| Kimi K2.5 | gen 2026 | 1 bilione | 32 miliardi |
| GLM-5 | feb 2026 | 744 miliardi | 40 miliardi |
| Trinity Large | gen 2026 | ~400 miliardi | 13 miliardi |
| DeepSeek-V4-Pro | apr 2026 | 1,6 bilioni | 49 miliardi |
| Kimi K2.7-Code | giu 2026 | 1 bilione | 32 miliardi |
| Kimi K3 | lug 2026 | 2,8 bilioni | 104 miliardi |
Muon per testa, Kimi K3 e l’ottimizzatore che insegue Muon
Kimi K3 è arrivato nelle app e nell’API di Moonshot il 16 luglio 2026; i pesi aperti e il rapporto tecnico sono seguiti il 27 luglio, la data indicata dall’azienda. Tra K2 e K3, il laboratorio ha pubblicato tre modelli intermedi da un bilione di parametri: K2.5 il 27 gennaio 2026, K2.6 in aprile e K2.7-Code il 12 giugno.
Il rapporto pubblicato sostituisce le stime circolate in precedenza. K3 è «un modello Mixture-of-Experts da 2,8 bilioni di parametri, con 104 miliardi di parametri attivati, capacità visive native e una finestra di contesto da 1 milione di token», costruito su Kimi Delta Attention e Attention Residuals, con uno strato di instradamento chiamato Stable LatentMoE che attiva 16 dei 896 esperti instradati per token. Secondo Moonshot, il guadagno combinato è «un miglioramento di circa 2,5 volte nell’efficienza complessiva dello scaling rispetto a Kimi K2».
La scelta dell’ottimizzatore ha retto anche a questo salto. K3 addestra i parametri delle matrici con Per-Head Muon, ortogonalizzando separatamente la proiezione di ciascuna testa di attenzione anziché l’intera matrice in una volta sola, insieme al meccanismo di limitazione dei pesi introdotto per Kimi K2. La risposta di Moonshot all’instabilità comprende ancora un vincolo applicato ai pesi dopo l’aggiornamento, oltre all’ortogonalizzazione per testa. K3 è diventato generalmente disponibile su Amazon Bedrock il 18 settembre 2026.
Anche il nuovo ruolo di Muon come ottimizzatore affermato è già messo in discussione. Tilde Research ha pubblicato Aurora nel maggio 2026 dopo aver scoperto che Muon priva silenziosamente una parte della rete degli aggiornamenti necessari: «al passo 500, più di un neurone su quattro è di fatto inattivo», perché le righe deboli di una matrice dei pesi alta continuano a ricevere aggiornamenti deboli. Aurora impone a ogni aggiornamento di essere al tempo stesso ortogonale e uniforme nella norma delle righe, e Tilde lo presenta come un sostituto utilizzabile senza modifiche, con un costo superiore a Muon di circa il 6%.
Un decennio in cui Adam è stato la scelta predefinita si è concluso con un modello da un bilione di parametri il cui addestramento non ha avuto picchi improvvisi. Quattordici mesi dopo, l’ottimizzatore che ha messo fine a quel primato è quello che viene corretto.