Approfondimenti tecnici
Mixture of Experts: far crescere i modelli di IA in modo efficiente
Come Mixture of Experts permette a un modello di contenere migliaia di miliardi di parametri attivandone solo una piccola percentuale per token: l’instradamento, il bilanciamento del carico e i calcoli sulla memoria alla base di DeepSeek-V4
AI.info Team ·
Attivazione sparsa: l’idea di fondo
I transformer densi standard applicano la stessa rete feed-forward (FFN) a ogni token, perciò il numero di parametri e il calcolo per token crescono insieme: se si allarga la FFN, si paga il costo di quella maggiore ampiezza per ogni singolo token che la attraversa. Mixture of Experts (MoE) spezza questo legame. Anziché una sola FFN per livello, un livello MoE contiene molte FFN parallele, dette esperti, e un piccolo router che decide quale sottoinsieme di esperti elaborerà ciascun token.
Il numero totale di parametri cresce con il numero di esperti, ma il calcolo per token cresce solo in funzione degli esperti effettivamente selezionati. Un modello può contenere centinaia di miliardi di parametri pur svolgendo il lavoro aritmetico di un modello più piccolo di un ordine di grandezza.
L’idea di indirizzare gli input verso sottoreti specializzate risale al lavoro del 1991 di Jacobs, Jordan, Nowlan e Hinton sulle miscele adattive di esperti locali, ma il livello mixture-of-experts con gating sparso di Google l’ha resa praticabile per la modellazione linguistica su larga scala in cluster di GPU, con un massimo di 137 miliardi di parametri. Due articoli hanno definito lo schema moderno: GShard (Lepikhin et al., 2020) e Switch Transformer (Fedus, Zoph e Shazeer, 2021).
Il router: gating e selezione top-k
Ogni livello MoE sostituisce (o affianca) una FFN densa con N FFN esperte e un router. Per un token con rappresentazione nascosta x, il router calcola i logit mediante una proiezione appresa, logits = x · W_g; una softmax applicata a quei logit produce una distribuzione di probabilità tra gli N esperti. Il router conserva solo i k valori più alti (di norma k=1 o k=2), azzera gli altri e rinormalizza le probabilità conservate, ottenendo i pesi di gating g_i. L’output del livello è la somma ponderata dei soli esperti selezionati:
y = Σ (i in top-k) g_i · E_i(x)
È la selezione top-k a produrre la sparsità. Se k fosse uguale a N, ogni esperto verrebbe eseguito per ogni token: una miscela densa, senza alcun risparmio di calcolo e con soltanto parametri aggiuntivi. Limitare ciascun token a un numero piccolo e fisso di esperti, indipendentemente dal numero totale di esperti, è ciò che mantiene costanti i FLOPs per token al crescere del numero di esperti.
La semplificazione centrale di Switch Transformer è stata portare k a 1: un solo esperto gestisce ciascun token. Fedus, Zoph e Shazeer hanno mostrato che questo «instradamento a un solo esperto» preservava la qualità del modello, riducendo al contempo il calcolo del router e la comunicazione tra dispositivi rispetto all’impostazione top-2 predefinita di GShard. Ha inoltre permesso loro di portare i modelli encoder-decoder basati su T5 oltre i mille miliardi di parametri, addestrando parti della rete in bfloat16. Il loro articolo riporta un miglioramento fino a 7x nella velocità di preaddestramento rispetto ai modelli di riferimento T5-Base e T5-Large, a parità di calcolo.
GShard, precedente a Switch Transformer, usava un instradamento top-2: il token viene inviato all’esperto con il punteggio più alto, nei limiti della capacità dell’esperto, e un secondo esperto viene scelto in modo stocastico, con una probabilità proporzionale al peso di gating che gli è assegnato. È un passaggio di «instradamento casuale» pensato per preservare la capacità degli esperti saltando talvolta il secondo. Google ha usato la suddivisione automatica degli operatori di GShard per portare oltre i 600 miliardi di parametri un Transformer per la traduzione automatica multilingue con livelli MoE a gating sparso, addestrandolo su 2.048 acceleratori TPU v3 in quattro giorni. Il risultato ha dimostrato che la suddivisione di un MoE poteva essere gestita in larga misura tramite annotazioni per il compilatore, anziché con codice scritto a mano per il parallelismo.
| Sistema | Parametri totali | Esperti (top-k) | Innovazione nell’instradamento |
|---|---|---|---|
| GShard | 600B+ | top-2 | Instradamento stocastico del secondo esperto |
| Switch Transformer | 1T+ | top-1 | Instradamento verso un solo esperto, preaddestramento fino a 7x più veloce |
| DeepSeek-V3 | 671B | 256 (top-8) | Bilanciamento del carico senza funzione di perdita ausiliaria |
| GLM-5.3 | 753B | 256 (top-8) + 1 condiviso | La stessa configurazione 256/top-8, cinque anni dopo GShard |
| Kimi K3 | 2.8T | 896 (top-16) + 2 condivisi | Granularità spinta fino a quasi 900 esperti |
Bilanciamento del carico: perché ai router serve un guinzaglio
Un router ingenuo finisce per collassare a causa delle proprie dinamiche: se alcuni esperti ricevono gradienti leggermente migliori nelle prime fasi dell’addestramento, attirano più token, vengono aggiornati più spesso e diventano ancora più appetibili per il router. È un circolo vizioso in cui chi è avvantaggiato accumula altro vantaggio: la maggior parte degli esperti resta poco addestrata, mentre pochi diventano colli di bottiglia. Poiché la capacità di calcolo viene predisposta in anticipo per ciascun esperto sotto forma di capacità fissa, gli esperti sovraccarichi iniziano anche a scartare i token quando la superano:
capacity = (tokens_per_batch / num_experts) × capacity_factor
Un fattore di capacità pari a 1,0 assegna a ogni esperto esattamente la sua quota uniforme di token; Switch Transformer ha rilevato che un fattore intorno a 1,25 — un margine del 25% rispetto alla quota nominale — manteneva il tasso di token scartati sotto l’1%, al prezzo di maggiori costi di calcolo e comunicazione. I token che arrivano quando un esperto ha esaurito la propria capacità vengono scartati e attraversano invece il livello tramite una connessione residua. Questo comporta un costo reale e misurabile in termini di qualità, che cresce all’aumentare dello squilibrio nell’instradamento.
La soluzione standard allo squilibrio di fondo consiste nell’aggiungere all’obiettivo di addestramento una funzione di perdita ausiliaria per il bilanciamento del carico. La formulazione di Switch Transformer/GShard calcola, per ciascun batch, la frazione di token instradati a ogni esperto (f_i) e la massa di probabilità media che il router assegna a quell’esperto (P_i), quindi penalizza la somma, su tutti gli esperti, dei prodotti tra queste due grandezze:
L_aux = α · N · Σ_i f_i · P_i
Il termine è minimo quando i token e la massa di probabilità del router sono distribuiti uniformemente tra tutti gli N esperti; la moltiplicazione per N ne mantiene la scala pressoché indipendente dal numero di esperti, mentre α è un piccolo coefficiente che regola il compromesso tra bilanciamento del carico e perdita relativa al compito.
DeepSeek-V3 ha seguito una strada diversa per raggiungere lo stesso obiettivo: una strategia di bilanciamento senza funzione di perdita ausiliaria. Anziché affidarsi principalmente a un termine di gradiente concorrente nella funzione di perdita, aggiunge un bias dinamico al punteggio di instradamento di ciascun esperto prima della selezione top-k e lo modifica dopo ogni passo in base a quanto l’esperto sia stato sovrautilizzato o sottoutilizzato di recente, indirizzando così il traffico verso gli esperti meno utilizzati. A questo si affianca soltanto una funzione di perdita complementare per il bilanciamento a livello di sequenza, con un peso estremamente ridotto, per evitare squilibri estremi all’interno delle singole sequenze.
Il quadro delle architetture: modelli MoE realmente impiegati
Mixtral 8x7B, descritto nel paper «Mixtral of Experts» di Mistral AI, è il modello che ha portato i MoE sparsi alla ribalta fuori dai laboratori di ricerca. Ogni livello transformer sostituisce la propria FFN con 8 esperti e un router che seleziona i 2 migliori per ciascun token. Il modello ha circa 46,7 miliardi di parametri totali, ma poiché per ogni token si attivano solo 2 degli 8 esperti, un passaggio in avanti costa all’incirca quanto quello di un modello denso da ~13 miliardi di parametri. Mistral ha riferito che Mixtral eguagliava o superava Llama 2 70B e GPT-3.5 nella maggior parte dei benchmark, nonostante il numero molto inferiore di parametri attivi. Entrambi i modelli usati per il confronto sono stati poi ritirati: oggi quell’affermazione è un’etichetta da museo, ma contribuì a portare i MoE sparsi fuori dai laboratori di ricerca e dentro i prodotti.
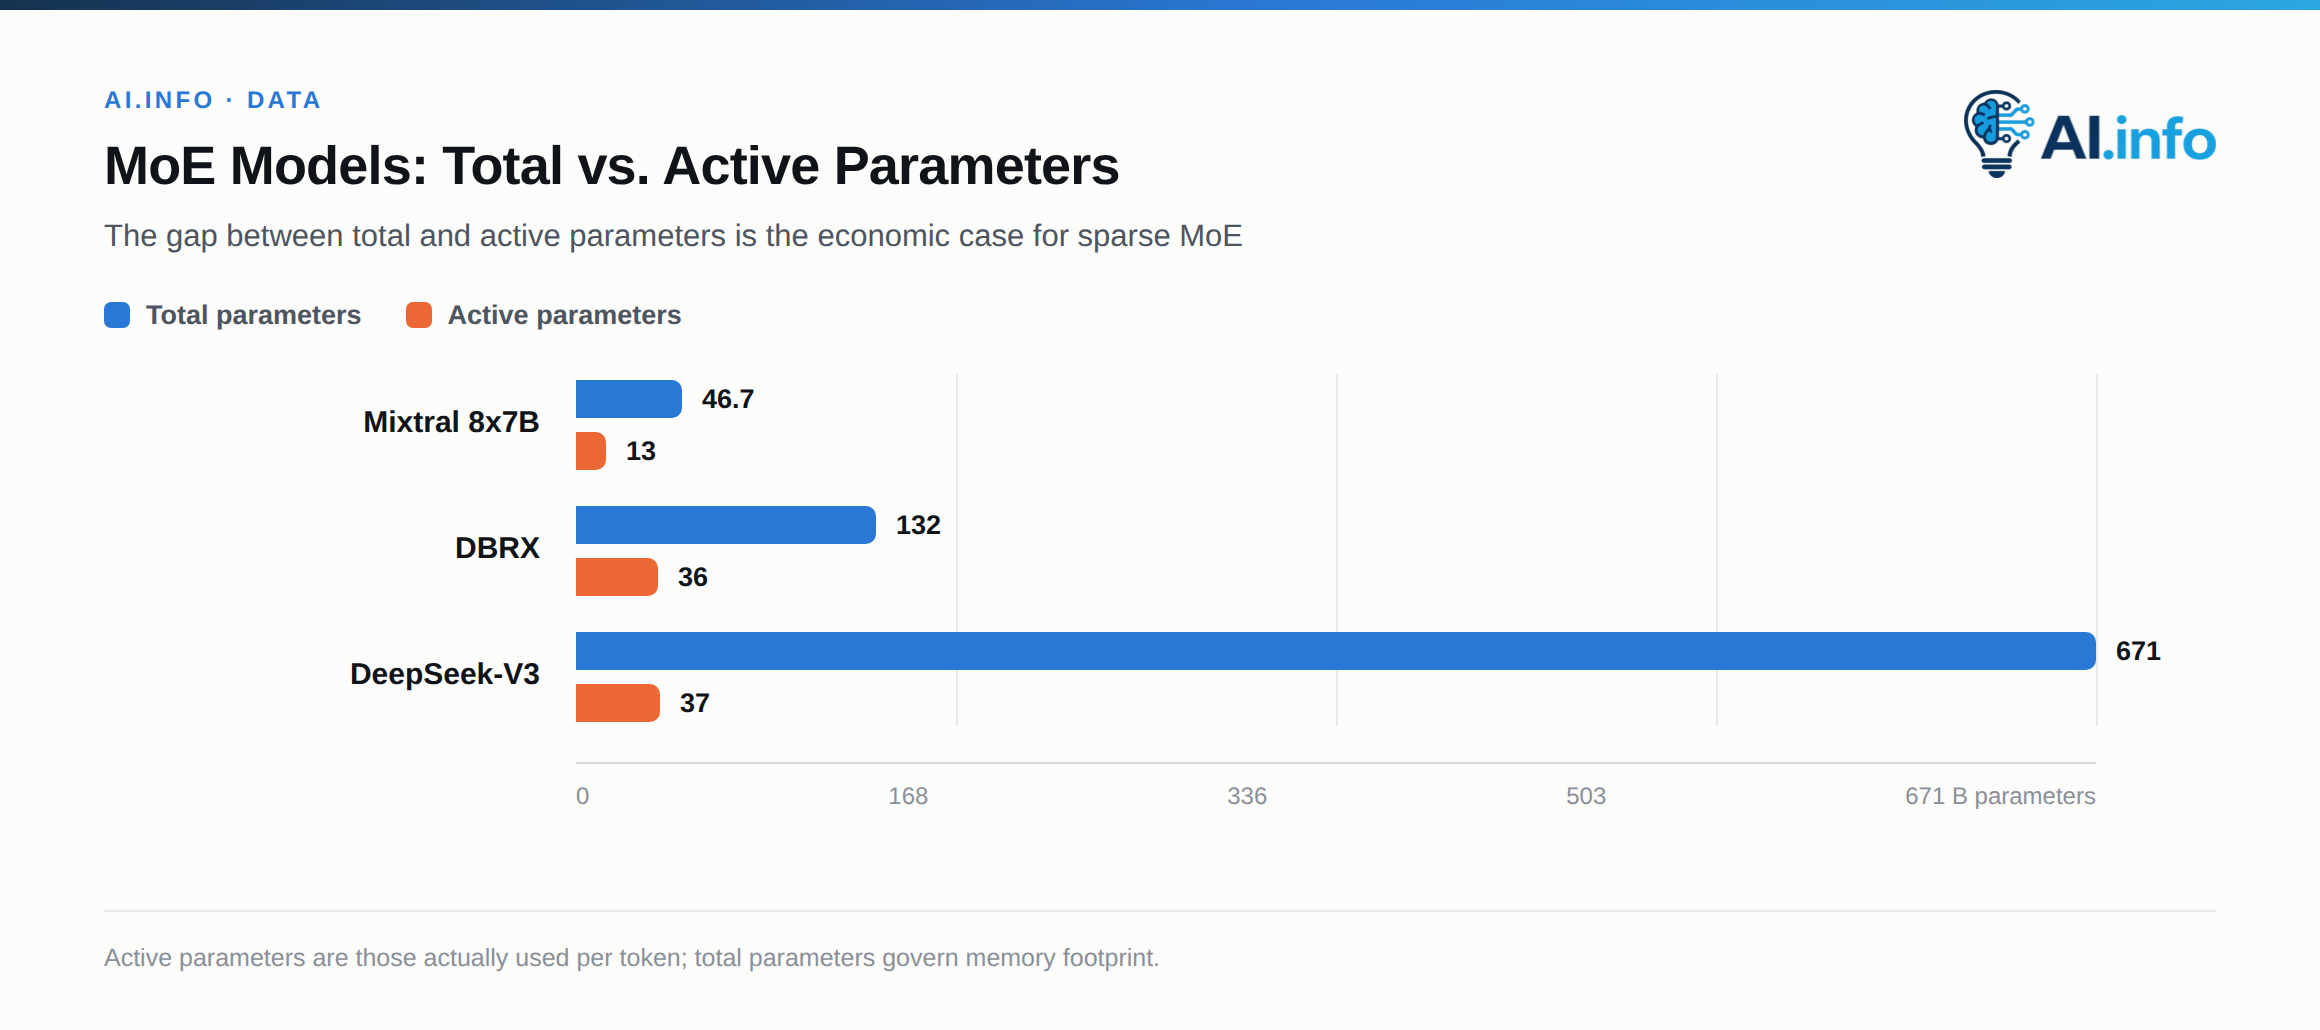
DeepSeek-MoE e DeepSeek-V3 hanno spinto oltre la granularità. Anziché usare pochi esperti di grandi dimensioni, l’architettura di DeepSeek segmenta gli esperti in modo più fine, suddividendo i parametri destinati alla FFN tra molti esperti più piccoli. Ne designa inoltre un sottoinsieme come esperti condivisi, sempre attivi per ogni token, separando le conoscenze comuni (grammatica, sintassi generale) da quelle specialistiche acquisite dagli esperti selezionati tramite instradamento. DeepSeek-V3 porta questo schema a 671 miliardi di parametri totali, distribuiti fra 256 esperti soggetti a instradamento (gli 8 migliori selezionati per ogni token), più gli esperti condivisi, attivando circa 37 miliardi di parametri per token.
È stato preaddestrato su 14,8 bilioni di token e, secondo il rapporto tecnico di DeepSeek, l’intero addestramento ha richiesto circa 2,79 milioni di ore di GPU H800: un dato ampiamente citato come prova del fatto che addestrare un MoE ben progettato può costare molto meno che addestrare un modello denso di qualità comparabile.
Da allora DeepSeek è andata avanti di due generazioni. V4 è stato presentato in anteprima il 24 aprile 2026: V4-Pro ha 1,6 bilioni di parametri totali e 49 miliardi di parametri attivi, V4-Flash ne ha 284 miliardi totali e 13 miliardi attivi. Entrambi sono distribuiti con licenza MIT e hanno un contesto predefinito di un milione di token. La scheda del modello V4-Pro riporta più di 32 bilioni di token di preaddestramento e un risultato dell’80,6 per cento su SWE-bench Verified.
Grok-1, rilasciato da xAI con licenza Apache 2.0 nel marzo 2024, dopo la conclusione del preaddestramento nell’ottobre 2023, è un MoE da 314 miliardi di parametri con 8 esperti, 2 dei quali (25%) si attivano per token. La sua architettura è vicina allo schema di Mixtral, che seleziona 2 esperti su 8, ma ha un numero totale di parametri circa sette volte maggiore. Al momento del rilascio fu descritto come il più grande modello MoE rilasciato pubblicamente.
DBRX, rilasciato da Databricks nel marzo 2024, ha affrontato la granularità in modo opposto rispetto a Mixtral: 16 esperti, di cui 4 selezionati per token, anziché 2 su 8. Questo offre molte più combinazioni possibili di esperti per un dato token rispetto a un’architettura a granularità più grossolana. DBRX ha in totale 132 miliardi di parametri, di cui 36 miliardi attivi, ed è stato preaddestrato su 12 bilioni di token.
La frontiera dei modelli a pesi aperti nel 2026 ha spostato i punti di riferimento dell’architettura. Kimi K3 di Moonshot AI, annunciato il 16 luglio 2026, ha 2,8 bilioni di parametri totali e ne attiva circa 104 miliardi per token, instradando ciascun token verso 16 degli 896 esperti, oltre a due esperti condivisi: è il più grande modello a pesi aperti rilasciato finora. GLM-5.3 di Z.ai, reso disponibile a pesi aperti nell’agosto 2026, è un modello da 753 miliardi di parametri con 256 esperti soggetti a instradamento, selezione degli 8 migliori e un esperto condiviso. Z.ai non pubblica il numero di parametri attivi; Artificial Analysis lo stima in circa 40 miliardi. Qwen3.8-Max di Alibaba, rilasciato il 3 agosto 2026 e reso disponibile a pesi aperti a determinate condizioni il 12 agosto come Qwen3.8-2.4T-A95B, ha 2,4 bilioni di parametri totali e circa 95 miliardi attivi.
Tutti questi modelli seguono uno schema comune: ciascuno usa una variante dell’instradamento top-k appreso, con un meccanismo esplicito di bilanciamento del carico. È un’indicazione che la soluzione adottata da GShard/Switch Transformer si è generalizzata ben oltre gli esperimenti originali di Google. A cambiare è stato il grado di sparsità. Nei modelli del 2023-24, il rapporto tra parametri attivi e totali si collocava tra circa 1:4 e 1:18; in quelli del 2026 va da circa 1:19 (GLM-5.3) a 1:33 (DeepSeek-V4-Pro), con Kimi K3 intorno a 1:27. La sparsità è all’incirca raddoppiata in due anni e il numero di esperti è aumentato da tre a quattro volte.
Perché i parametri non crescono più insieme ai FLOPs
L’argomento a favore dell’efficienza distingue due aspetti che la crescita dei modelli densi tiene legati: capacità rappresentativa e costo computazionale. In un transformer denso, aggiungere parametri alla FFN significa che ogni token comporta il costo di quei parametri a ogni passaggio in avanti: capacità e FLOPs crescono quindi di pari passo. In un livello MoE, aggiungere esperti aumenta la capacità — il numero di sottoreti FFN distinte in cui il modello può specializzarsi — senza modificare i FLOPs necessari per un token che ne attraversa solo k. Raddoppiare il numero di esperti mantenendo k fisso raddoppia all’incirca i parametri totali, ma lascia invariato il calcolo per token.
È per questo che i paper sui MoE riportano separatamente, tra i dati principali, il numero di parametri totali e quello dei parametri attivi. I parametri totali determinano la memoria necessaria e, stando alle osservazioni empiriche, il grado di specializzazione raggiungibile dal modello e quanto può scendere la sua loss sui dati esclusi dall’addestramento a parità di risorse computazionali impiegate per addestrarlo. I parametri attivi determinano la latenza dell’inferenza, il throughput nell’erogazione del servizio e i FLOPs spesi per ogni token di addestramento. Un modello MoE ben addestrato tende ad avvicinarsi alla qualità di un modello denso le cui dimensioni corrispondono al suo numero di parametri totali, pur eseguendo l’inferenza a un costo più vicino a quello corrispondente ai suoi parametri attivi: la distanza tra i due numeri è l’intera ragione economica a favore di questa architettura.
Inferenza e memoria: quando arriva il conto
Il risparmio in FLOP è reale, ma comporta un costo in termini di memoria che la crescita dei modelli densi non deve sostenere. I pesi di ogni esperto devono risiedere in una memoria accessibile, di norma la HBM delle GPU, anche quando quell’esperto non viene utilizzato in una determinata passata in avanti: non si può sapere in anticipo a quali esperti verrà instradato un batch di token. Un modello MoE da 671 miliardi di parametri, di cui 37 miliardi attivi, ha comunque bisogno di memoria aggregata sufficiente a contenere tutti i 671 miliardi di parametri, non soltanto i 37 miliardi attivi, anche se per ogni token viene eseguito un calcolo corrispondente a soli 37 miliardi di parametri. Questo ribalta il consueto collo di bottiglia degli acceleratori: l’inferenza dei modelli MoE richiede relativamente poco calcolo e molta memoria. Kimi K3 è stato distribuito come checkpoint nativo a quattro bit: 2,8 bilioni di parametri, a circa mezzo byte ciascuno, equivalgono a circa 1,4 TB di pesi prima ancora di considerare la cache KV. È quindi necessario un deployment su più nodi, non basta un singolo server.
La soluzione standard è il parallelismo degli esperti: gli esperti vengono distribuiti tra più dispositivi, ciascuno dei quali contiene un sottoinsieme delle FFN degli esperti e una copia completa dei parametri non appartenenti agli esperti (livelli di attenzione, embedding e normalizzazioni dei livelli). Durante una passata in avanti, i token vengono inviati attraverso la rete al dispositivo che ospita l’esperto selezionato, elaborati lì e poi i risultati vengono raccolti: per ogni livello MoE servono due operazioni collettive di comunicazione all-to-all, una per distribuire i token ai rispettivi esperti e una per riportare i risultati ai dispositivi richiedenti.
Poiché questa comunicazione avviene a ogni livello MoE, la larghezza di banda dell’interconnessione — NVLink all’interno di un nodo, InfiniBand o tecnologie simili tra nodi — diventa importante per il throughput nell’erogazione del modello quanto la capacità di calcolo.
Un secondo costo, meno evidente, è lo squilibrio del carico durante l’inferenza, anziché durante l’addestramento. Se un batch di richieste reali viene instradato in larga misura verso un piccolo sottoinsieme di esperti — una possibilità plausibile, dato che l’instradamento è correlato ai contenuti e il traffico in tempo reale non è distribuito come un corpus di addestramento mescolato casualmente — i dispositivi che ospitano quegli esperti rallentano l’intero processo mentre gli altri restano inattivi. La latenza complessiva è quindi determinata dal dispositivo più lento, non da quello medio.
I sistemi progettati per erogare modelli MoE, come DeepSpeed-MoE di Microsoft, affrontano il problema con tecniche che comprendono la collocazione consapevole degli esperti e la pianificazione delle comunicazioni, concepite per ridurre il costo di questi scambi all-to-all anziché limitarsi a tollerarlo.
Che cosa significa per la progettazione dei modelli
Per chi deve scegliere o distribuire un modello MoE, i due numeri principali rispondono a domande diverse. Il numero totale di parametri indica quanta memoria hardware occorre predisporre e, approssimativamente, quanta varietà di compiti e quante conoscenze del mondo il modello può codificare. Il numero di parametri attivi indica quali livelli di latenza e throughput aspettarsi e quale budget di calcolo sia stato probabilmente impiegato per ogni token di addestramento. Kimi K3, con 2,8T parametri totali e 104 miliardi attivi, e Mixtral, con 46,7 miliardi totali e 12,9 miliardi attivi, sono entrambi modelli «MoE», ma si collocano agli estremi opposti del rapporto tra memoria e calcolo: un fabbisogno di memoria 60 volte maggiore a fronte di una quantità di calcolo per token 8 volte maggiore. Nessuno dei due numeri, da solo, descrive il costo reale del deployment.
La granularità è a sua volta una scelta progettuale. Pochi esperti di grandi dimensioni selezionati con un top-k ristretto — 2 su 8 per Mixtral e 2 su 8 per Grok-1 — offrono un’architettura semplice e mantengono gestibile la distribuzione all-to-all dei token. Molti esperti piccoli selezionati con un top-k più ampio — 8 su 256 per DeepSeek-V3 e GLM-5.3, 4 su 16 per DBRX e 16 su 896 per Kimi K3 — offrono al router molte più combinazioni per la specializzazione e possono ridurre la perdita a parità di parametri attivi, al prezzo di una gestione più complessa e di un maggior numero di destinazioni distinte a cui inviare i token.
L’approccio al bilanciamento senza perdita ausiliaria reso popolare da DeepSeek-V3 suggerisce che la ricerca stia ancora lavorando attivamente su come mantenere efficace quella specializzazione senza che un segnale di gradiente concorrente contrasti l’obiettivo principale dell’addestramento. L’instradamento e il bilanciamento del carico, più del semplice numero di esperti, restano gli aspetti della progettazione dei modelli MoE che hanno maggiori probabilità di cambiare nei modelli successivi.