Approfondimenti tecnici
Modelli linguistici di grandi dimensioni: architettura, addestramento e scalabilità
Come vengono costruiti i modelli linguistici di grandi dimensioni: dalla tokenizzazione byte-pair e dall’attenzione con prodotto scalare scalato alle leggi di scalabilità di Chinchilla, all’RLHF e alle miscele sparse di esperti con mille mi
AI.info Team ·
L’architettura: attenzione senza ricorrenza
La storia dei moderni LLM comincia con una singola sostituzione architetturale. «Attention Is All You Need» (Vaswani et al., 2017, NeurIPS) sostituì le architetture ricorrenti e convoluzionali che avevano dominato la modellazione delle sequenze — LSTM, GRU, ConvS2S — con un meccanismo basato interamente sull’attenzione. L’operazione fondamentale è l’attenzione con prodotto scalare scalato:
Attention(Q, K, V) = softmax(QKᵀ / √d_k) V
Query, chiavi e valori sono proiezioni lineari degli embedding di input o degli output degli strati precedenti; la softmax applicata a QKᵀ produce una distribuzione sulle posizioni che ciascun token usa per aggregare informazioni dal resto della sequenza. Poiché ogni token può prestare attenzione a ogni altro token in un’unica operazione, il transformer consente di parallelizzare l’elaborazione lungo la dimensione della sequenza in un modo impossibile per le reti ricorrenti: le RNN elaborano i token in successione, perciò il tempo di addestramento cresce con la lunghezza della sequenza in un modo che mal si presta alla parallelizzazione sulle GPU.
L’articolo originale riportava un punteggio di 28,4 BLEU nella traduzione dall’inglese al tedesco del WMT 2014, con un vantaggio di oltre 2 punti BLEU rispetto al miglior risultato precedente, ottenuto impiegando una potenza di calcolo per l’addestramento sostanzialmente inferiore a quella dei sistemi ricorrenti e convoluzionali concorrenti.
L’altro contributo fondamentale dell’articolo, l’attenzione multi-head, esegue in parallelo più operazioni di attenzione su diverse proiezioni apprese di Q, K e V, poi ne concatena i risultati. Ogni head può specializzarsi: nei transformer addestrati, alcune prestano attenzione ai token adiacenti, altre alle dipendenze sintattiche o alle catene di coreferenza. Poiché l’attenzione non ha una nozione intrinseca dell’ordine, l’architettura originale aggiungeva codifiche posizionali sinusoidali agli embedding di input, affinché il modello potesse distinguere «il cane morde l’uomo» da «l’uomo morde il cane».
Da questo progetto discendono due famiglie architetturali. I modelli solo encoder come BERT (Devlin et al., 2018) usano la self-attention bidirezionale e vengono addestrati con obiettivi di modellazione del linguaggio mascherata, adatti ai compiti di classificazione e rappresentazione. I modelli solo decoder — la famiglia GPT a partire da GPT-1, LLaMA, Mistral e la maggior parte degli LLM contemporanei orientati alla conversazione — usano la self-attention causale (mascherata), in cui ogni posizione può prestare attenzione soltanto a sé stessa e alle posizioni precedenti, e vengono addestrati a prevedere il token successivo in modo autoregressivo. L’architettura solo decoder ha prevalso per gli LLM generativi di uso generale perché un’unica sequenza di strati con attenzione causale supporta sia il preaddestramento sia la generazione, senza una discontinuità architetturale tra codifica e decodifica.
Tokenizzazione: dal testo ai numeri interi
Prima di qualsiasi calcolo dell’attenzione, il testo grezzo deve diventare una sequenza di numeri interi. La Byte Pair Encoding (BPE), in origine una tecnica di compressione dei dati ideata da Philip Gage (1994), fu adattata alla traduzione automatica neurale da Sennrich, Haddow e Birch (2016). Il loro algoritmo parte dai singoli caratteri (o byte) e unisce iterativamente la coppia adiacente più frequente in un nuovo simbolo, ripetendo l’operazione fino a raggiungere la dimensione desiderata del vocabolario.
Le parole comuni diventano singoli token; quelle rare o mai incontrate vengono scomposte in unità sublessicali più piccole, già viste in precedenza. Questo elimina il problema delle parole fuori vocabolario, dovuto al vocabolario fisso, che affliggeva i precedenti modelli basati su parole intere. La BPE e le sue varianti più vicine (la BPE a livello di byte, usata da GPT-2 e dai suoi discendenti; SentencePiece, usato da molti modelli multilingue e aperti) sono oggi alla base dei tokenizzatori di GPT-2, GPT-3, GPT-4, RoBERTa, LLaMA e di quasi tutti gli LLM distribuiti in produzione da allora.
La tokenizzazione non è un passaggio preliminare puramente formale: influisce direttamente sul comportamento del modello. La dimensione del vocabolario comporta un compromesso con la lunghezza della sequenza: un vocabolario più ampio comprime più testo in meno token (riducendo il costo dell’attenzione, che cresce con la lunghezza della sequenza), ma ingrandisce le matrici degli embedding e della proiezione in output. I confini tra i token spiegano anche peculiarità ben documentate degli LLM, come le scarse prestazioni nell’aritmetica a livello di carattere o nello spelling: il modello, infatti, non vede mai direttamente i singoli caratteri, ma unità sublessicali opache.
Obiettivi del preaddestramento e pipeline dei dati
Gli LLM solo decoder vengono preaddestrati con un unico obiettivo, solo in apparenza semplice: data una sequenza di token, prevedere quello successivo, minimizzando la perdita di entropia incrociata calcolata in media su un corpus enorme. È lo stesso obiettivo usato da GPT-1 (Radford et al., 2018), quando dimostrò che il preaddestramento non supervisionato seguito dal fine-tuning supervisionato dava risultati migliori dell’addestramento da zero di architetture specifiche per ciascun compito.
GPT-2 (Radford et al., 2019) spinse oltre la stessa impostazione e mostrò che modelli sufficientemente grandi addestrati a prevedere il token successivo svolgono molti compiti a valle in modalità zero-shot, senza alcun fine-tuning specifico per il compito: basta fornire loro un prompt adeguato. GPT-3 (Brown et al., 2020) portò questa impostazione a 175 miliardi di parametri e dimostrò una forte capacità di apprendimento few-shot nel contesto: fornire nel prompt una manciata di esempi di input e output, senza aggiornare i gradienti, era sufficiente per raggiungere prestazioni competitive nella traduzione, nella risposta alle domande e nei compiti di tipo aritmetico.
I modelli solo encoder usano un obiettivo diverso. BERT viene addestrato con la modellazione del linguaggio mascherata (prevedendo token mascherati casualmente a partire dal contesto bidirezionale) e, nell’articolo originale, anche con un compito ausiliario di previsione della frase successiva. La bidirezionalità rende i modelli in stile BERT efficaci nell’apprendimento di rappresentazioni per la classificazione e il recupero di informazioni, ma inadatti alla generazione autoregressiva senza vincoli. È uno dei motivi per cui l’impostazione solo decoder, basata sulla previsione del token successivo, è diventata il paradigma dominante per gli LLM di uso generale.
Leggi di scala: rendere prevedibile la costruzione dei modelli
Forse il risultato empirico più importante in questo campo è che la loss durante il pretraining varia in modo prevedibile al variare della scala. Kaplan et al. (2020), in «Scaling Laws for Neural Language Models», hanno mostrato che la loss di entropia incrociata segue una legge di potenza in funzione delle dimensioni del modello, delle dimensioni del dataset e delle risorse di calcolo. La relazione regge per oltre sette ordini di grandezza, mentre dettagli architetturali come il rapporto tra profondità e ampiezza contano relativamente poco entro un ampio intervallo. Una forma semplificata della relazione è:
L(N) ≈ (N_c / N)^α
dove N è il numero di parametri e α è un esponente stimato empiricamente, ben inferiore a 1: i rendimenti diminuiscono, ma in modo prevedibile anziché irregolare. La conclusione pratica dell’analisi di Kaplan era che, a parità di budget di calcolo, è più efficiente addestrare modelli molto grandi su quantità di dati relativamente modeste e fermarsi ben prima della convergenza, anziché portare un modello più piccolo alla piena convergenza.
Hoffmann et al. (2022), nel paper di DeepMind su Chinchilla («Training Compute-Optimal Large Language Models»), hanno rivisto questa conclusione. Addestrando oltre 400 modelli, da 70 milioni a più di 16 miliardi di parametri, su quantità comprese tra 5 e 500 miliardi di token, e verificando il risultato con tre metodi di stima indipendenti, gli autori hanno scoperto che, per sfruttare in modo ottimale le risorse di calcolo, le dimensioni del modello e il numero di token di addestramento devono crescere a ritmi più o meno uguali. Come regola pratica, occorrono circa 20 token di addestramento per parametro.
Secondo le leggi di scala di Kaplan, modelli dell’epoca come Gopher (280B parametri) erano stati addestrati troppo poco rispetto alle loro dimensioni. Per verificare la legge rivista, DeepMind ha addestrato Chinchilla, un modello da 70B parametri, su 1,4 trilioni di token, con lo stesso budget di calcolo di Gopher. Chinchilla ha superato Gopher, un modello quattro volte più grande, in un’ampia serie di valutazioni ed era anche meno costoso da usare in fase di inferenza, dato che il costo dell’inferenza cresce con il numero di parametri, non con quello dei token di addestramento.
Quel risultato ha riorientato il settore: LLaMA (Touvron et al., 2023) si è basato esplicitamente sull’impostazione di Chinchilla, addestrando modelli più piccoli (7B–65B parametri) su più token di quanti ne avrebbero raccomandati le precedenti leggi di scala. Gli autori hanno riferito che LLaMA-13B superava il GPT-3 da 175B nella maggior parte dei benchmark e che LLaMA-65B era competitivo con Chinchilla-70B e PaLM-540B.
| Modello | Parametri | Risultato principale |
|---|---|---|
| GPT-3 (2020) | 175B | Riferimento per l’apprendimento in contesto con pochi esempi |
| Gopher | 280B | Addestrato troppo poco rispetto alle sue dimensioni, secondo l’analisi di Chinchilla |
| Chinchilla (2022) | 70B, 1,4T token | Ha superato Gopher, 4 volte più grande, a parità di risorse di calcolo |
| LLaMA-13B (2023) | 13B | Ha superato il GPT-3 da 175B nella maggior parte dei benchmark |
| Mixtral 8x7B (2023) | 47B totali / 13B attivi | Ha eguagliato o superato Llama 2 70B e GPT-3.5 nella maggior parte dei benchmark |
| DeepSeek-V4-Pro (2026) | 1,6T totali / 49B attivi | Licenza MIT, contesto di 1M, 80,6% su SWE-bench Verified |
| Kimi K3 (2026) | 2,8T totali / 104B attivi | 896 esperti, 16 instradati per token, contesto di 1M |
Dal modello preaddestrato all’assistente: instruction tuning e RLHF
Un modello addestrato soltanto a prevedere il token successivo nei testi di internet non è automaticamente un assistente utile: è molto abile a continuare un testo, ma questo non equivale a rispondere alle domande, seguire istruzioni o rifiutare richieste non sicure. Ouyang et al. (2022), in «Training Language Models to Follow Instructions with Human Feedback», hanno introdotto il metodo InstructGPT, che ha colmato questo divario e oggi è alla base della maggior parte dei modelli di chat distribuiti.
Il processo ha tre fasi: il fine-tuning supervisionato su esempi del comportamento desiderato scritti da esseri umani; l’addestramento di un modello di ricompensa su classifiche, stilate da esseri umani, di più risposte del modello allo stesso prompt; e l’uso di quel modello di ricompensa per perfezionare la policy con l’apprendimento per rinforzo (proximal policy optimization).
Il risultato principale del paper è notevole: i valutatori umani hanno preferito le risposte di un modello InstructGPT da 1,3 miliardi di parametri a quelle del modello di base GPT-3 da 175 miliardi di parametri, benché il modello perfezionato con RLHF fosse oltre 100 volte più piccolo. I modelli perfezionati hanno inoltre mostrato miglioramenti misurabili nell’accuratezza delle affermazioni e una riduzione della generazione di contenuti tossici, con solo lievi peggioramenti nei benchmark standard di NLP.
Da allora, l’RLHF (e le sue varianti, compresi approcci privi di un modello di ricompensa come la direct preference optimization) è diventato il collegamento standard tra un modello preaddestrato grezzo e un assistente utilizzabile. È per questo che «dare prompt a un modello di base» e «parlare con ChatGPT o Claude» sono esperienze così diverse, anche quando i pesi preaddestrati sottostanti sono correlati.
Architetture sparse: Mixture of Experts
I transformer densi attivano tutti i parametri per ogni token: il costo dell’inferenza e dell’addestramento cresce quindi direttamente con il numero totale di parametri. Le architetture Mixture-of-Experts (MoE) interrompono questo legame sostituendo un blocco feed-forward denso con un insieme di reti feed-forward specializzate, dette «esperti», e un router appreso che ne attiva solo una parte per ciascun token.
Lo Switch Transformer (Fedus, Zoph e Shazeer, 2021) ha semplificato i precedenti schemi di instradamento MoE assegnando ogni token a un solo esperto (instradamento top-1 anziché top-k). Questo ha ridotto il sovraccarico delle comunicazioni e l’instabilità dell’addestramento, consentendo al tempo stesso di portare i modelli densi basati su T5 a centinaia di miliardi di parametri, fino alla soglia dei mille miliardi. Gli autori hanno riportato una velocità di preaddestramento fino a 7 volte superiore rispetto a modelli densi di riferimento a parità di risorse computazionali.
Mixtral 8x7B (Mistral AI, 2023–2024) ha portato le architetture MoE sparse in un modello a pesi aperti ampiamente utilizzato. Impiega la stessa architettura di base di Mistral 7B, ma ogni livello transformer contiene otto blocchi feed-forward esperti, tra i quali un router seleziona i 2 migliori per ogni token a ogni livello. Il risultato è un modello con circa 47 miliardi di parametri totali, di cui solo circa 13 miliardi sono attivi per un dato token: Mixtral offre così buona parte dei vantaggi qualitativi di un modello denso più grande, con un costo di inferenza più vicino a quello di uno più piccolo.
Addestrato con una finestra di contesto da 32k token, il modello di base, secondo quanto riportato, eguagliava o superava Llama 2 70B e GPT-3.5 nei benchmark valutati, con margini particolarmente ampi in matematica, generazione di codice e compiti multilingue. Sempre secondo quanto riportato, la variante ottimizzata per seguire le istruzioni superava GPT-3.5 Turbo, Claude 2.1, Gemini Pro e Llama 2 70B Chat nei benchmark valutati da esseri umani.
Il confronto tra benchmark è una fotografia del 2023, ma il progetto architetturale gli è sopravvissuto, raggiungendo una scala che Mixtral aveva appena lasciato intravedere. DeepSeek-V4-Pro, rilasciato in anteprima il 24 aprile 2026 con licenza MIT, conta 1,6 mila miliardi di parametri totali e ne attiva 49 miliardi per token, con un contesto da 1 milione di token e un risultato dell’80,6% su SWE-bench Verified; il modello minore della stessa famiglia, V4-Flash, conta 284 miliardi di parametri totali e 13 miliardi attivi. Kimi K3 di Moonshot si spinge ancora oltre: 2,8 mila miliardi di parametri totali, 104 miliardi attivi, 896 esperti di cui 16 selezionati per token. Il rapporto tra parametri totali e attivi di Mixtral era di circa 3,6 a 1; quello di DeepSeek-V4-Pro è di circa 33 a 1 e quello di Kimi K3 di circa 27 a 1.
Le architetture MoE illustrano un principio più generale nella crescita di scala degli LLM: il numero totale di parametri e quello dei parametri attivi, che determinano il carico computazionale, non coincidono più. Le scelte architetturali puntano sempre più direttamente su questa distinzione, anziché trattare la «dimensione del modello» come un unico numero.
Codifica posizionale e contesti lunghi
La codifica posizionale sinusoidale originale è in gran parte assente dagli LLM dell’attuale generazione. I Rotary Position Embeddings (RoPE), introdotti da Su et al. nell’articolo RoFormer (2021), ruotano invece i vettori query e key di un angolo proporzionale alla posizione del token prima del prodotto scalare dell’attenzione. In questo modo, il prodotto scalare tra due posizioni qualsiasi diventa una funzione della loro distanza relativa, anziché delle loro posizioni assolute.
La proprietà relativa alla posizione, insieme al fatto che RoPE non richiede parametri appresi e può essere applicato direttamente all’interno di kernel di attenzione fusi, ne ha fatto lo standard di fatto nella famiglia LLaMA e nella maggior parte dei successivi modelli aperti. RoPE è inoltre alla base delle tecniche che estendono la lunghezza del contesto dopo il preaddestramento riscalando le frequenze di rotazione.
L’estensione del contesto utilizzabile è stata una linea di sviluppo ingegneristico parallela al lavoro sugli obiettivi di modellazione descritto sopra. FlashAttention (Dao et al., 2022) non è una nuova formula per l’attenzione, ma un’implementazione esatta, attenta alle operazioni di input/output, dello stesso calcolo softmax(QKᵀ/√d_k)V: suddividendo il calcolo in blocchi e fondendo le operazioni per evitare di materializzare l’intera matrice di attenzione nella lenta memoria della GPU, riduce la crescita del fabbisogno di memoria da quadratica a lineare rispetto alla lunghezza della sequenza, pur producendo risultati matematicamente identici. È una delle ragioni principali per cui l’addestramento con contesti lunghi è diventato computazionalmente praticabile.
Sul fronte dell’architettura, l’attenzione grouped-query (GQA) riduce il numero di proiezioni key/value distinte condivise tra le teste query. Collocandosi tra l’attenzione multi-head standard e la più spinta attenzione multi-query, riduce le dimensioni della cache key-value che deve essere conservata durante la decodifica autoregressiva: un intervento diretto sul costo dell’inferenza e sulla lunghezza del contesto raggiungibile.
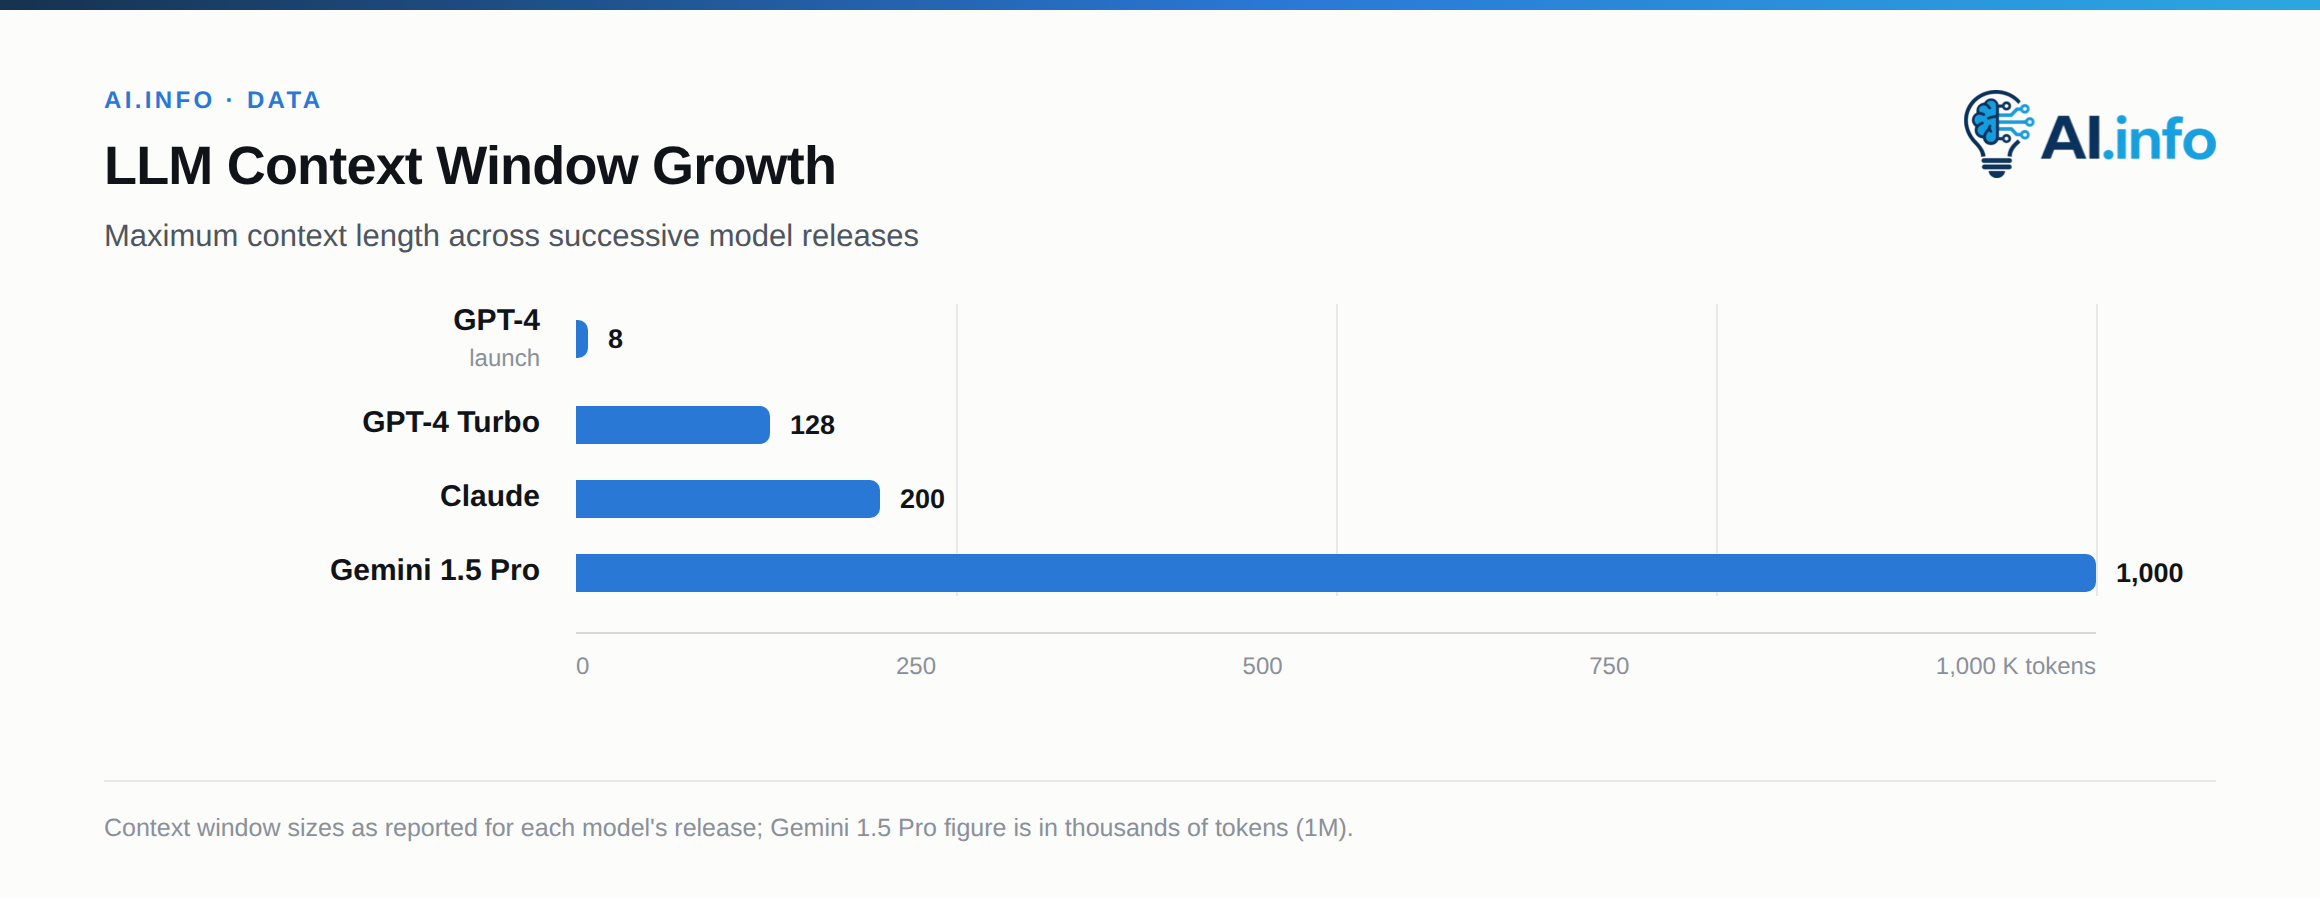
L’effetto combinato di queste tecniche è visibile nei sistemi già distribuiti, e il limite si è spostato due volte. GPT-4 è stato lanciato con un contesto da 8k token e una variante da 32k, mentre GPT-4 Turbo lo ha esteso a 128k token; i modelli Claude sono passati da 9k token a un contesto da 200k token ampiamente utilizzato; e Gemini 1.5 Pro è stato rilasciato nel 2024 con una finestra di contesto da 1 milione di token, allora un record. Entro il 2026, un milione di token era diventato la norma anziché una notizia da prima pagina: con la versione V4 del 24 aprile 2026, DeepSeek ha reso standard una finestra da 1 milione di token in tutti i suoi servizi ufficiali, e Kimi K3 di Moonshot, a pesi aperti, offre la stessa finestra. Nessuno di questi progressi deriva da un nuovo meccanismo di attenzione da solo: sono il risultato congiunto di modifiche alla codifica posizionale, kernel attenti alle operazioni di input/output e varianti dell’attenzione efficienti nell’uso della cache KV.
Dove convergono i fili
Nessuno di questi elementi è sufficiente da solo. Un transformer senza una tokenizzazione in sottoparole di tipo BPE non può gestire in modo efficiente un vocabolario aperto; un modello addestrato esclusivamente a predire il token successivo, senza RLHF, è un sistema che completa testi, non un assistente; senza un’architettura capace di sfruttare risorse di calcolo aggiuntive — il parallelismo dell’attenzione e il calcolo condizionale dei MoE — le leggi di scala descriverebbero soltanto un muro, anziché indicare una strada percorribile.
Il contributo di Kaplan (2020) e Hoffmann (2022) non fu un nuovo elemento, ma una teoria predittiva dei compromessi tra quelli già esistenti — parametri, dati e risorse di calcolo — che trasformò lo sviluppo dei modelli di frontiera da un processo per tentativi ed errori in un’allocazione delle risorse basata su una curva dei costi nota. Il percorso dal transformer di base originale di Vaswani, con 65 milioni di parametri, ai 175 miliardi di parametri di GPT-3, dalla dimostrazione di Chinchilla che un modello da 70 miliardi di parametri addestrato con una quantità adeguata di dati supera un modello da 280 miliardi non sufficientemente addestrato, al progetto sparso di Mixtral, con 47 miliardi di parametri complessivi e 13 miliardi attivi, fino ai modelli sparsi da mille miliardi di parametri del 2026, non è la storia della vittoria di una singola idea. È la storia del meccanismo di attenzione, della tokenizzazione, degli obiettivi di addestramento, dell’RLHF e delle leggi di scala, perfezionati in larga misura indipendentemente e poi ricombinati. È anche per questo che i confronti isolati sui benchmark tra «generazioni» di modelli sono spesso meno istruttivi di un confronto su quali di queste cinque leve siano effettivamente cambiate.