Approfondimenti tecnici
Hardware per l’IA: GPU, TPU e il futuro della capacità di calcolo per l’IA
Una guida ai chip alla base dell’IA nel 2026: la generazione Rubin di NVIDIA e i suoi 288 GB di HBM4, la TPU Ironwood di Google e la prossima divisione della TPU 8 in due versioni, AWS Trainium3 e perché sono la larghezza di banda e le inte
AI.info Team ·
Nell’ultimo decennio, ogni salto nelle capacità dell’IA ha seguito più da vicino un salto nell’hardware di calcolo che un progresso negli algoritmi. I transformer esistevano già in un articolo scientifico nel 2017; sono diventati una categoria di prodotti solo quando le GPU e, in seguito, gli acceleratori dedicati hanno reso abituali, su scala di data center, le moltiplicazioni tra matrici che richiedono migliaia di miliardi di operazioni. Capire l’infrastruttura moderna dell’IA significa conoscere un numero ristretto di famiglie di chip — la linea di GPU NVIDIA, le TPU di Google e un insieme crescente di acceleratori specializzati nell’inferenza — oltre alle interconnessioni e agli accorgimenti nella precisione numerica che consentono a migliaia di chip di funzionare come un’unica macchina.
Perché la moltiplicazione tra matrici guida la progettazione dei chip
L’addestramento e l’inferenza delle reti neurali si riducono, in larghissima parte, a moltiplicazioni tra matrici: il passaggio in avanti attraverso un livello di un transformer consiste in una sequenza di moltiplicazioni tra le attivazioni e le matrici dei pesi, mentre il passaggio all’indietro calcola i gradienti mediante altre operazioni dello stesso tipo. Una CPU general purpose esegue male questo carico di lavoro perché è ottimizzata per le diramazioni e per operazioni scalari a bassa latenza, non per far scorrere milioni di operazioni di moltiplicazione e accumulo lungo percorsi di dati ampi e regolari.
Le GPU avevano già risolto un problema simile per la rasterizzazione grafica, così nel 2017 l’architettura Volta di NVIDIA introdusse i Tensor Core — unità dedicate alla moltiplicazione tra matrici — come aggiunta alla schiera esistente di core CUDA. Google adottò un approccio più radicale con la TPU, costruita fin dall’inizio attorno a una matrice sistolica: una griglia di celle di moltiplicazione e accumulo che trasmettono le somme parziali direttamente alle celle vicine, senza tornare alla memoria tra un passaggio e l’altro.
Entrambi gli approcci convergono sulla stessa intuizione: il collo di bottiglia per i carichi di lavoro dell’IA raramente è la capacità aritmetica pura; è la velocità con cui si possono fornire gli operandi alle unità aritmetiche. Per questo la larghezza di banda della memoria e la velocità delle interconnessioni pesano sulle roadmap dell’hardware tanto quanto i FLOPS.
L’evoluzione delle GPU NVIDIA per i data center
A100 (Ampere, 2020)
L’A100, basata sull’architettura Ampere e presentata nel maggio 2020, è stata l’acceleratore su cui si è appoggiata la prima ondata di addestramento dei transformer su larga scala. Era disponibile in configurazioni da 40 GB e 80 GB con memoria HBM2/HBM2e; la versione da 80 GB raggiungeva circa 2 TB/s di larghezza di banda della memoria. La NVLink di terza generazione offriva fino a 600 GB/s di larghezza di banda tra GPU, mentre i Tensor Core raggiungevano circa 312 TFLOPS in FP16 denso (624 TFLOPS con sparsità strutturata). Introdusse anche Multi-Instance GPU (MIG), che suddivide una GPU fisica in un massimo di sette istanze isolate: una funzione importante per l’economia del cloud quanto per le prestazioni pure.
H100 (Hopper, 2022)
NVIDIA annunciò l’architettura Hopper e l’H100 alla GTC nel marzo 2022; le spedizioni in grandi volumi seguirono nel 2023. H100 passò alla HBM3, offrendo circa 3,35 TB/s di larghezza di banda della memoria nel modulo SXM, e introdusse la NVLink di quarta generazione, con circa 900 GB/s per GPU. La principale novità architetturale fu il supporto nativo di FP8 nei Tensor Core, insieme a un Transformer Engine che gestisce dinamicamente la precisione durante l’addestramento.
Per singola GPU, H100 raggiunge circa 1.980 TFLOPS in FP8 denso (circa 3.960 TFLOPS con sparsità): il doppio delle prestazioni dell’operazione equivalente in BF16. Nel 2023, la domanda di H100 fu così forte che la sua disponibilità divenne il principale collo di bottiglia per quasi tutte le grandi sessioni di addestramento annunciate quell’anno.
H200 (aggiornamento di Hopper, 2024)
H200, la cui disponibilità generale arrivò a metà 2024, mantenne invariata l’architettura di calcolo Hopper e passò invece a 141 GB di HBM3e, portando la larghezza di banda della memoria a circa 4,8 TB/s. È un aggiornamento della sola memoria — le prestazioni dei Tensor Core in FP8 e FP16 restano sostanzialmente uguali a quelle di H100 — ma, per l’inferenza limitata dalla capacità di tenere i pesi in memoria e dalle dimensioni della cache KV, più memoria e più larghezza di banda si traducono direttamente in una maggiore velocità di elaborazione, senza alcun aumento della capacità di calcolo.
Blackwell: B200 e GB200 (2024–2025)
NVIDIA presentò l’architettura Blackwell alla GTC nel marzo 2024. Il modulo GPU di punta B200 si discosta dai progetti a die singolo di Ampere e Hopper: unisce due die, ciascuno delle dimensioni massime consentite dal reticolo litografico, in un unico package tramite un collegamento die-to-die da 10 TB/s, apparendo al software come una sola GPU. B200 dispone di 192 GB di HBM3e e di circa 8 TB/s di larghezza di banda aggregata della memoria: più del doppio rispetto a H100.
La NVLink di quinta generazione porta la larghezza di banda delle interconnessioni per GPU a 1,8 TB/s (18 collegamenti da 100 GB/s ciascuno, contro i 900 GB/s di H100). Blackwell introduce anche il supporto nativo di FP4 e FP6 con i formati «micro-scaling» per blocco (MXFP4/MXFP6/MXFP8) descritti più avanti.
Le prestazioni di B200 in FP4 denso raggiungono circa 9 PFLOPS (18 PFLOPS con sparsità): circa il doppio delle sue prestazioni in FP8. Il superchip Grace Blackwell GB200 abbina due GPU B200 a una CPU Grace tramite un collegamento chip-to-chip NVLink-C2C da 900 GB/s, mentre la configurazione su scala rack GB200 NVL72 collega 72 GPU Blackwell attraverso una rete NVLink Switch, offrendo circa 130 TB/s di larghezza di banda tra tutte le GPU in un singolo rack raffreddato a liquido: di fatto, un unico acceleratore molto grande, per l’addestramento e soprattutto per l’inferenza a bassa latenza.
Blackwell Ultra: B300 (2025)
Blackwell Ultra B300, l’aggiornamento di metà ciclo di NVIDIA, aggiunge circa il 50% di memoria rispetto a B200 — 288 GB di HBM3e — e porta le prestazioni in FP4 denso a circa 15 PFLOPS, con un TDP più alto di 1.400 W per GPU. I rack GB300 NVL72 abbinano 72 GPU B300 a 36 CPU Grace, mantenendo l’attenzione sulle installazioni incentrate sull’inferenza, nelle quali la capacità di memoria necessaria per le cache KV e i pesi dei mixture-of-experts, più che i FLOPS puri, è spesso il vincolo determinante.
Rubin (2026)
Rubin, annunciata al CES nel gennaio 2026, ha preso il posto di Blackwell Ultra al vertice della gamma. NVIDIA ha dichiarato che la piattaforma era in piena produzione al CES e lo ha ribadito al Computex nel giugno 2026. Nello stesso mese CoreWeave ha completato la prima messa in funzione di Vera Rubin NVL72, e i rack sono ora operativi presso Google Cloud, Microsoft Azure e Oracle Cloud Infrastructure.
Una GPU Rubin dispone di fino a 288 GB di HBM4, con una larghezza di banda di 19,2 TB/s secondo le attuali specifiche di NVIDIA: più del doppio della larghezza di banda della memoria di Blackwell. NVIDIA le attribuisce inoltre 50 PFLOPS di capacità di calcolo NVFP4 per l’inferenza, un valore con sparsità (35 PFLOPS senza sparsità). La sesta generazione di NVLink porta la larghezza di banda delle interconnessioni per GPU a 3 TB/s secondo le attuali specifiche di NVIDIA (3,6 TB/s nell’annuncio del gennaio 2026). Il rack Vera Rubin NVL72, con 72 GPU Rubin e 36 CPU Vera, raggiunge una larghezza di banda aggregata per lo scale-up di 216 TB/s (260 TB/s secondo l’annuncio). I confronti su cui NVIDIA pone l’accento sono economici: un costo per generare un token in inferenza ridotto di 10 volte rispetto a Blackwell e un numero di GPU 4 volte inferiore per addestrare un modello a miscela di esperti.
L’evoluzione delle TPU di Google: array sistolici su larga scala
Le Tensor Processing Units di Google hanno seguito un percorso parallelo ma distinto sul piano architetturale, alternando chip «ad alte prestazioni», ottimizzati per l’addestramento su larga scala, e chip «efficienti», ottimizzati per il costo per token nell’inferenza e nell’addestramento su scala intermedia.
Le TPU v4, impiegate a partire dal 2020, disponevano i chip in una topologia a toro 3D e consentivano di realizzare pod di diverse migliaia di chip. Offrivano così a Google una capacità di calcolo complessiva sufficiente ad addestrare i suoi modelli più grandi dell’epoca senza dipendere dalla disponibilità di GPU sul mercato. La TPU v5e, annunciata nel 2023, è esplicitamente il componente della quinta generazione progettato per contenere i costi: ogni chip esegue circa 393 bilioni di operazioni INT8 al secondo, usa una topologia a toro 2D più semplice ed è progettato per pod fino a 256 chip, anziché per cluster delle massime dimensioni possibili.
La TPU v5p, annunciata nel dicembre 2023 come chip della quinta generazione orientato alle prestazioni, offre una capacità di calcolo per chip all’incirca doppia rispetto alla v5e, dispone di 95 GB di HBM per chip con una larghezza di banda di 2.765 GB/s e, nei benchmark di Google, ha addestrato modelli di grandi dimensioni a una velocità 2,8 volte superiore a quella della TPU v4.
Trillium, la TPU di sesta generazione (v6e), è stata annunciata al Google I/O nel maggio 2024 ed è diventata disponibile al pubblico più tardi nello stesso anno. Trillium amplia l’unità di moltiplicazione delle matrici portandola a un array 256x256, più grande di quelli delle generazioni precedenti. Google riferisce prestazioni nell’addestramento superiori di oltre 4 volte e una capacità di elaborazione nell’inferenza fino a 3 volte quella della v5e, un miglioramento del 67% nell’efficienza energetica e il raddoppio della larghezza di banda della HBM e dell’interconnessione tra chip (ICI).
Ironwood, la TPU di settima generazione, è stata presentata in anteprima al Google Cloud Next nell’aprile 2025, ma è diventata disponibile al pubblico solo un anno dopo, il 31 marzo 2026. È la prima TPU di Google esplicitamente orientata all’inferenza su larga scala anziché all’addestramento. Le sue specifiche per chip sono circa 4.614 TFLOPS FP8, 192 GB di HBM3e, 7,37 TB/s di larghezza di banda della memoria e 9,6 Tb/s di larghezza di banda dell’interconnessione tra chip. Un singolo superpod collega 9.216 chip per una capacità di calcolo di 42,5 EFLOPS. Questi valori per chip sono della stessa categoria di quelli della generazione Blackwell di NVIDIA, pur derivando da un’architettura del tutto diversa.
Al Cloud Next 2026, il 22 aprile, Google ha presentato in anteprima un’ottava generazione e, per la prima volta, l’ha divisa in due: TPU 8t, nome in codice Sunfish, un chip per l’addestramento progettato insieme a Broadcom, e TPU 8i, nome in codice Zebrafish, un chip per l’inferenza progettato insieme a MediaTek con un costo unitario inferiore. Google ha dichiarato che entrambi sarebbero diventati disponibili al pubblico più tardi nel 2026. Le specifiche di un superpod Sunfish prevedono 9.600 chip, 2 PB di HBM e 121 EFLOPS di capacità di calcolo FP4.
| Chip | Produttore | Capacità di calcolo senza sparsità | Memoria | Larghezza di banda |
|---|---|---|---|---|
| Ironwood (TPU v7) | ~4.614 TFLOPS FP8 | 192 GB HBM3e | 7,37 TB/s | |
| B200 (Blackwell) | NVIDIA | ~9 PFLOPS FP4 senza sparsità | 192 GB HBM3e | ~8 TB/s |
| Rubin | NVIDIA | ~35 PFLOPS NVFP4 senza sparsità (50 con sparsità, inferenza) | 288 GB HBM4 | 19,2 TB/s |
La corsa alla larghezza di banda della HBM
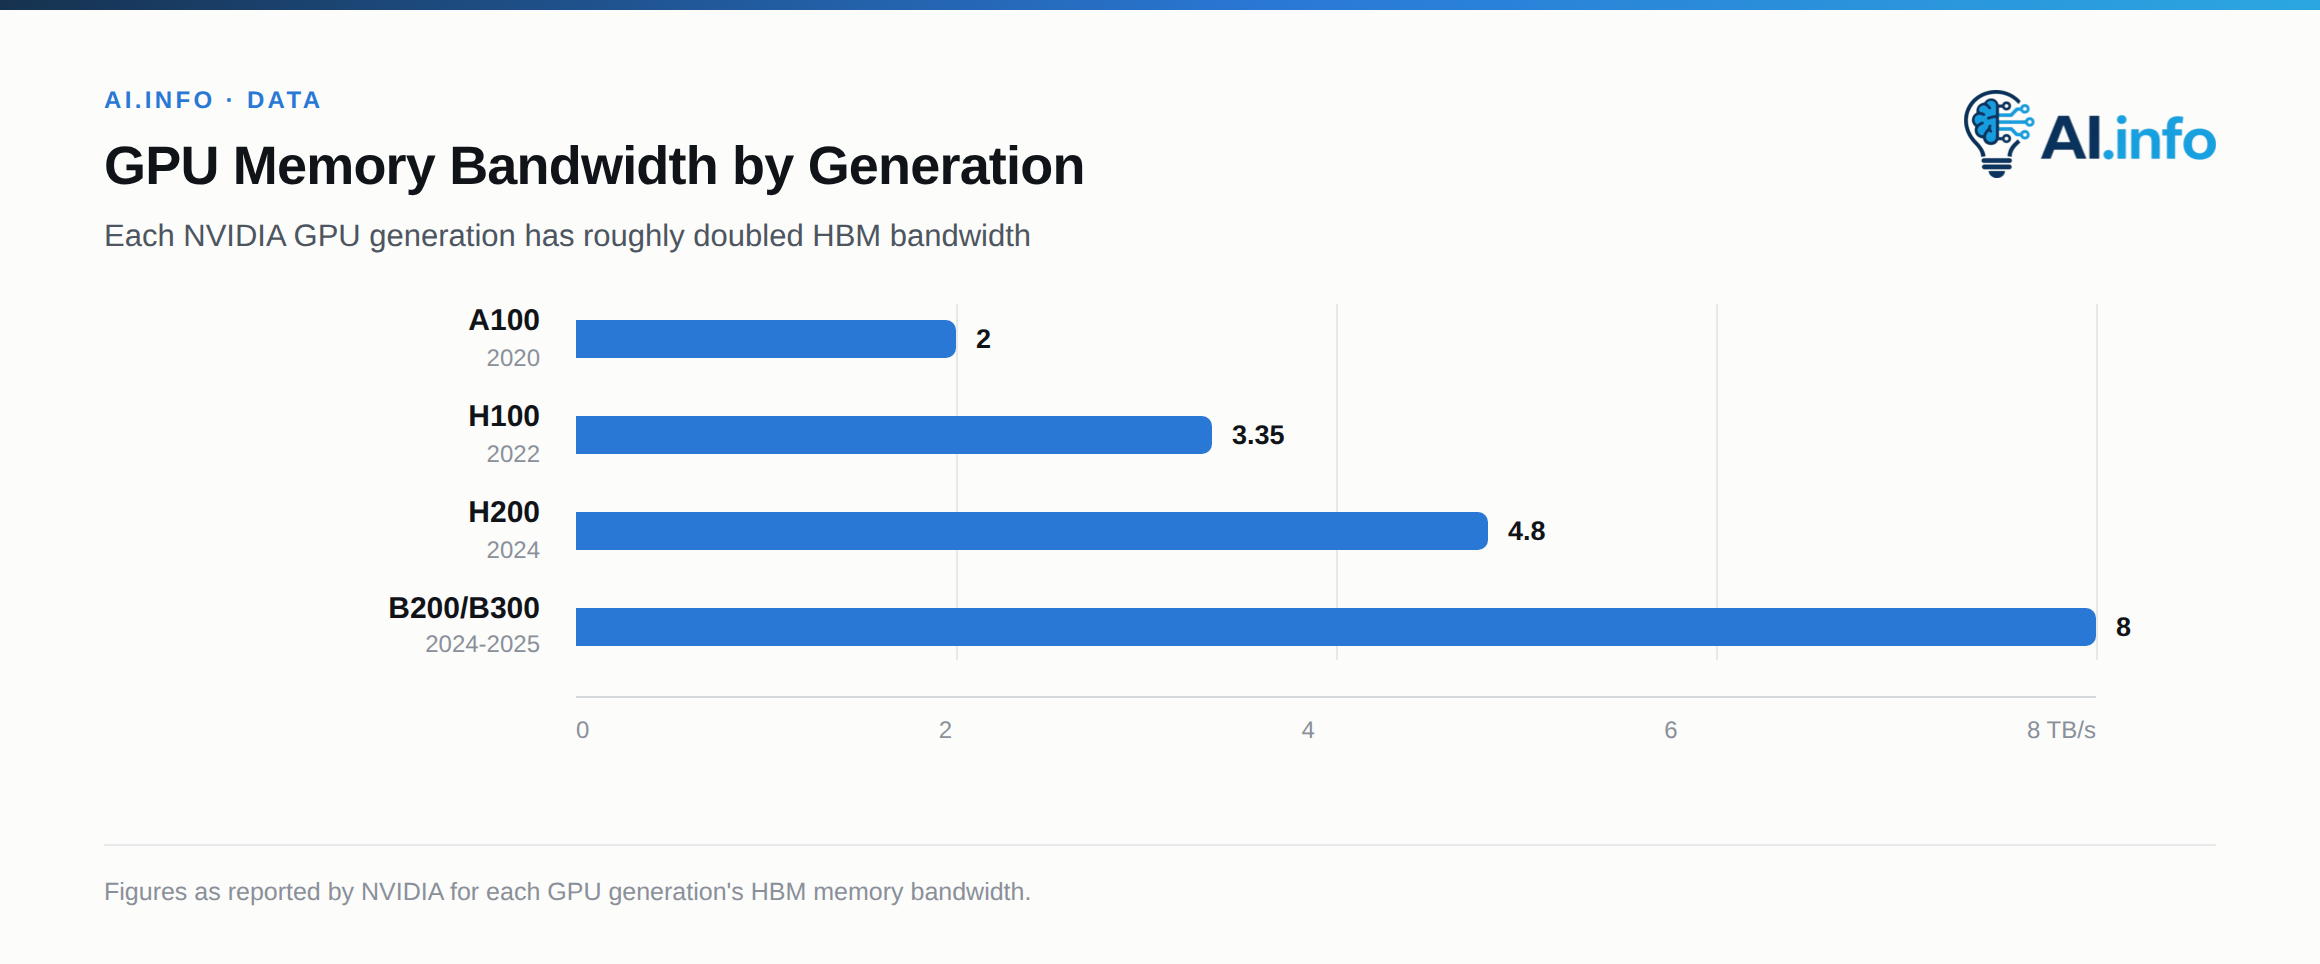
In tutte queste linee evolutive, la larghezza di banda della memoria è generalmente cresciuta più lentamente della capacità di calcolo. È un divario importante perché, nell’inferenza, i meccanismi di attenzione e i modelli con un elevato numero di parametri sono spesso limitati dalla memoria più che dalla capacità di calcolo. La progressione è netta: i circa 2 TB/s di A100, i 3,35 TB/s di H100, i 4,8 TB/s di H200, i circa 8 TB/s di B200/B300 e i 19,2 TB/s di Rubin sfruttano generazioni successive di High Bandwidth Memory (HBM2e, HBM3, HBM3e, HBM4), impilate nello stesso package del die di calcolo tramite interposer in silicio.
Sul fronte delle TPU, i 7,37 TB/s per chip di Ironwood e il raddoppio della larghezza di banda di Trillium rispetto alla v5e mostrano la stessa tendenza. La capacità della HBM è una risorsa contesa quanto la capacità di calcolo: in vari momenti, i vincoli di fornitura presso SK Hynix, Samsung e Micron hanno limitato il numero di acceleratori che NVIDIA e Google potevano consegnare, indipendentemente dalla capacità produttiva delle fabbriche per i die logici.
Interconnessioni: oltre i limiti di un singolo chip
Nessun acceleratore, per quanto potente, addestra da solo un modello di frontiera. NVLink è l’interconnessione proprietaria di NVIDIA tra chip, usata per la comunicazione scale-up all’interno di un nodo o di un rack: NVLink di terza generazione su A100 offriva 600 GB/s, la quarta generazione su H100 ha portato il valore a circa 900 GB/s, la quinta generazione su Blackwell ha raddoppiato la larghezza di banda per GPU, portandola a 1,8 TB/s, e NVLink 6 su Rubin la porta a 3 TB/s secondo le attuali specifiche di NVIDIA (3,6 TB/s nell’annuncio del gennaio 2026).
I chip NVSwitch estendono NVLink in una rete che collega direttamente qualsiasi GPU alle altre all’interno di un rack; nei sistemi GB200/GB300 NVL72 questa rete offre circa 130 TB/s di larghezza di banda aggregata su 72 GPU, e 216 TB/s in Vera Rubin NVL72 secondo le attuali specifiche di NVIDIA (260 TB/s nell’annuncio). Quando un carico di lavoro deve estendersi su più rack o su un intero pod di data center, NVIDIA passa a InfiniBand, tramite la linea di switch Quantum, oppure a reti basate su Ethernet per lo scale-out: si accettano una latenza maggiore e una minore larghezza di banda in cambio della possibilità di collegare decine di migliaia di GPU.
I pod TPU di Google usano una propria interconnessione tra chip (ICI) con una funzione scale-up analoga; gli switch ottici a circuito permettono di riconfigurare la topologia del pod su una scala di migliaia di chip. Scale-up (all’interno di un rack, NVLink/ICI) e scale-out (tra rack, InfiniBand/Ethernet) sono volutamente tecnologie diverse, con compromessi diversi tra larghezza di banda e latenza. Organizzare correttamente questa gerarchia conta, per la velocità effettiva dell’addestramento, più dei FLOPS di picco di un singolo chip.
Precisione: da FP16 a FP8 a FP4
La precisione numerica usata per la moltiplicazione di matrici è diminuita a ogni generazione hardware, sulla base dell’osservazione che le reti neurali tollerano un notevole rumore di quantizzazione, soprattutto durante l’inferenza. I Tensor Core della generazione Ampere lavoravano principalmente in FP16/BF16 e TF32; l’H100 della generazione Hopper ha introdotto il supporto nativo a FP8 nei Tensor Core, insieme a un Transformer Engine che gestisce automaticamente la precisione mista, raddoppiando all’incirca la velocità delle moltiplicazioni di matrici rispetto a BF16 a parità di potenza.
Blackwell si è spinta una generazione oltre, aggiungendo il supporto nativo a FP6 e FP4 con formati di micro-scaling a granularità fine (MXFP8, MXFP6, MXFP4), nei quali un fattore di scala dell’esponente condiviso si applica a blocchi di circa 32 valori anziché a un intero tensore: una modifica che recupera gran parte dell’intervallo dinamico perso scendendo a 4 bit per valore. Sono questi i formati su cui ormai si basano i valori dichiarati: NVIDIA esprime le prestazioni di Rubin in NVFP4 e AWS ha integrato MXFP8 e MXFP4 in Trainium3.
L’effetto si accumula: su Blackwell FP4 offre prestazioni all’incirca doppie rispetto a FP8, che su Hopper era già il doppio di BF16. Una GPU Blackwell che esegue inferenza in FP4 offre quindi una velocità di calcolo grezza dell’ordine di 4 volte quella di un H100 che lavora in FP8, per i carichi di lavoro che tollerano la perdita di precisione: in genere l’inferenza con quantizzazione successiva all’addestramento, più che l’addestramento stesso, per il quale si continua a usare una precisione maggiore per garantire la stabilità numerica.
Chip specializzati per l’inferenza
Anche le GPU e le TPU ottimizzate per l’addestramento eseguono inferenza, ma una categoria distinta di chip sacrifica la flessibilità nell’addestramento per ridurre latenza e costi dell’inferenza. La LPU (Language Processing Unit) di Groq adottava un’architettura deterministica, con operazioni pianificate dal compilatore, costruita attorno a un’enorme larghezza di banda della SRAM integrata nel chip anziché alla HBM esterna. Eliminava così l’imprevedibilità degli accessi alla memoria che provoca oscillazioni della latenza sulle GPU ed eseguiva modelli della classe Llama a centinaia di token al secondo per utente.
L’idea era abbastanza convincente perché NVIDIA scegliesse di assicurarsi quella tecnologia anziché cercare di batterla. Il 24 dicembre 2025 NVIDIA ha accettato di ottenere una licenza non esclusiva per la tecnologia LPU di Groq, lasciando Groq indipendente, in un accordo stimato, secondo quanto riportato, a circa 20 miliardi di dollari, il più grande nella storia di NVIDIA, e assumendo il fondatore di Groq e parte del team. Il risultato è un complemento delle GPU, non un concorrente. Il rack NVIDIA Groq 3 LPX, in piena produzione dall’agosto 2026, contiene 256 acceleratori LPU, ciascuno con 500 MB di SRAM integrata nel chip a 150 TB/s, per un totale di 128 GB di SRAM e 40 PB/s per rack. Affiancato a un Vera Rubin NVL72, si divide il lavoro con questo: le GPU gestiscono il prefill e l’attenzione sulla cache KV, le LPU gli strati feed-forward e mixture-of-experts di ogni nuovo token, sensibili alla latenza. Secondo i dati di NVIDIA, a velocità estreme il sistema arriva a produrre fino a 35 volte più token per watt rispetto al solo Blackwell NVL72.
| Chip | Produttore | Ruolo | Dato principale |
|---|---|---|---|
| Groq 3 LPU | NVIDIA (proprietà intellettuale Groq) | Generazione dei token nell’inferenza | 500 MB di SRAM a 150 TB/s per chip |
| Trainium3 | AWS | Addestramento | 2,52 PFLOPS in FP8, 144 GB di HBM3e, 4,9 TB/s |
| Inferentia2 | AWS | Inferenza | ~190 TFLOPS in FP16, 32 GB di HBM |
AWS ha seguito una strada diversa con i propri chip. Trainium2 è alla base di Project Rainier: il sito di New Carlisle ospitava circa 500.000 chip quando è entrato in funzione nell’ottobre 2025 e, nell’aprile 2026, Anthropic ha dichiarato di usare più di un milione di chip Trainium2 per addestrare Claude ed erogarne il servizio. Entro la fine del 2026 è prevista l’entrata in funzione, nell’infrastruttura AWS, di una capacità combinata Trainium2 e Trainium3 di quasi 1 GW.
Trainium3 è arrivato a re:Invent nel dicembre 2025, quando AWS ha annunciato la disponibilità generale dei Trn3 UltraServers. È il primo chip per l’IA a 3 nm dell’azienda, con prestazioni dichiarate di 2,52 PFLOPS in FP8 per chip, 144 GB di HBM3e a 4,9 TB/s e supporto già disponibile per MXFP8 e MXFP4, non soltanto promesso. Un UltraServer può arrivare a 144 chip per 362 PFLOPS in FP8, fino a 4,4 volte la capacità di calcolo di un Trainium2 UltraServer. Inferentia2, il chip di AWS dedicato all’inferenza, offre circa 190 TFLOPS di prestazioni in FP16 con 32 GB di HBM per acceleratore, a un costo per inferenza sostanzialmente inferiore rispetto a Inferentia di prima generazione, che ha sostituito.
Leggere la roadmap
L’andamento di queste linee di prodotto è abbastanza costante da consentire previsioni: ogni generazione introduce un formato numerico a precisione inferiore, raddoppia all’incirca la larghezza di banda della memoria grazie a uno standard HBM più recente e raddoppia all’incirca la larghezza di banda dell’interconnessione scale-up. La crescita della capacità di calcolo a livello di die, invece, deriva dall’integrazione di più die nello stesso package, non dall’aumento delle dimensioni di un singolo die: i limiti del reticolo litografico impongono un tetto alle dimensioni ottenibili con una sola esposizione.
La generazione del 2026 ha seguito questo schema, aggiungendovi una novità. Rubin, Trainium3 e Ironwood sono arrivati a pochi mesi di distanza l’uno dall’altro, con formati a bassa precisione (NVFP4 su Rubin, MXFP8 e MXFP4 su Trainium3, FP8 su Ironwood), più memoria HBM e interconnessioni più veloci. La novità è la specializzazione per fase: Google ha suddiviso la sua TPU di ottava generazione in un chip per l’addestramento e uno per l’inferenza, NVIDIA ha aggiunto ai suoi rack di GPU un acceleratore per la fase di decode basato su SRAM, e Ironwood è stato progettato fin dall’inizio per il serving. Prefill e decode hanno colli di bottiglia diversi, e il settore non chiede più sempre a un solo die di gestirli entrambi.
Per chi costruisce o acquista infrastrutture di IA, la domanda decisiva è raramente quale chip abbia il maggior numero di FLOPS dichiarati. È piuttosto quale combinazione di larghezza di banda della memoria, topologia delle interconnessioni e precisione supportata risponda meglio al collo di bottiglia effettivo di uno specifico carico di lavoro: addestrare un modello di frontiera e usarlo per fornire inferenze a bassa latenza sollecitano parti quasi del tutto diverse della stessa infrastruttura hardware.